Claude Code × Medical Application
【Claude Code】治療の流れを1枚の図に Part3:結果の検証 — 正解を先に決めた架空の患者データ
1. はじめに — 図が出ることと、人数が正しいことは別
Sankey 図は、データを読み込めばそれらしく描けます。だからこそ、画面に図が出たことと、その人数が正しいことは別 です。
- 同じ治療の書き方が2通りあれば、柱が2本に分かれて、どちらも細く見える
- 患者 ID が重複していれば、同じ人を2回数える
- 2次治療の列を1つずらして読めば、移り変わりがまるごと違う
どれも、図を見ただけでは気づけません。治療の実態をつかむための道具が、自分の数字の確かめをおろそかにしていては意味がありません。
この回では、治療ラインの推移の数字を、4つの段で確かめた方法を紹介します。
- 全体:正解を先に決めた架空の患者データで、人数を突き合わせる
- 崩れ:わざと崩した入力で、読み込みとデータの確かめの振る舞いを見る
- 表記の違い:まとめる候補を、ルールと AI の両方で正解と照らす
- 大きさ:10万行のファイルでの速さを測る
- 145 / 145項目正解のファイルと、ツールの集計が一致した数
- 10 / 10回AI の提案(列の対応・表記の違い)が正解と一致した回数
- 21件わざと崩した入力で、データの確かめが出した注意点
- 約0.9秒10万行のファイルの読み込みと点検
2. 全体 — 正解を先に決めた架空の患者データ
2-1. なぜ架空のデータを自分で作るか
実在の処方データは、公開のツールには入れられません。公開されているデータを使っても、「どの患者が何人で、どこからどこへ移ったか」の正解は、誰かが後から数えることになります。結果を見てから「だいたい合っている」と判断する余地が残ります。
そこで、正解を先に決めてから、データを作る 形にしました。
2-2. 架空の関節リウマチの患者データ
ツールに最初から入っている架空のデータは、関節リウマチの患者 3,000人分です。
| 項目 | 中身 |
|---|---|
| 人数・列 | 3,000人、34列、ライン5まで |
| 列の形 | 解析用のリスティングの形(群の名前 tx_groupname_1〜5、開始日・終了日、個別のレジメン名、並び順のコード、施設・性別・年齢・検査値など) |
| 治療の群 | MTX 単剤、csDMARD の併用、TNF 阻害薬+MTX、TNF 阻害薬以外の生物学的製剤、JAK 阻害薬、その他(薬は一般名と薬効分類だけ) |
| 仕込んだ表記の違い | 施設B の tnfi+mtx(大文字小文字)、施設C の JAKi(全角) |
| 作り方 | 乱数の種を固定したプログラム。何度作っても同じデータになる |
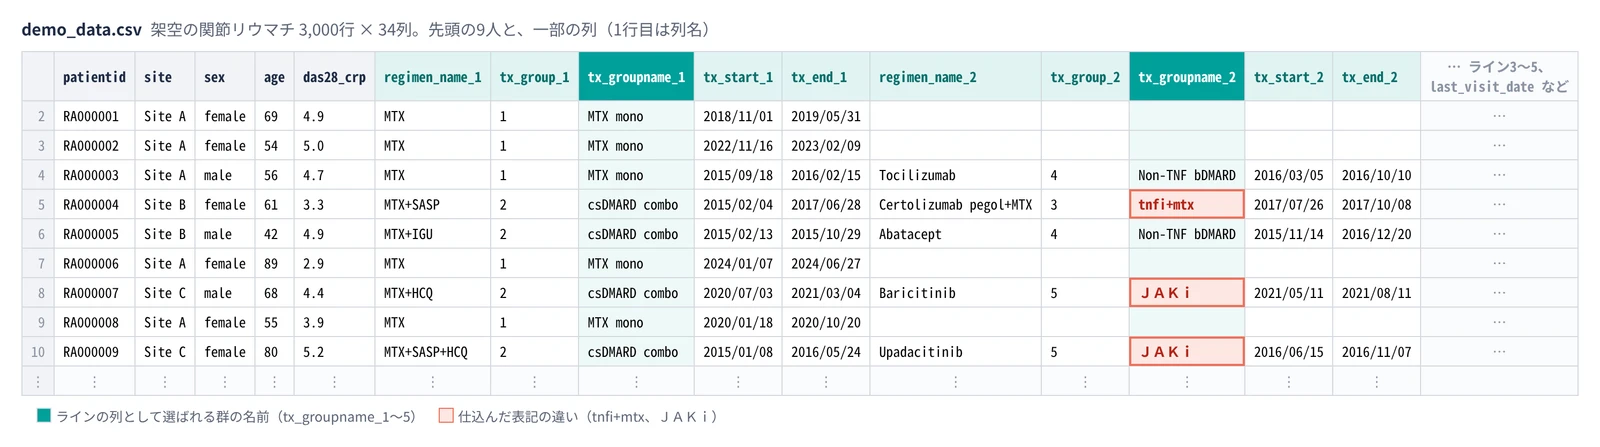
1人の患者の記録は、たとえば次のようになります。
2-3. 正解を同時に書き出す
データを作るプログラムは、作ると同時に正解のファイル(JSON)を書き出します。
- ラインごとの、治療ごとの人数
- あるラインのある治療から、次のラインのどの治療へ何人移ったか
- 仕込んだ表記の違いの組と、それぞれの件数
ツールで架空のデータを読み込み、表記の違いをまとめたあとの集計を、この正解と1項目ずつ突き合わせます。
2-4. 結果
| 突き合わせたもの | 項目の数 | 一致 |
|---|---|---|
| ラインごとの人数 | 32 | すべて |
| 次のラインへの移り変わりの人数 | 111 | すべて |
表記の違いの件数(tnfi+mtx 348件、JAKi 131件) |
2 | すべて |
| 合計 | 145 | 145 |
この突き合わせはテストとして書いてあり、ツールに手を入れるたびに自動で回ります。画面を作り直したときも、点検の決まりを直したときも、集計の数字が変わっていないことをそのつど確かめられました。
3. 崩れ — わざと崩した入力
3-1. 崩し方を決めておく
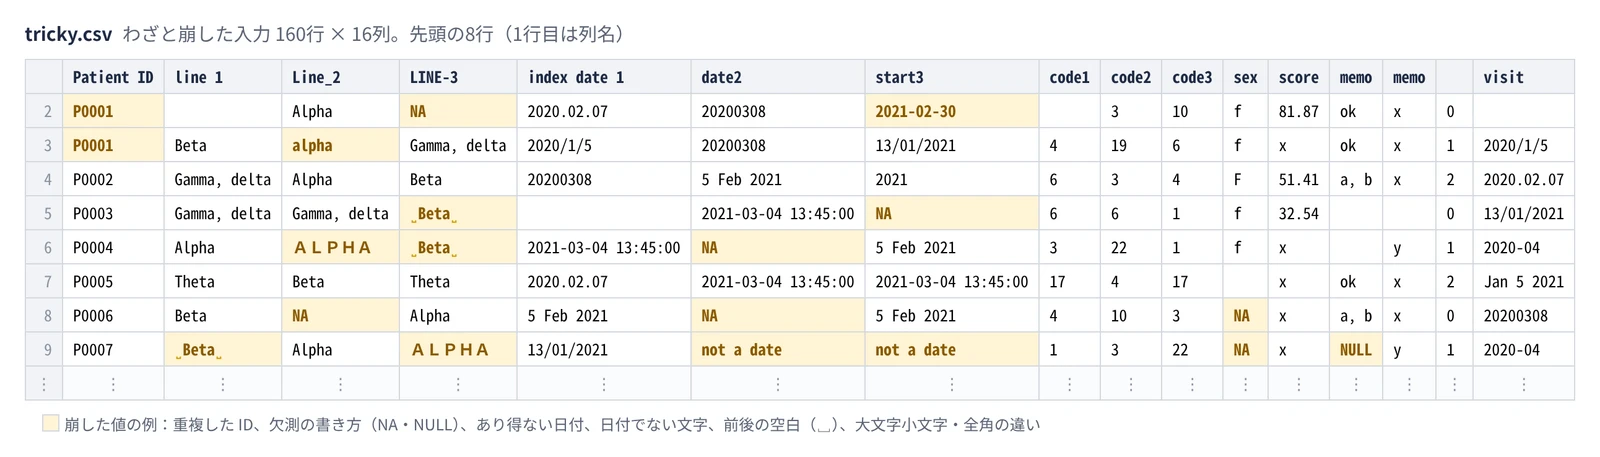
実際のファイルには、きれいでないところがあります。そこで、架空のデータとは別に、わざと崩した小さな入力(160行・16列)を作りました。崩しているのは次の8点です。
| 崩し方 | 例 |
|---|---|
| 列名の形 | 大文字小文字・区切り(line 1、Line_2、LINE-3)がばらばら |
| 欠測と値の書き方 | 空欄、NA、null などが混ざる。前後に空白の入った値(" Beta ")もある |
| 引用符 | 引用符の中に区切りの文字や改行がある |
| 日付の書式 | 2020-01-05、2020/1/5、20200105 などが混ざる |
| ID | 指数表記(1.05E+17)と、重複した ID |
| ラインの飛び | 1次治療が空欄なのに2次治療に値がある |
| 途中の空行 | データの途中に空の行がある |
| 改行の形 | Windows の改行(CRLF) |
3-2. 結果
- 列の対応:列名の形が崩れていても、名前で当たりました
- データの確かめ:21件の注意点を出しました
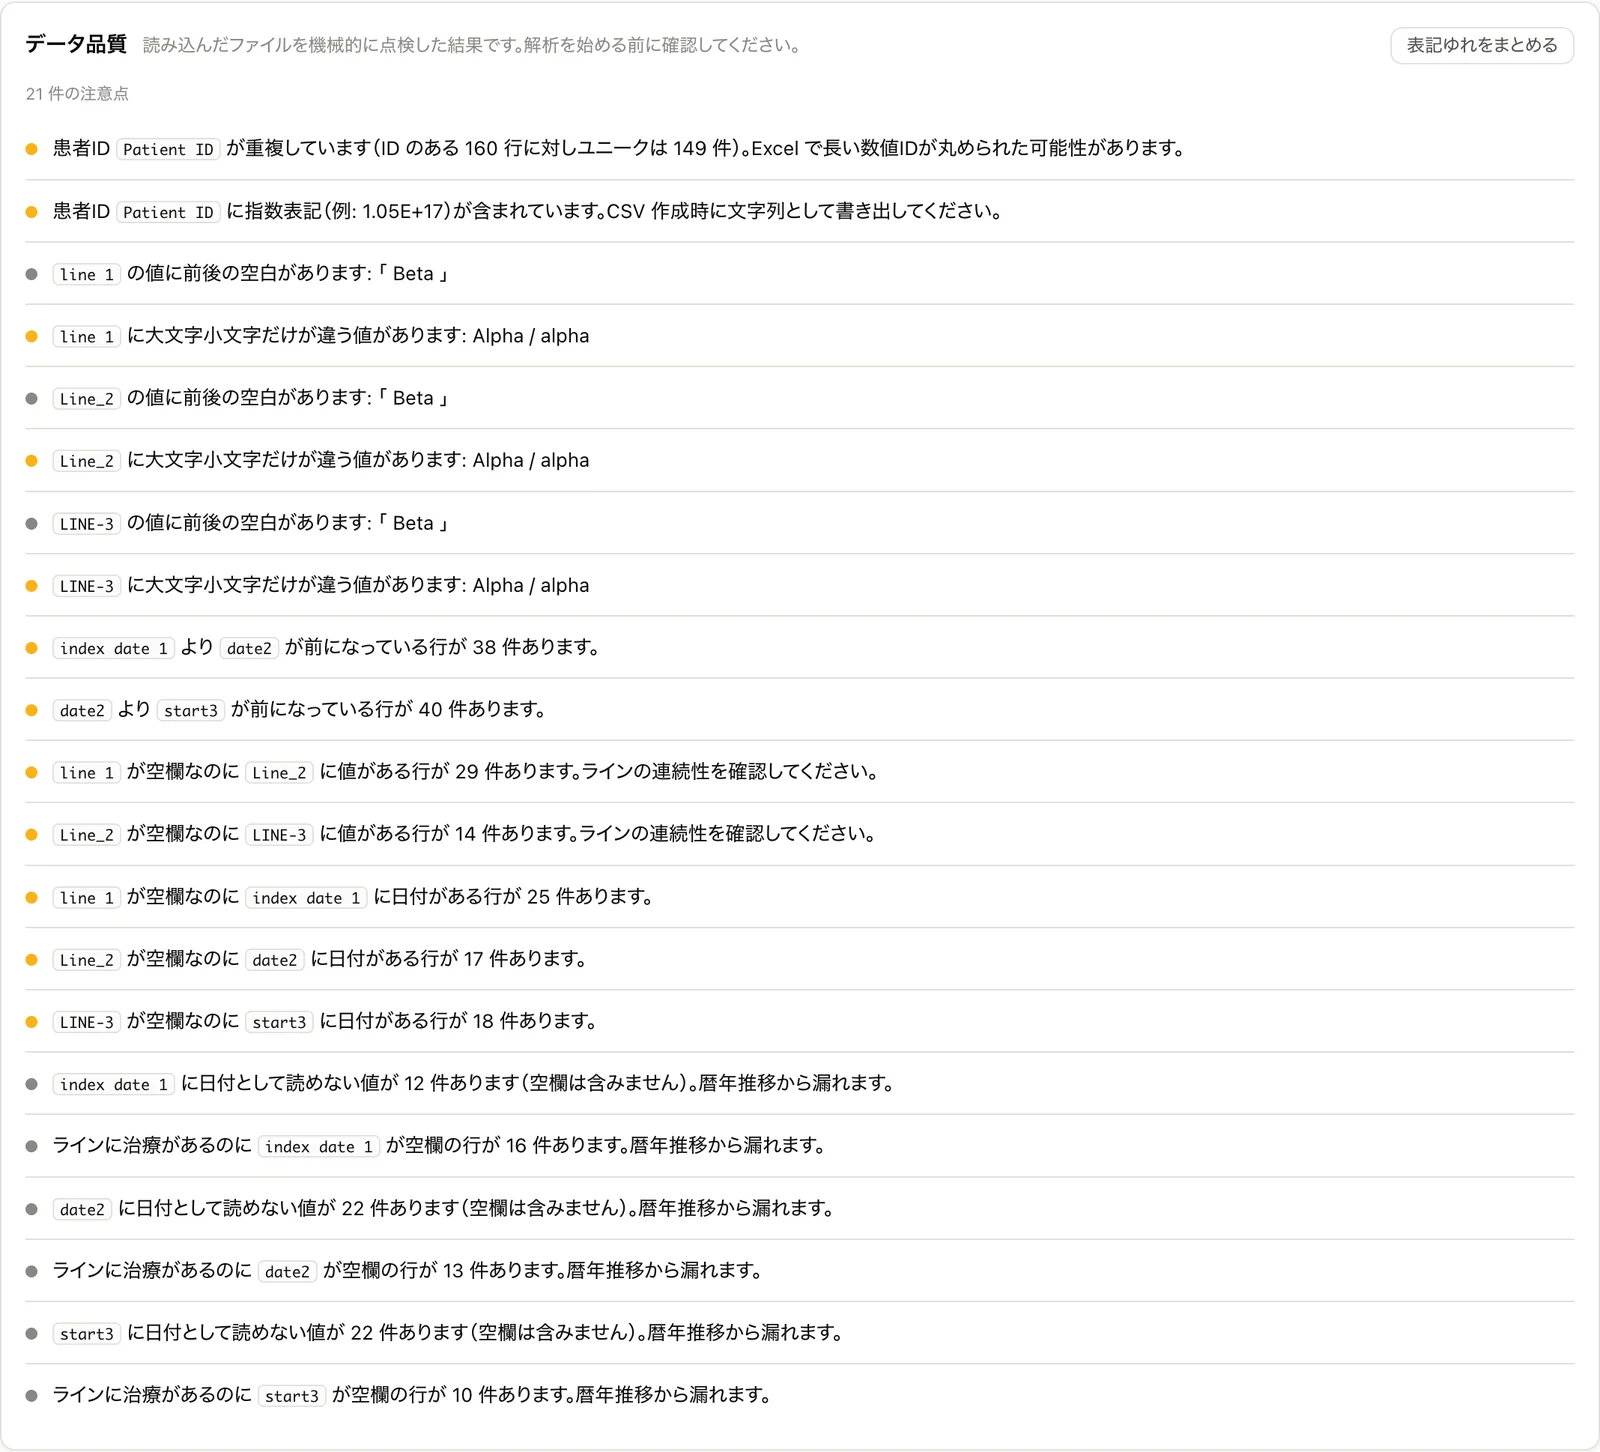
| 注意点 | 件数 | 中身 |
|---|---|---|
| 患者 ID の重複 | 1 | ID のある 160 行に対して、ID は 149 種類 |
| 指数表記の ID | 1 | 1.05E+17 のような ID がある |
| 前後の空白 | 3 | ライン1〜3の列に " Beta " がある(画面では「」で囲んで空白を見せる) |
| 大文字小文字だけの違い | 3 | ライン1〜3の列に Alpha と alpha |
| 日付の前後 | 2 | 2次治療の開始日が1次治療より前の行が 38 件、3次治療が2次治療より前の行が 40 件 |
| ラインの歯抜け | 2 | 1次治療が空欄なのに2次治療に値がある行が 29 件、2次が空欄で3次に値がある行が 14 件 |
| ラインの無い日付 | 3 | 治療の名前が空なのに開始日だけが入っている行が、ライン1〜3で 25・17・18 件 |
| 日付として読めない値 | 3 | 書いてあるのに日付として読めない値が、ライン1〜3の開始日で 12・22・22 件(空欄は含まない) |
| 日付の空欄 | 3 | ラインに治療があるのに開始日が空欄の行が、ライン1〜3で 16・13・10 件 |
崩した入力でも、黙って図にしない ことを確かめました。図は描きますが、データ品質のタブに注意点が並び、何が起きているかが分かります。
3-3. 点検そのものも点検する
この表は、最初は15件でした。公開の前の見直しで、点検の決まりに3つの食い違いが見つかったからです。
- 前後の空白:空白を除いたあとの値で調べていたので、この注意は決して出なかった。読み込んだままの値で調べるように直した
- 日付として読めない値:空欄まで「読めない」に数えていた。書いてあるのに読めないものだけを数え、空欄は「日付の空欄」として別に出すようにした
- 患者 ID の重複:空欄の ID も含めて数えていた。値のある ID だけで重複を調べ、空欄は別に知らせるようにした
点検の正解は、ツールの集計のコードを使わずに、入力ファイルから別のプログラムで数え直して作りました。ツールのコードで正解を作ると、同じ誤りを正解にしてしまうからです。
4. 表記の違い — ルールと AI を正解と照らす
4-1. 表記の違いは、人数を変える
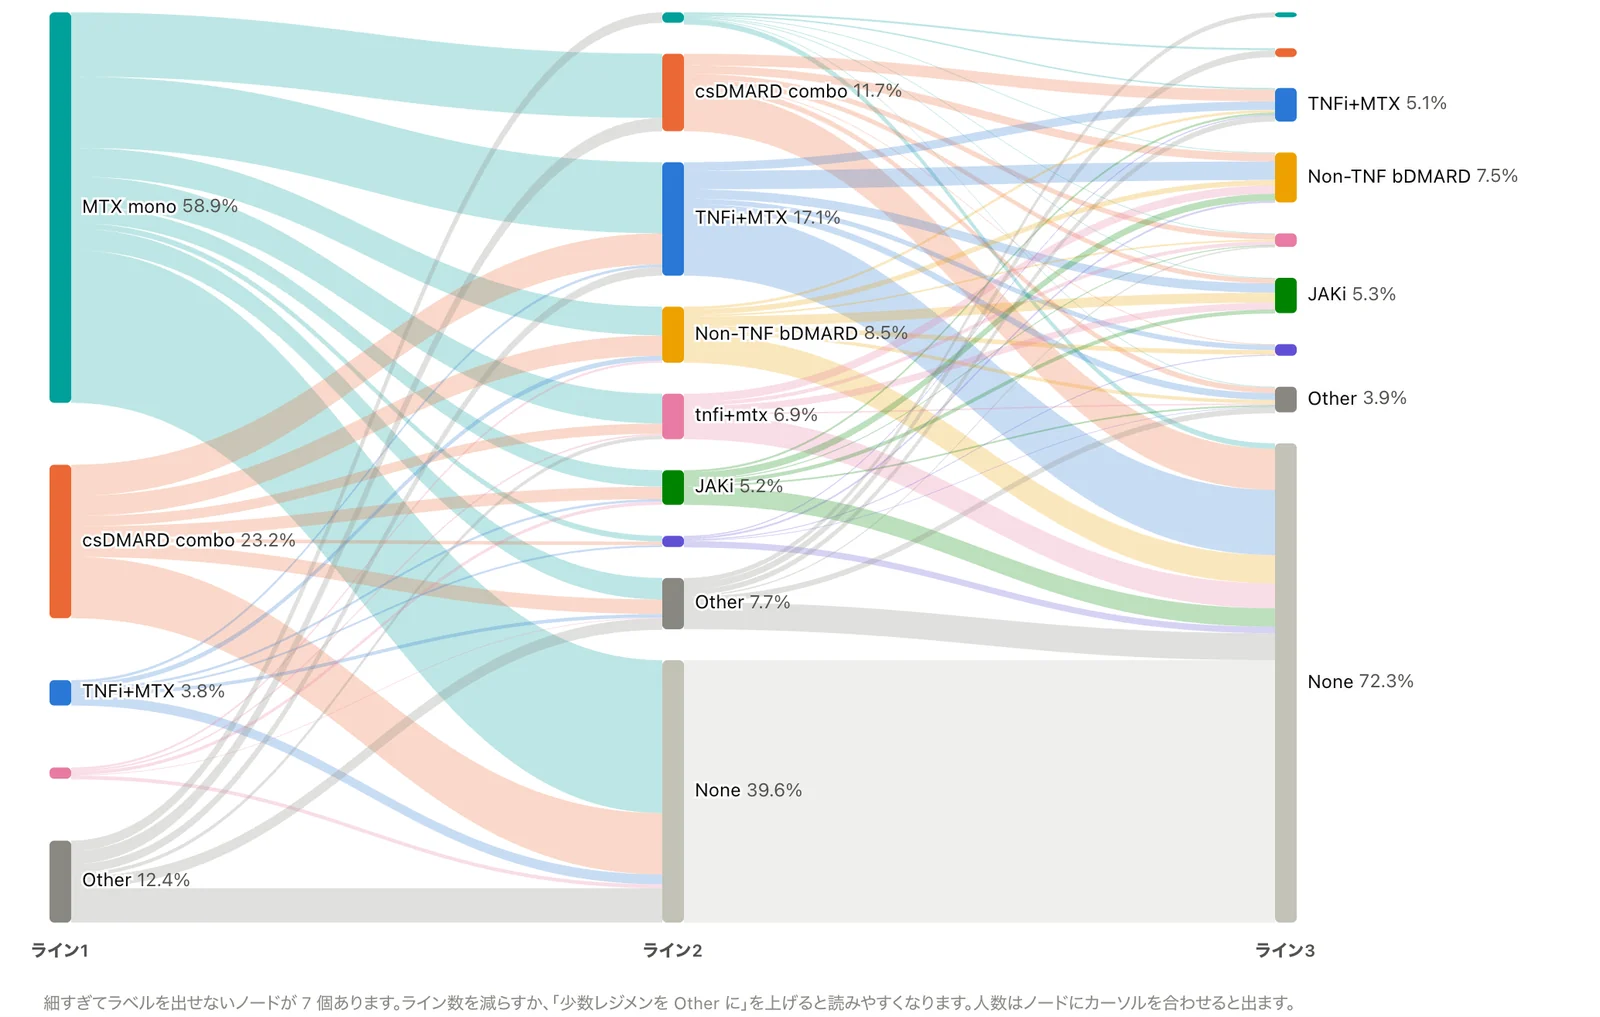
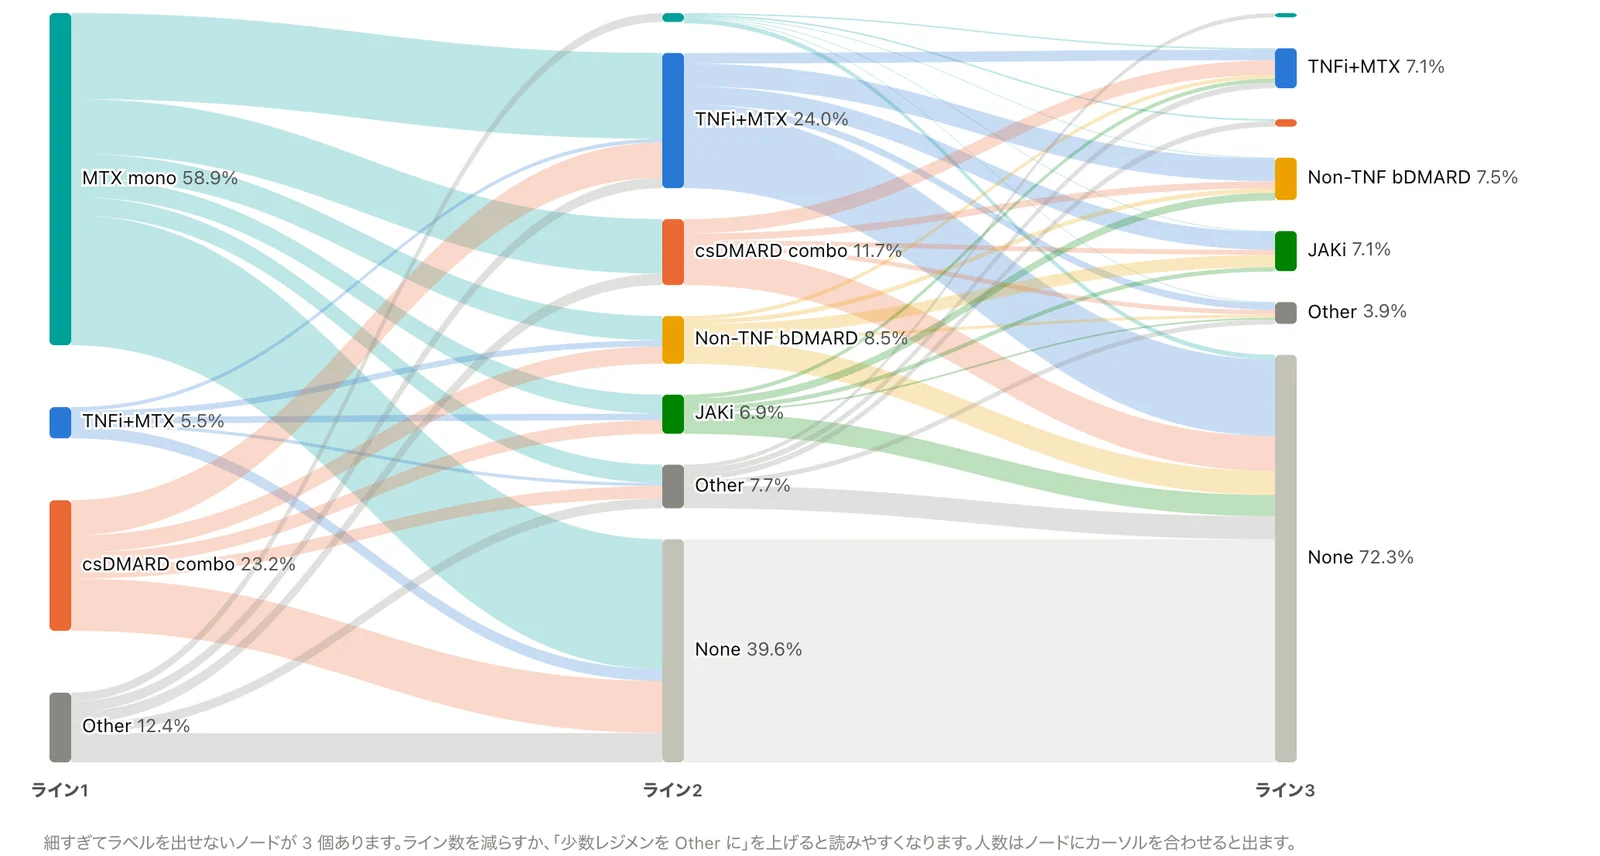
架空のデータには、施設ごとの書き方の違いを2組仕込んであります。まとめる前の図では、同じ治療が別の柱に分かれます。
4-2. ルールの候補
ツールは、次の手順で名前をそろえてみて、同じ形になる名前どうしをまとめる候補として出します。
- 全角・半角をそろえる
- 小文字にする
- 区切りの記号(
++//・)で薬ごとに分ける - 薬ごとに空白を除く
- 薬を並べ替えてつなぐ(「MTX+TNFi」と「TNFi+MTX」を同じにする)
残す名前は、件数の最も多い書き方にします。
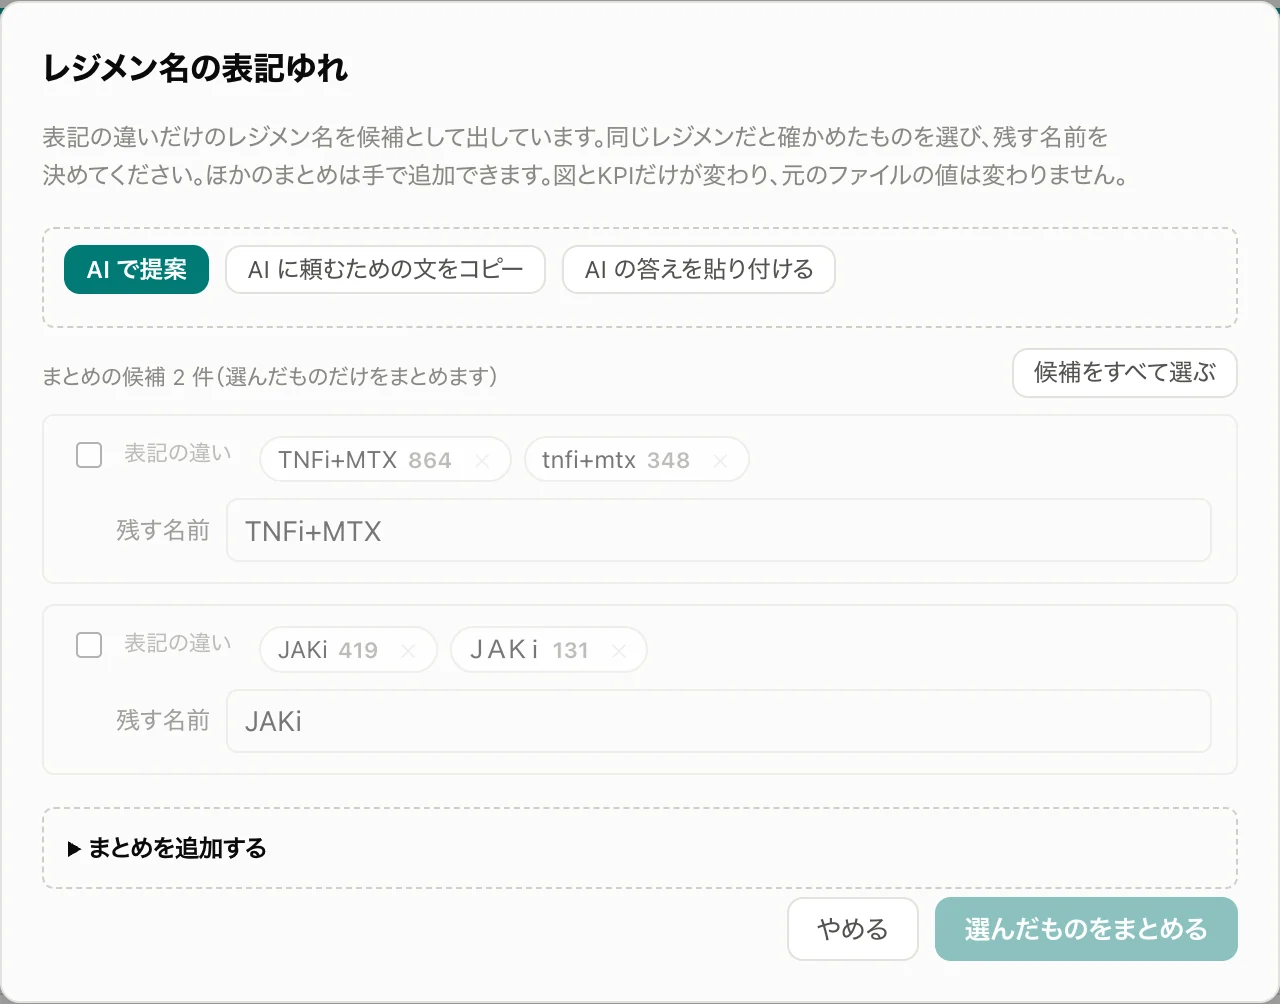
架空のデータでは、仕込んだ2組と完全に一致する 候補が出ました。余計な組は出ていません。
ただし、このルールで拾えるのは、書き方の「形」の違いだけです。ハイフンの有無、略称と正式名(「MTX」と「メトトレキサート」)、日本語と英語、書き誤りは拾いません。
4-3. AI の候補
ルールで拾えない違いのために、AI にもまとめる候補を頼めます。AI に渡すのは、レジメンの名前と件数だけ です(公開版では架空のデータのときだけ。詳しくは Part4(近日公開))。
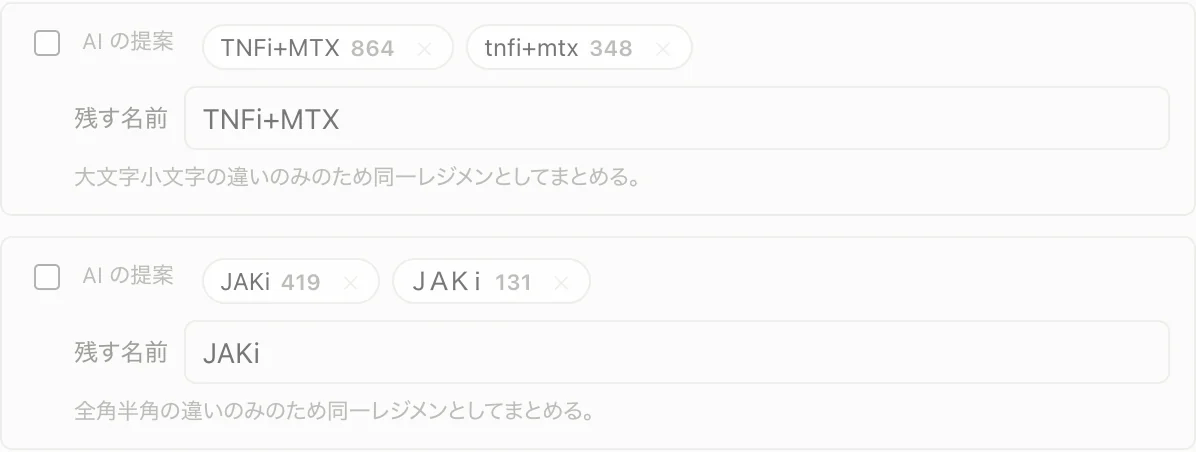
AI の答えは毎回同じとは限りません。そこで、列の対応と表記の違いのそれぞれについて、架空のデータで AI を5回ずつ呼び、正解と照らしました(答えの使い回しはせず、毎回呼んでいます)。
| 依頼 | 回数 | 正解と一致 | 1回の時間 | 1回の費用 |
|---|---|---|---|---|
| 列の対応(ライン・開始日・患者 ID) | 5 | 5 | 3.4〜4.2 秒 | 約0.1円 |
| 表記の違いのまとめ | 5 | 5 | 1.1〜1.4 秒 | 約0.03円 |
10回とも正解でした。列の対応はライン・開始日・患者 ID のすべてを当て、表記の違いは仕込んだ2組だけを返し、余計な組は返しませんでした。
4-4. まとめたあと
候補を選んでまとめると、柱が1本になり、正解の人数と一致します(2章の突き合わせは、この状態で行っています)。まとめは図と数字にだけ効き、読み込んだファイルの値は変えません。「まとめを解除する」で元に戻せます。
5. 大きさ — 10万行での速さ
実際のデータは、3,000人よりずっと大きいことがあります。そこで、架空のデータの行を繰り返して新しい患者 ID を振り、10万行(14.7MB) のファイルを作って測りました。
| 処理 | 時間(5回) |
|---|---|
| 読み込みと点検 | 912〜950 ミリ秒 |
| 集計(既定の設定) | 52〜67 ミリ秒 |
| 集計(ライン5まで) | 83〜98 ミリ秒 |
集計は、絞り込みや設定を変えるたびに走る処理です。50 ミリ秒前後なら、クリックしてすぐに図が変わります。
6. Claude Code に任せたことと、人が決めたこと
| 任せたこと | 人が決めたこと |
|---|---|
| 架空のデータと正解のファイルを作るプログラム | 疾患(関節リウマチ)、治療の群、ライン5まで、という形 |
| 正解と集計の突き合わせのテスト | 正解をデータより先に決めること |
| わざと崩した入力を作り、振る舞いを確かめるテスト | 崩し方の8点、とくに Excel で丸められた ID を入れること |
| 点検の見直しと、別のプログラムで数え直した点検の正解 | 空欄と「読めない値」を分けるなど、注意の出し方の決まり |
| ルールの候補の実装 | 拾う違い(形の違いだけ)と拾わない違いの線引き |
| AI を5回ずつ呼んで正解と照らす試行 | AI の答えを候補にとどめること |
| 10万行での速さの測定 | どれくらいの大きさを想定するか |
突き合わせやテストは、一度書けば何度でも回せます。画面を作り直したり、AI の機能を足したり、点検の決まりを直したりしても、集計の数字が変わっていないことをそのつど確かめられました。
7. まとめ
- 画面に図が出ることと、人数が正しいことは別。全体・崩れ・表記の違い・大きさの4つの段で確かめた
- 全体:正解を先に決めた架空の関節リウマチのデータ(3,000人)で、145項目すべてが正解と一致した
- 崩れ:わざと崩した入力(160行)で、列の対応は名前で当たり、21件の注意点を出した。点検そのものの食い違いも見つけて直した
- 表記の違い:ルールの候補は仕込んだ2組だけを出し、AI は10回とも正解だった。それでも確定は人がする
- 大きさ:10万行のファイルを約0.9秒で読み込み、集計は50ミリ秒前後
- 正解を先に決めること、崩し方を決めること、AI を候補にとどめることは、人が決めた
正解を先に用意しておけば、「だいたい合っている」で止まらずに済みます。そして、正解を自分で作ったことの限界も、忘れずに書いておきます。
次のステップ
Part4 では、AI の組み込みを扱います。AI に何を渡し、何を渡さないか、公開版で架空のデータに限る仕組みをどう作ったか、お手元のファイルでは AI に何も送っていないことをどう確かめるかを紹介します。
出典
- 本ページの画面写真と数値は、架空の関節リウマチのデータ(3,000人)と、わざと崩した入力で作成したものです。実在の患者・施設・薬剤・企業とは関係ありません