Claude Code × Medical Application
【Claude Code】治療の流れを1枚の図に Part1:取り込み — 解析用のリスティングをそのまま読む
1. はじめに — データは、ツールに合わせた形では届かない
治療ラインの推移を図にする道具の多くは、「1次治療の列はこの名前で、2次治療の列はこの名前で」と、決まった形のファイルを求めます。ところが、実際に手元に届くのは、解析のために作られたデータです。
- ラインごとに、群の名前・個別のレジメン名・開始日・終了日の列が連番で並んでいる
- 列の名前は会社や担当者ごとに違う
- Shift_JIS で書き出された CSV、Excel のファイル、区切りがセミコロンのファイルも混ざる
- Excel を一度通ったせいで、長い患者 ID が丸められていることもある
ツールの形に合わせてデータを作り直すたびに、手間と間違いのもとが増えます。そこで治療ラインの推移は、届いた形のまま読み、どの列が何かは中身から推定して、確定は人に任せる ことにしました。
この回では、その取り込みの仕組みを順に見ていきます。
- Claude Code に任せる前に書いたもの
- 連番の列を「中身」から読み解く
- 列の対応 — 推定は候補、確定は人
- 文字コードと区切りの違いを吸収する
- Excel をブラウザの中で読む
- 読み込んだ時点でデータの崩れを知らせる
- この仕組みで読めないもの
- 34列連載で使う架空のデータの列の数(3,000人、ライン5まで)
- 5系統架空のデータの中で見つかる、連番になっている列のまとまり
- 3種自動で判定する文字コード(UTF-8・Shift_JIS・UTF-16)
- 0件読み込む間の、サイトの外への通信
2. Claude Code に任せる前に書いたもの
2-1. 指示書
実装は Claude Code に頼みましたが、始める前に、何を作って何を守るかを指示書に書きました。取り込みに関わる部分は次のとおりです。
| 項目 | 書いたこと |
|---|---|
| 目的 | 解析用のリスティングを、手を加えずに読み込んで図にする |
| 入力の形 | CSV と Excel(.xlsx)。列の名前は決めない。ラインごとの列が連番で並ぶ形を想定する |
| 守ること | 読み込んだファイルをどこにも送らない。部品は必要最小限にし、通信しないものだけを使う。実在の薬剤の製品名・会社名を使わない |
| 確かめ方 | 正解を先に決めた架空のデータと、わざと崩した入力を用意し、どちらも読めることを確かめる |
| 止まる場所 | 段階ごとに報告を書いて止まる。人が判断してから次に進む |
2-2. 人が決めたこと
いちばん大事だったのは、推定は候補にとどめ、確定は人がする と決めたことです。
列の名前が会社ごとに違う以上、どんな規則でも外れることはあります。外れた推定がそのまま図になれば、誰も気づかないまま違う数字が独り歩きします。推定の結果は必ず画面に出し、何を根拠に選んだかも見せ、人が確かめてから図にする。この順番を最初に決めました。
もう1つは、架空のデータをわざと「きれいでない形」にする ことです。ツールに最初から入っている架空のデータは、列の名前を tx_groupname_1 のような解析用の形にし、個別のレジメン名や並び順のコード、施設や検査値の列も入れた 34 列にしました。きれいな形のデータで動いても、実際のファイルで動くとは限らないからです。
3. 連番の列を「中身」から読み解く
3-1. まず「系統」に分ける
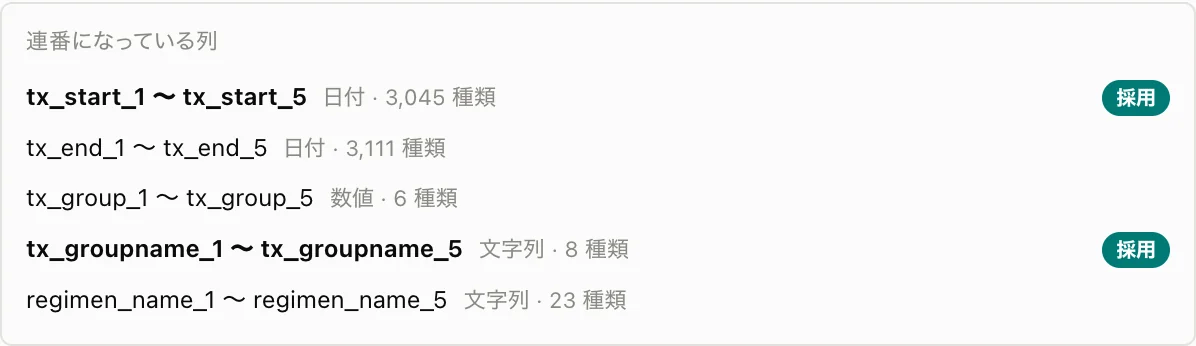
列の名前は会社ごとに違いますが、解析用のリスティングには共通点があります。同じ語幹に 1, 2, 3 … と番号が付いた列のまとまり があることです。ツールではこれを「系統」と呼んでいます。
tx_groupname_1〜tx_groupname_5tx_start_1〜tx_start_5regimen_name_1〜regimen_name_5
列の名前の末尾の番号で系統に分け、番号が 1 から途切れずに並ぶものだけを候補にします。
3-2. 系統ごとに、型と値の種類を数える
次に、系統ごとに中身を見ます。
- 型:値の 9 割以上が日付として読めれば「日付」、数値として読めれば「数値」、それ以外は「文字列」
- 値の種類の数:その系統に何種類の値が入っているか
3-3. 2つの規則で選ぶ
系統に分けて型をそろえると、残る候補はわずかになり、2つの単純な規則で選べます。
| 選ぶもの | 規則 | 理由 |
|---|---|---|
| ライン(レジメン)の列 | 文字列の系統のうち、値の種類が最も少ない もの | 種類が多すぎると図の柱が増えて読めない。群の名前(8種類)と個別のレジメン名(23種類)があれば、群の名前のほうが図に向く |
| 開始日の列 | 日付の系統のうち、行ごとに見て最も早い日付が入っている もの | 開始日と終了日は同じ日付の型。行ごとに比べて、いつも早いほうが開始日 |
どちらの規則も、列の名前ではなく中身を見ています。名前が line_1 でも tx_groupname_1 でも 治療群1 でも、同じように選べます。
4. 列の対応 — 推定は候補、確定は人
推定の結果は、列の対応 の画面に入った状態で開きます。いきなり図にはしません。
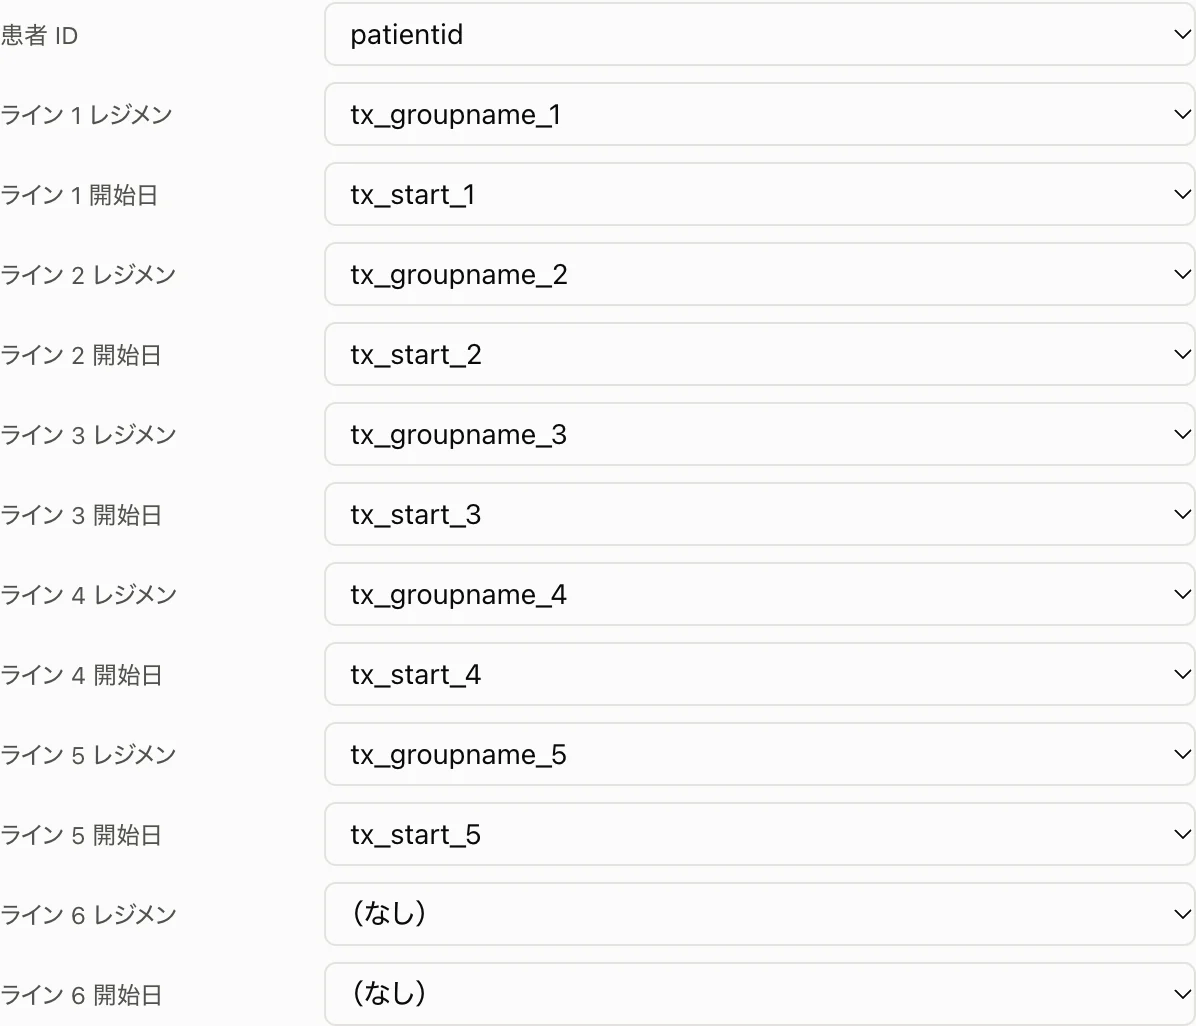
- どの系統を候補にして、どれを選んだかが一覧で見える
- 違っていれば、ラインごとに選び直せる
- 「適用する」を押すまで、図は描かない
推定が当たっていても外れていても、人が一度見てから図にする。この一手間で、間違った対応のまま図が独り歩きするのを防ぎます。
列の対応の提案は AI にも頼めます(公開版では架空のデータのときだけ)。AI に何を渡し、どう確かめているかは Part4(近日公開)で扱います。
5. 文字コードと区切りの違いを吸収する
5-1. 文字コードを順に試す
日本で作られた CSV は、UTF-8 とは限りません。古い仕組みから書き出したものは Shift_JIS(CP932)のことがよくあり、UTF-16 のものもあります。
ツールは、次の順に「この文字コードとして、すべてのバイトが正しく読めるか」を試します。
- UTF-8(先頭に印(BOM)があってもなくても)
- Shift_JIS(CP932)
- UTF-16(BOM が無くても読める)
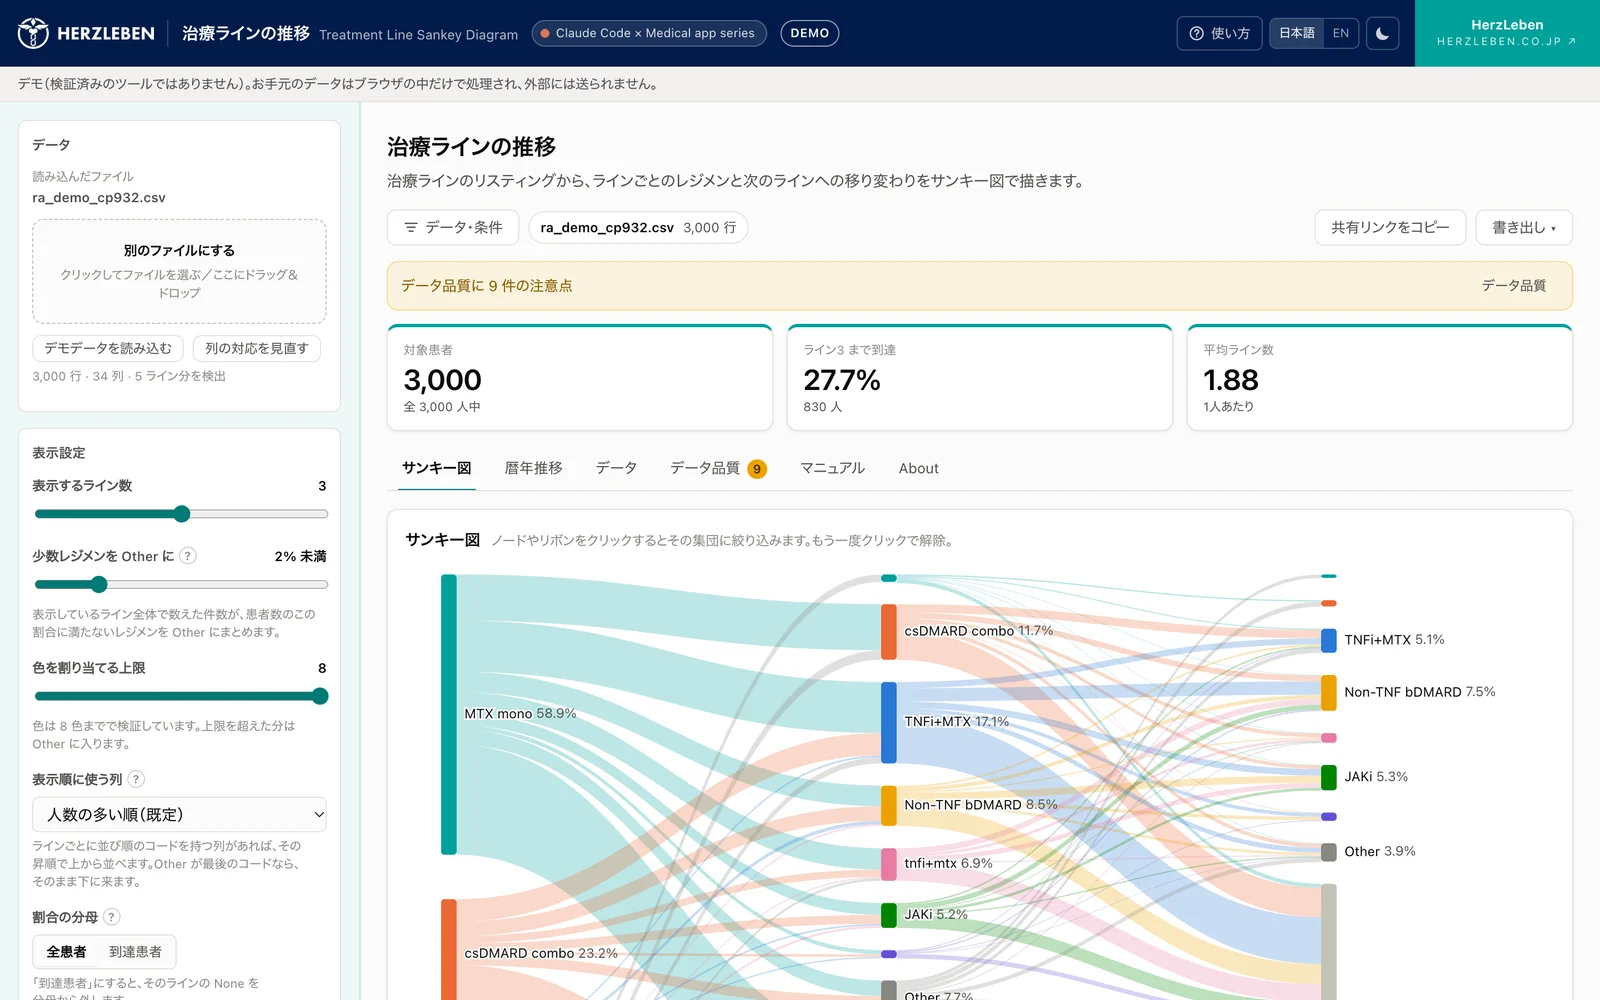
どれでも読めなければ、文字化けしたまま進めずに止まり、文字コードを判定できなかったこと と、どの文字コードで保存し直せばよいかを伝えます。中身が本当に空のファイル(0バイト・空白だけ)とは、別の知らせにしています。

5-2. 区切りの文字を推定する
区切りの文字も、カンマとは限りません。セミコロンやタブで区切ったファイルもあります。ツールは先頭の行を見て区切りの文字を推定します。引用符の中にある区切りや改行は、区切りとして扱いません。
6. Excel をブラウザの中で読む
解析の結果は、Excel のファイルで届くこともあります。Excel(.xlsx)の中身は、表の XML をまとめて圧縮したものです。治療ラインの推移は、これを ブラウザの中で展開して読みます。
- 圧縮の展開には、依存のない小さな部品(fflate)を1つだけ使う。通信はしない
- 表の XML は自前で読む
- 読むのは最初のシートだけ。数式は、保存されている値を読む
- 日付の書式のセルは日付として、整数は整数として読む(「74」が「74.0」にならない)
- 和暦や「2020年1月5日」のような日本語の日付の書式も、日付として読む
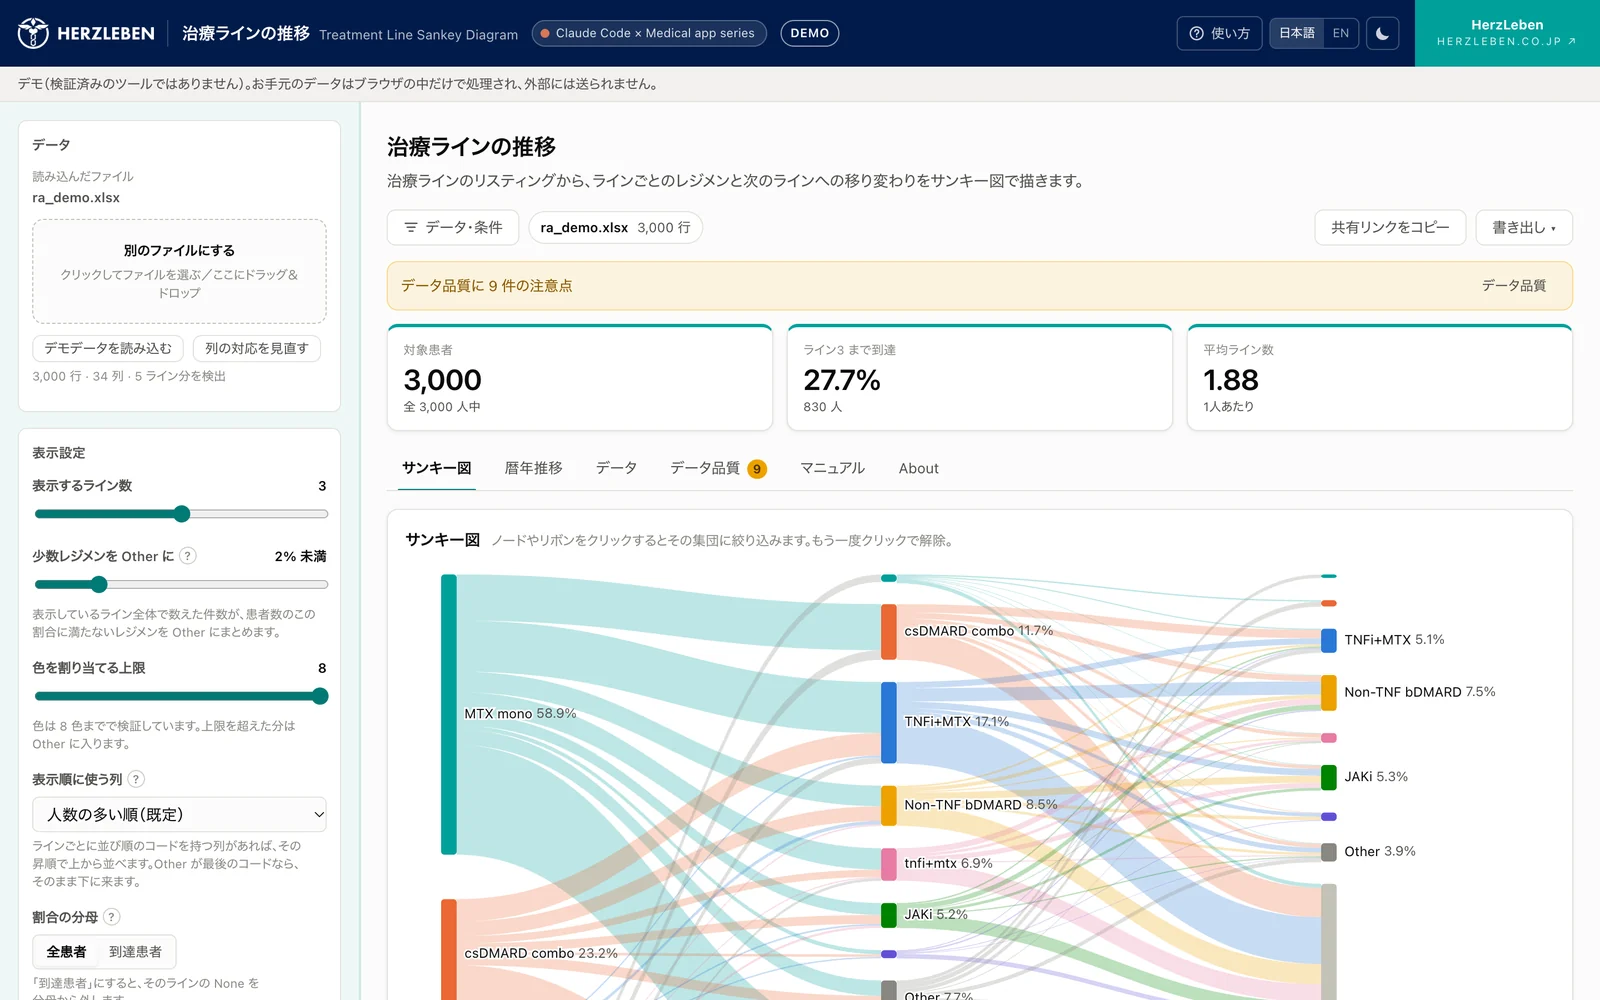
Excel を読む部品には、よく使われるものがいくつかありました。ただ、配布元のサイトからしか最新版が入らないもの、依存する部品が多いものは避けました。読み込んだファイルを外に出さないツールなので、部品そのものも通信せず、中身を見通せるものだけにする と決めていたからです。
7. 読み込んだ時点でデータの崩れを知らせる
読み込めたからといって、データが正しいとは限りません。治療ラインの推移は、読み込んだ時点で次の点を確かめ、データ品質 のタブに一覧で出します。
| 確かめること | 何が起きているか |
|---|---|
| 患者 ID の重複 | 同じ患者が2行以上ある。長い数値の ID が Excel で丸められたことが多い。重複は値のある ID だけで数える |
| 患者 ID の空欄 | ID が空の行がある。重複とは別に知らせる |
| 指数表記の ID | 1.05E+17 のような ID。CSV を作るときに文字列として書き出していない |
| 前後の空白 | " Beta " のように、値の前後に空白がある。画面では「」で囲んで空白を見せる |
| 大文字小文字・全角半角だけの違い | TNFi+MTX と tnfi+mtx、JAKi と JAKi が別の治療として数えられる |
| 日付の前後 | 2次治療の開始日が1次治療の開始日より前になっている |
| ラインの歯抜け | 1次治療が空欄なのに、2次治療に値がある |
| ラインの無い日付 | 治療の名前が空なのに、開始日だけが入っている |
| 日付として読めない値 | 日付の列に、日付でない文字が書いてある(空欄は含まない) |
| 日付の空欄 | ラインに治療があるのに、開始日が空欄 |
| ライン0の列 | line0 のような列がある。図には使われないことを知らせる |
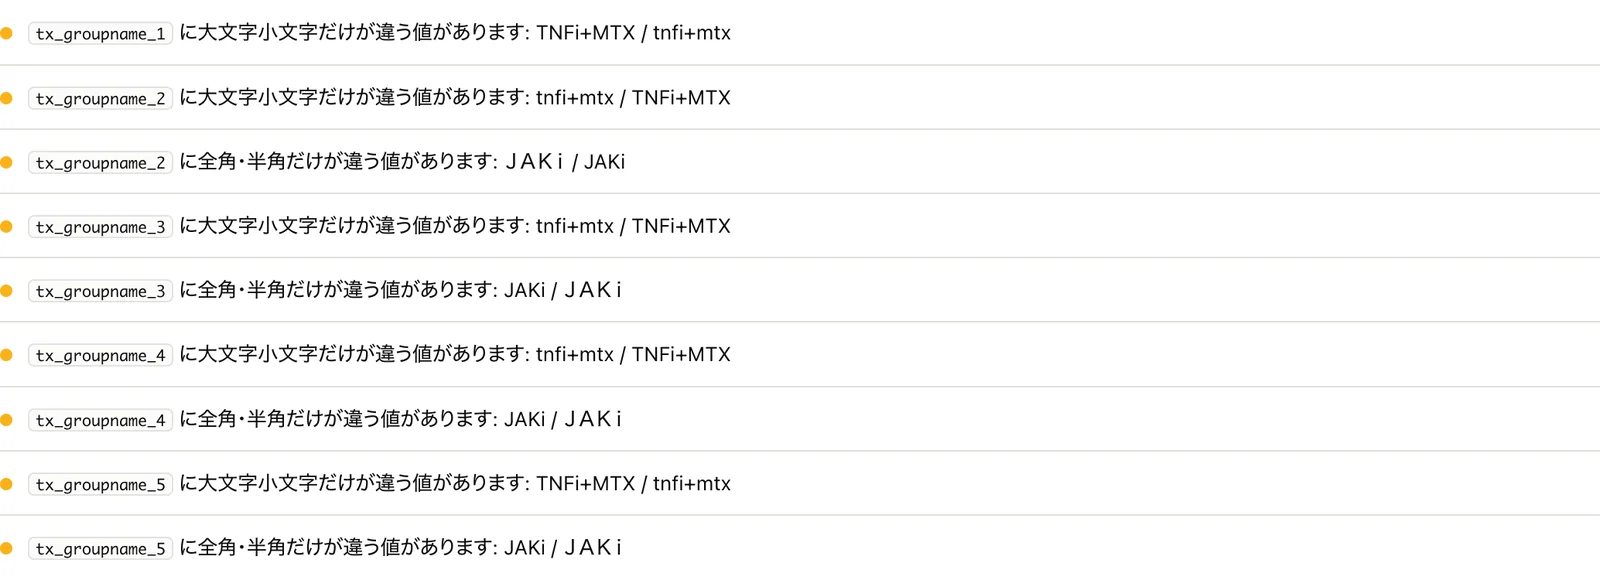
わざと崩した入力(160行・16列)を読み込むと、21件の注意点が出ました。ID のある 160 行に対して患者 ID が 149 種類しかない、1.05E+17 のような ID がある、2次治療の開始日が1次治療より前の行が 38 件ある、といった具合です。
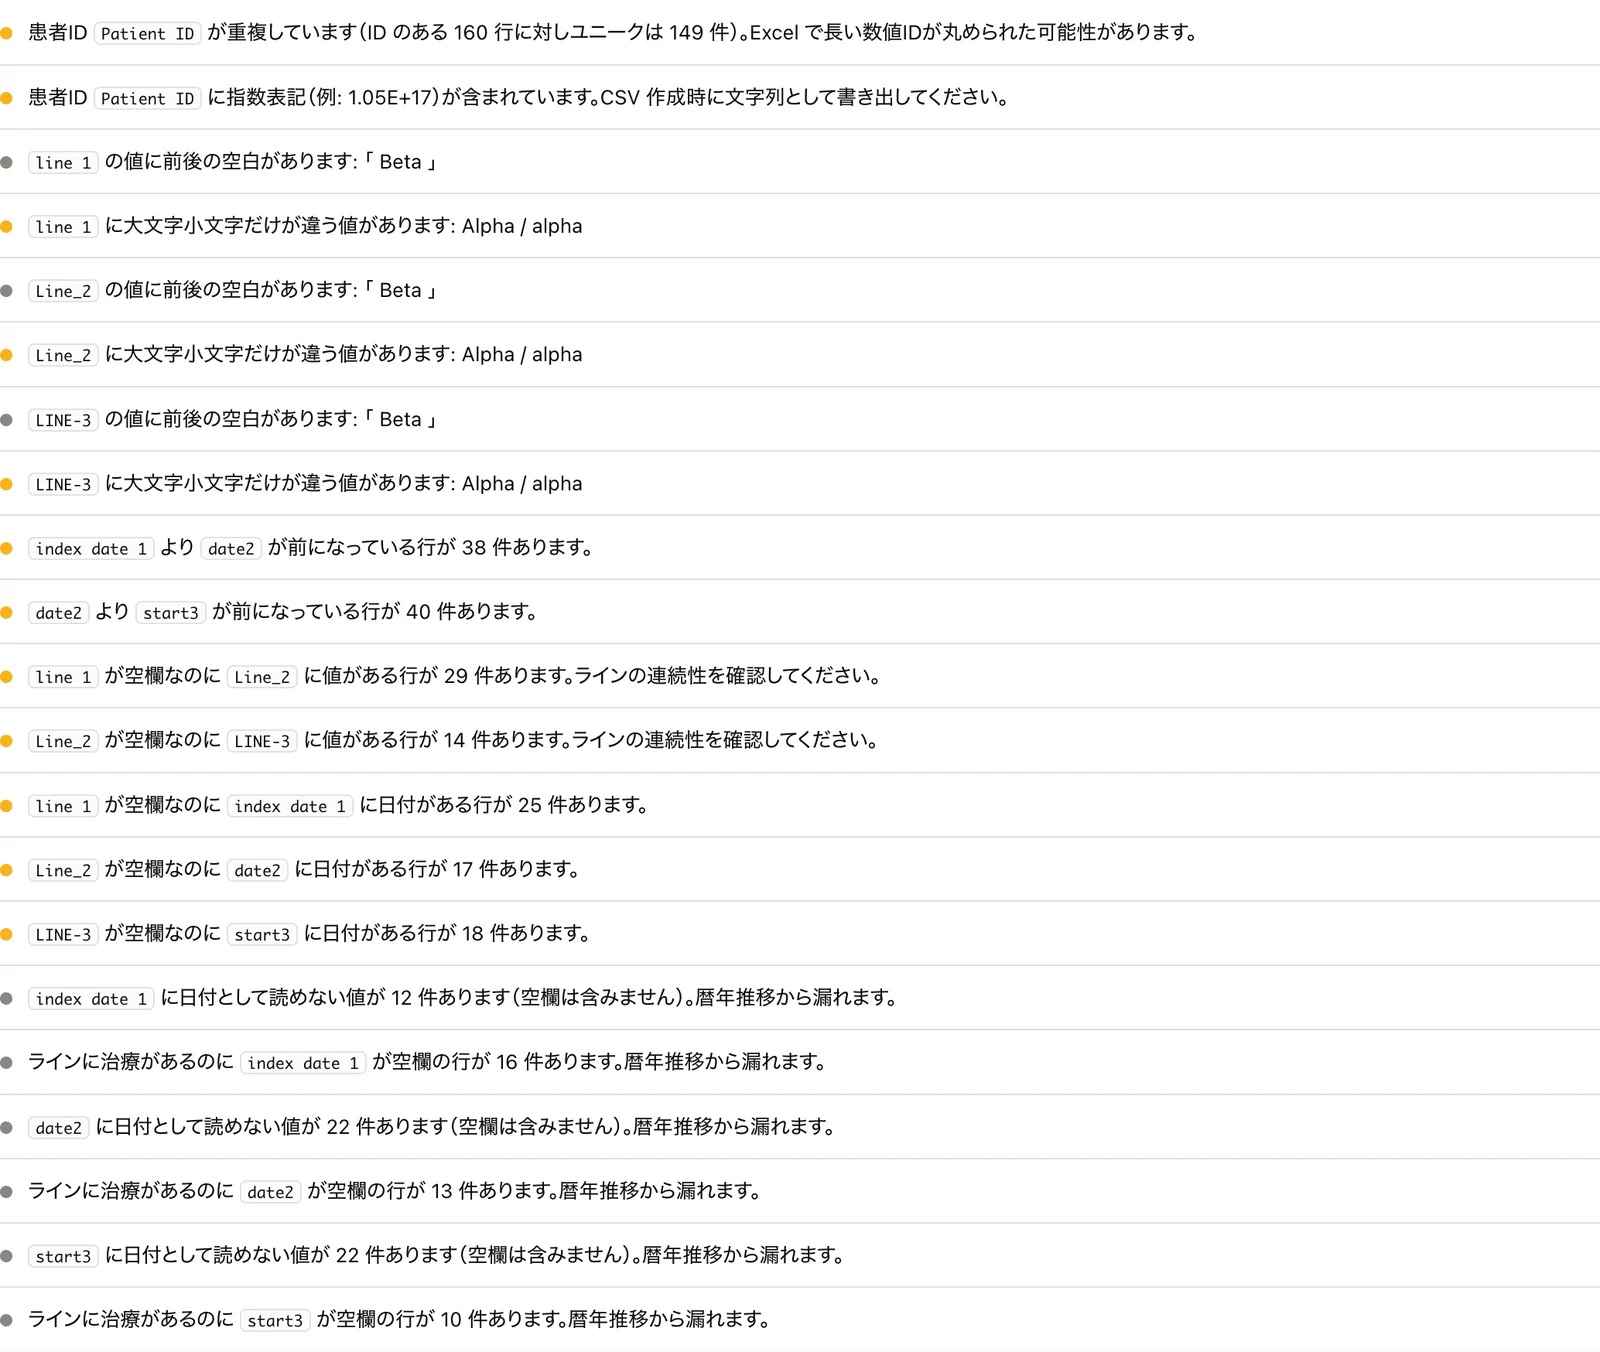
どれも、図だけを見ていては気づけません。ID の重複や表記の違いがあると、図の人数そのものが変わります。図を見る前に、まずここを見てもらう作りにしています。点検そのものをどう確かめたか、表記の違いをどうまとめるかは Part3(近日公開)で扱います。
8. この仕組みで読めないもの
| 場合 | 起きること |
|---|---|
| ラインが連番の列になっていない(1行が1つの処方の「縦持ち」のデータ) | 系統が見つからず、推定できない。ラインの区切りを済ませた形にしてから読み込む |
| 群の名前の列がなく、個別のレジメン名だけ | 文字列の系統で種類の最も少ないものが選ばれるので、柱の多い図になる。列の対応で選び直すか、群の名前の列を作る |
| 開始日と終了日の区別がつかない(同じ日付しか入っていない) | 開始日の推定が外れることがある。列の対応で確かめる |
| 判定できない文字コード(EUC-JP など) | 読み込まずに止まり、判定できなかったことを伝える。UTF-8・Shift_JIS(CP932)・UTF-16 のいずれかで保存し直す |
| Excel の古い形式(.xls)・2枚目以降のシート | 読まない。最初のシートが空なら、その旨を伝える |
どれも、推定の結果を列の対応の画面で見れば気づけるものです。推定を候補にとどめた のは、こうした場合に備えるためでもあります。
9. まとめ
- 解析用のデータは、ラインごとに連番の列が並ぶ形で届くことが多く、列の名前は会社ごとに違う
- 連番の列を系統に分け、型と値の種類を数え、「文字列で種類の最も少ない系統がライン」「日付で最も早い系統が開始日」の2つの規則で推定する。列の名前ではなく中身を見る
- 推定は候補として列の対応の画面に入れ、根拠も見せ、人が確かめてから図にする
- 文字コード3種と区切りの文字を自動で判定し、Excel もブラウザの中で読む(日本語の日付の書式も)。読めないときは、理由ごとに何をすればよいかを伝えて止まる。部品は通信しないものだけにした
- 読み込んだ時点で、ID の重複、前後の空白、表記の違い、日付の前後や空欄、ラインの歯抜けなどを一覧にする
推定が当たるかどうかより、外れたときに気づけるかどうかのほうが大事です。だから推定は、いつも候補として見せることにしました。
次のステップ
Part2 では、読み込んだデータを図にするときの設計を扱います。絞り込んでも並び順と色を変えない理由、少数の治療を Other にまとめる線の引き方、割合の分母の選び方を紹介します。
出典
- 本ページの画面写真と数値は、架空の関節リウマチのデータ(3,000人)と、わざと崩した入力で作成したものです。実在の患者・施設・薬剤・企業とは関係ありません