Claude Code × Medical Application
【技術説明】Text-to-SQL — 技術の系譜と評価指標
1. Text-to-SQL の定義
Text-to-SQL は、自然言語で書かれた質問を、データベースに投げられる SQL クエリに変換するタスクです。学術的には、文を形式的な意味表現に写す意味解析(semantic parsing)の一分野に位置づけられ、系譜としては 1960 年代に始まる自然言語データベースインタフェース(NLIDB)の直系にあたります。
入力を「質問文」だけだと思うと、この分野の難しさは理解できません。実際の入力は三つあります。
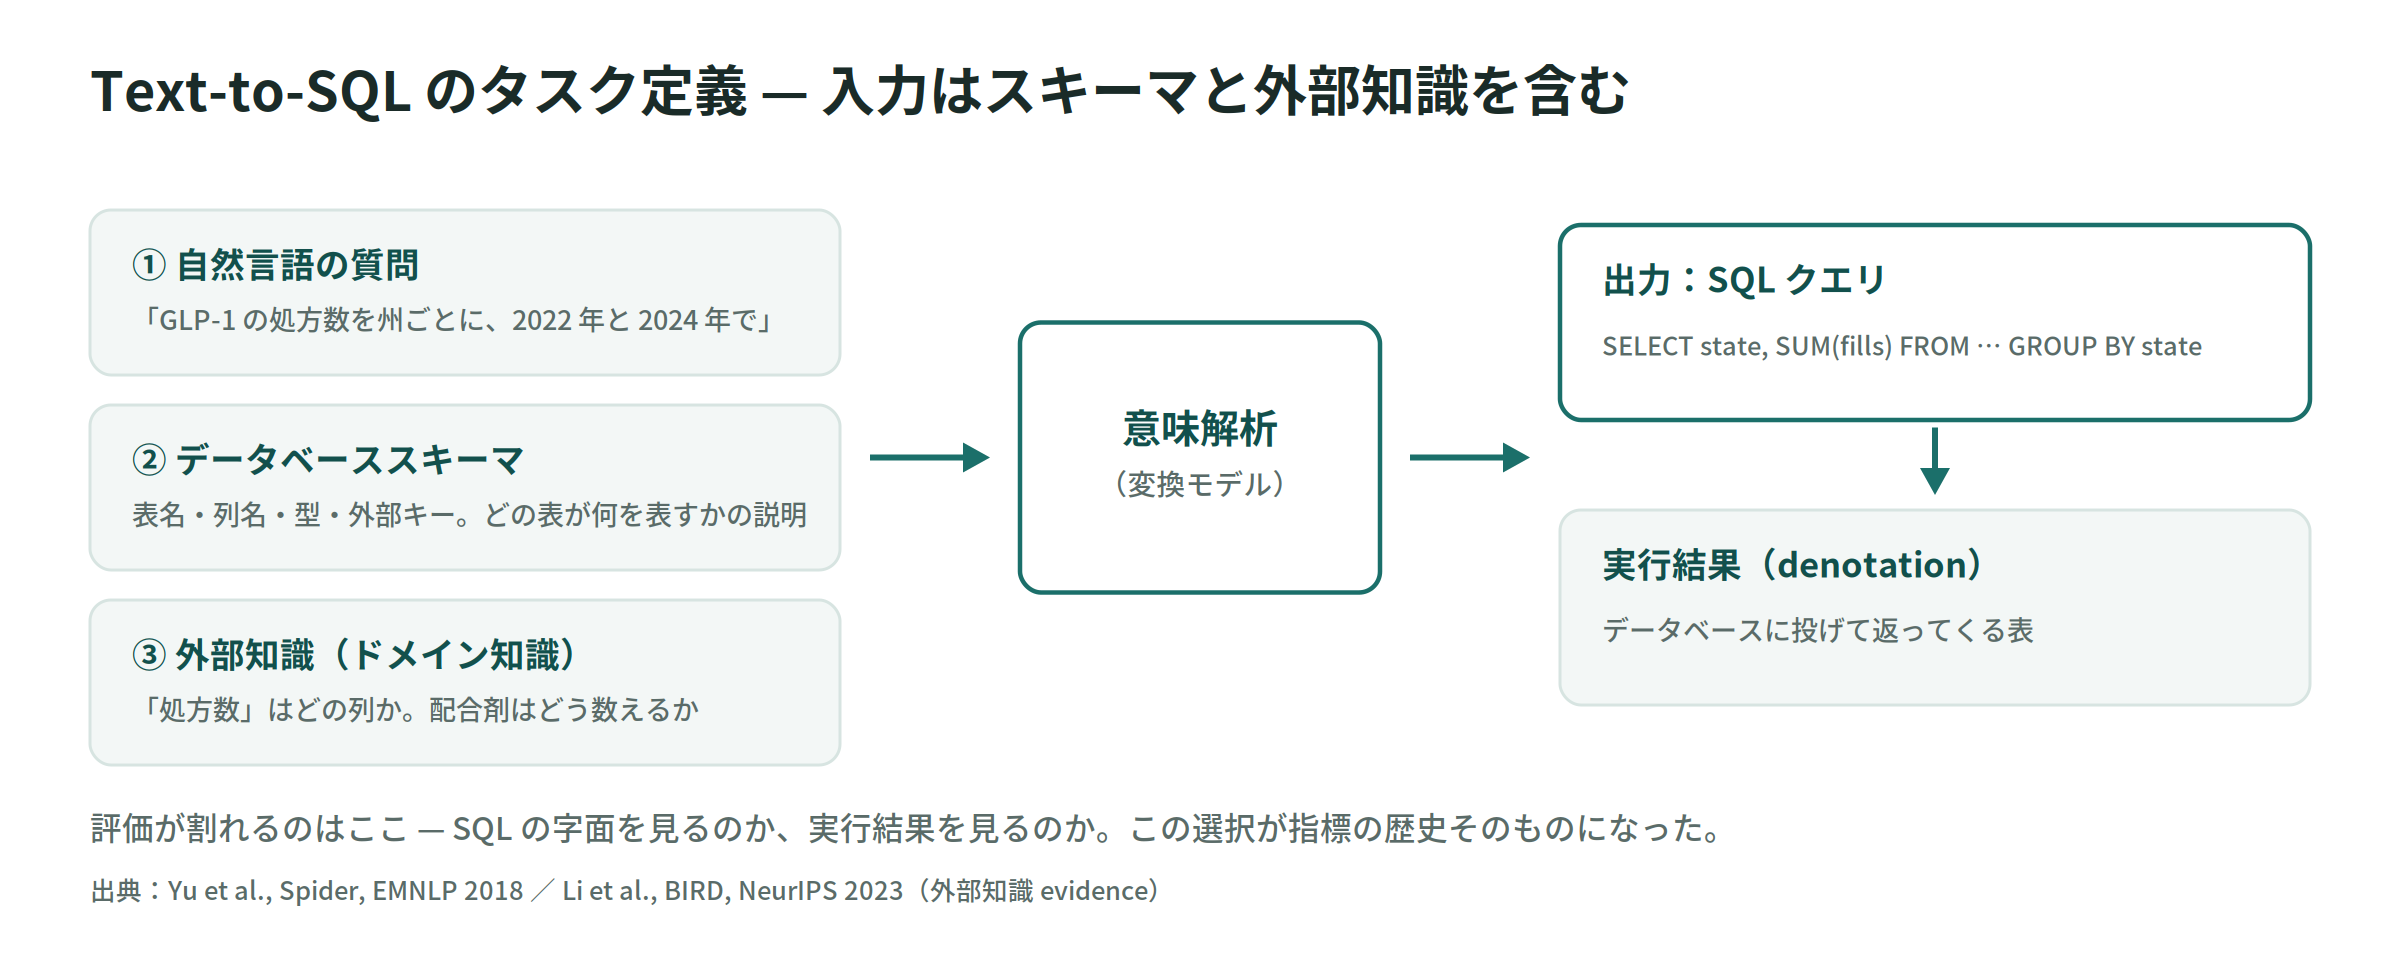
- 質問 — 「GLP-1 受容体作動薬の処方数を州ごとに、2022 年と 2024 年で比べて」
- データベーススキーマ — 表名、列名、型、外部キー。どの表が何を表すかの説明
- 外部知識 — 「処方数」がどの列を指すのか、配合剤をどう数えるのか
出力は SQL クエリで、それを実行して得られる表を表示内容(denotation)と呼びます。評価の話が後で長くなるのは、正しさを SQL の字面で見るのか、実行結果で見るのかという分岐が、この定義の時点で生まれるからです。
根本的な難しさは、自然言語が曖昧さを許すのに対し、SQL が一意な手続きを要求する点にあります。人は「多い」と言えば通じますが、SQL は件数なのか金額なのかを決めないと書けません。Text-to-SQL の 60 年は、この非対称をどう埋めるかの歴史です。
2. 四つの時代
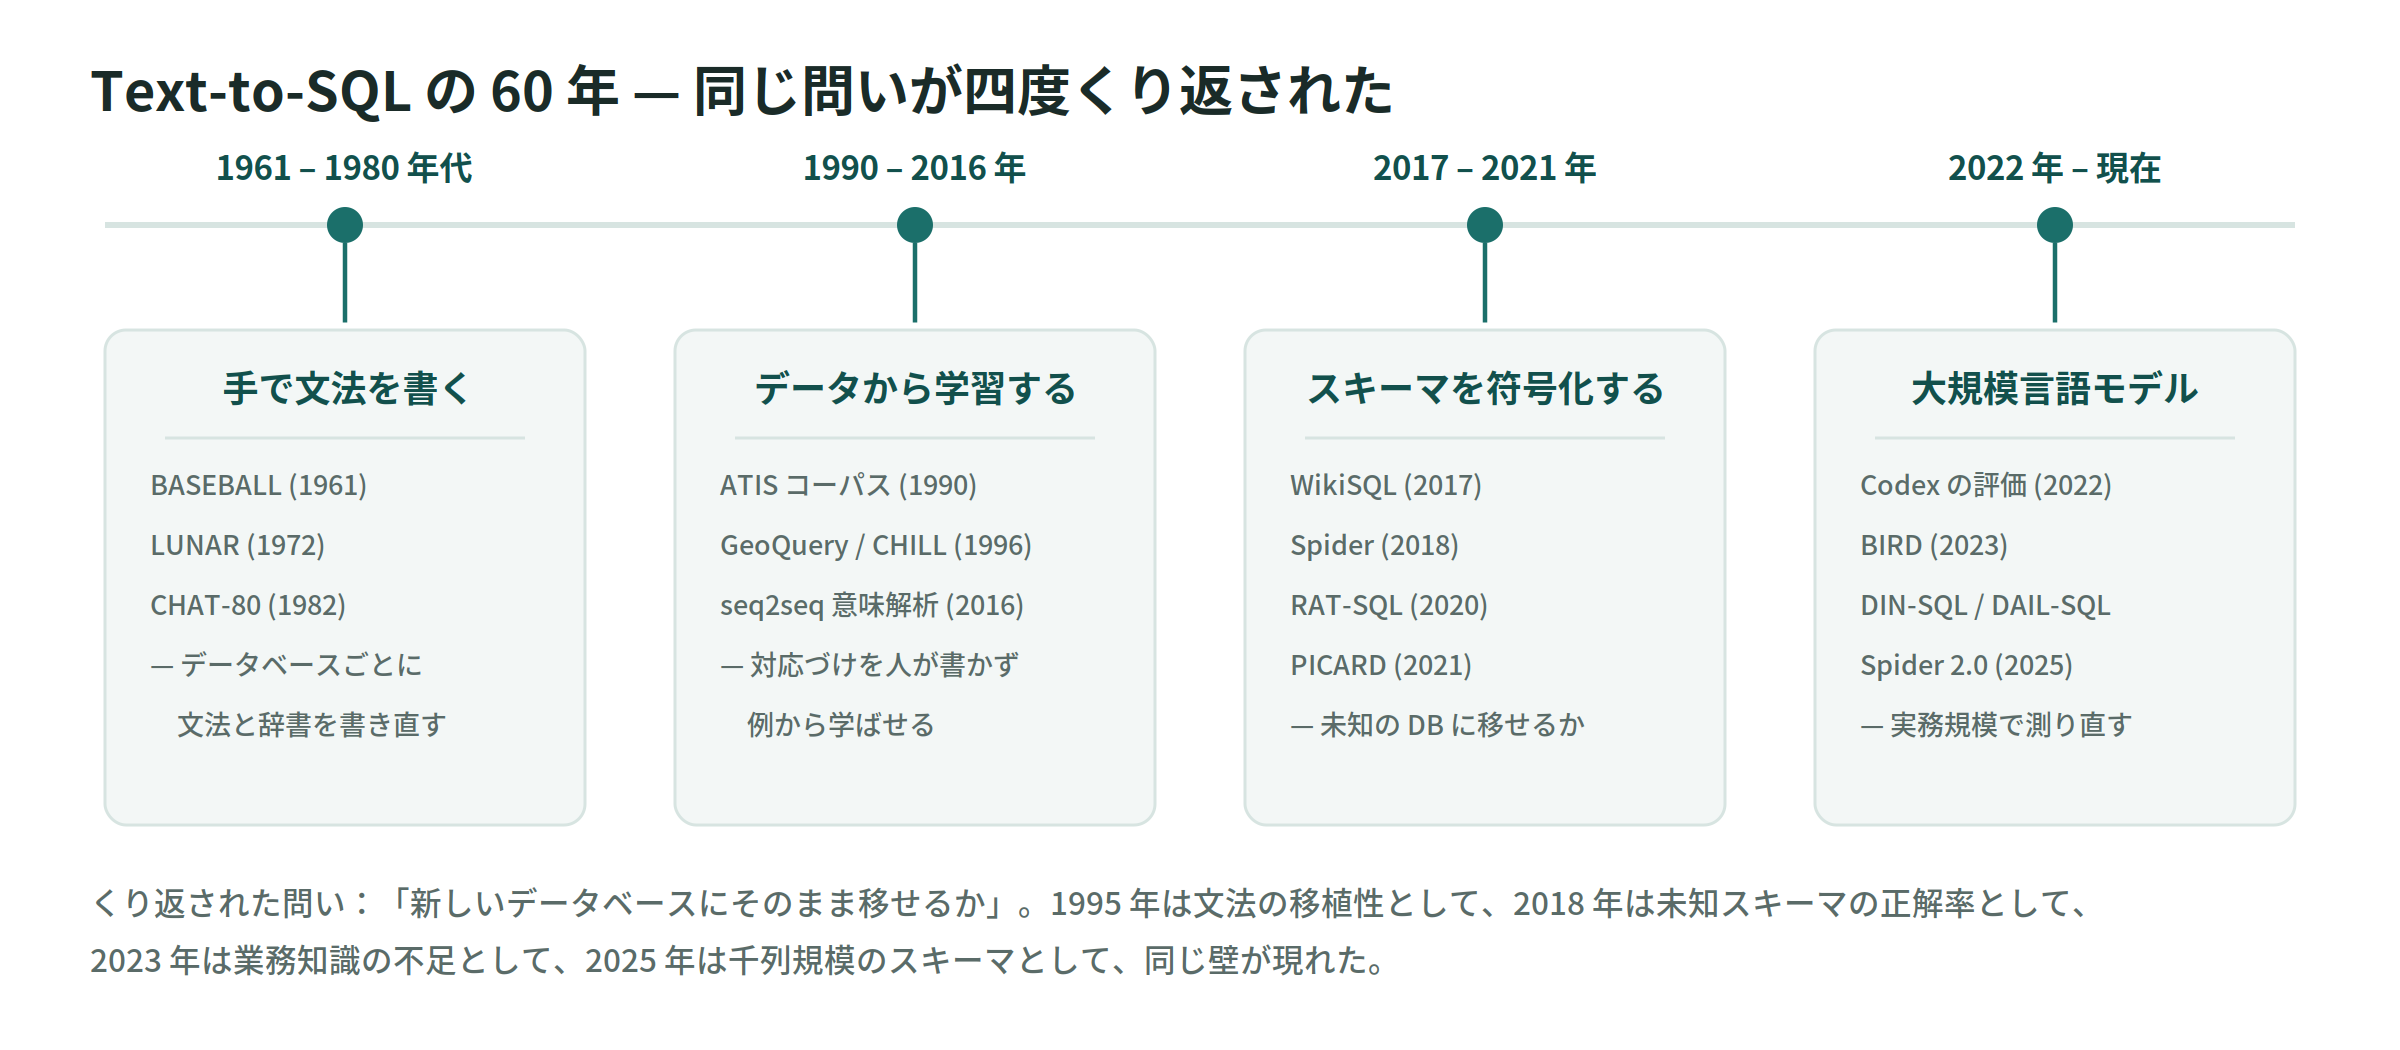
60 年のあいだに、人が手で書いていた部分は少しずつ機械へ移りました。どこが移り、どこが移らなかったかを並べると、この分野が何を解いてきたのかが見えます。
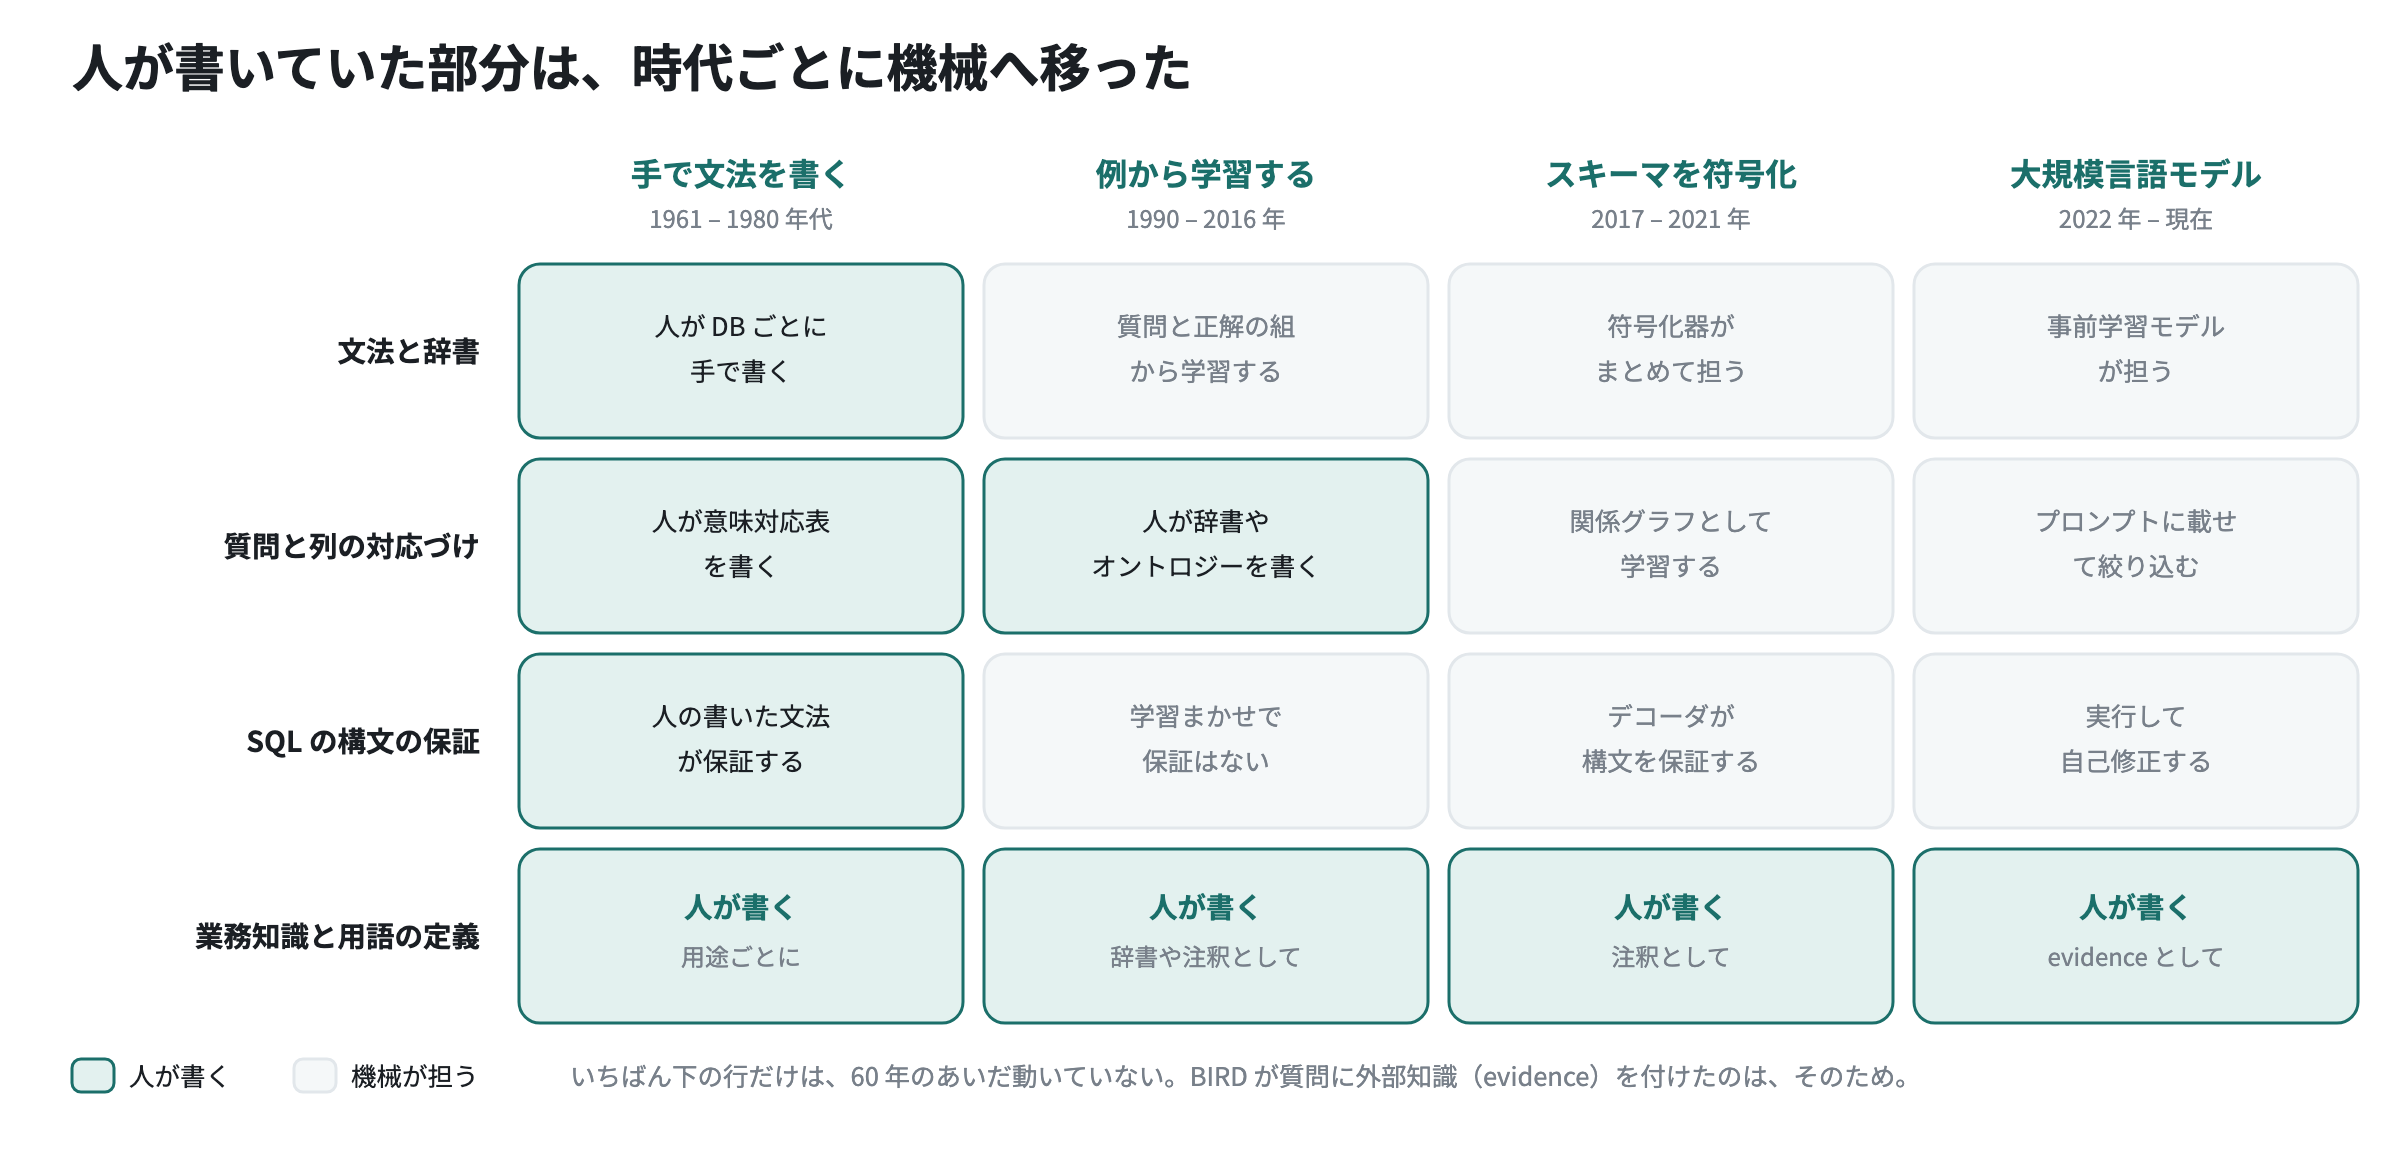
手で文法を書いた時代(1961 年〜1980 年代)。 Green らの BASEBALL(1961 年)に始まり、アポロ 11 号が持ち帰った月試料の分析データベースに質問できた LUNAR(Woods ら, 1972 年)、全体を Prolog で実装しコードが広く配布された CHAT-80(Warren & Pereira, 1982 年)と続きます。CHAT-80 の世界地理データベースは、後の GeoQuery データセットの祖先でもあります。
例から学ぶ時代(1990 年〜2016 年)。 ATIS(1990 年)が 30 年にわたる標準の試験台になり、Zelle & Mooney の CHILL(1996 年)が構文解析器の制御規則を「質問と正解クエリの組」から学習しました。人が文法を書く作業そのものを学習で置き換えた最初の一歩です。2016 年には Dong & Lapata が注意機構つき encoder-decoder で論理形式を直接生成し、手作りの文法と辞書が一度に不要になります。
スキーマを符号化する時代(2017 年〜2021 年)。 決定的だったのは Spider(Yu ら, EMNLP 2018)です。10,181 問・200 データベース・138 ドメインを収録し、テスト時のデータベースは学習時に見せない設計にしました。当時の最良モデルの完全一致正解率は 12.4%。1995 年の「移植性」という言葉が、初めて数字になった瞬間でした。以後の研究はスキーマリンキングに集中し、RAT-SQL(ACL 2020)が質問とスキーマを型つきの関係グラフとして同時に符号化し、PICARD(EMNLP 2021)がデコードの各ステップで SQL パーサを走らせて構文の成立しない候補を捨てました。
大規模言語モデルの時代(2022 年〜)。 微調整なしの Codex が、プロンプトだけで Spider 開発セットの実行一致 67.0%(テストスイート一致 55.1%)に達しました(Rajkumar ら, 2022 年)。同時に、スキーマの書き方で精度が変わることも示されます。2026 年現在の上位手法は、新しいモデル構造ではなく、試行回数と検証にコストを払う設計(内部推論の強化学習、逐次的な修正、並列生成とトーナメント選択)に収束しています。
曖昧さを消すのではなく人に返す設計も、この系譜にあります。PRECISE(2003 年)は正解を保証できる質問の範囲を定義し、範囲外なら答えずに言い換えを求めました。NaLIR(2014 年)は解釈候補を複数提示して利用者に選ばせ、ATHENA(2016 年)は自然言語とスキーマの間にオントロジー層を挟みます。今でいうセマンティックレイヤの原型です。
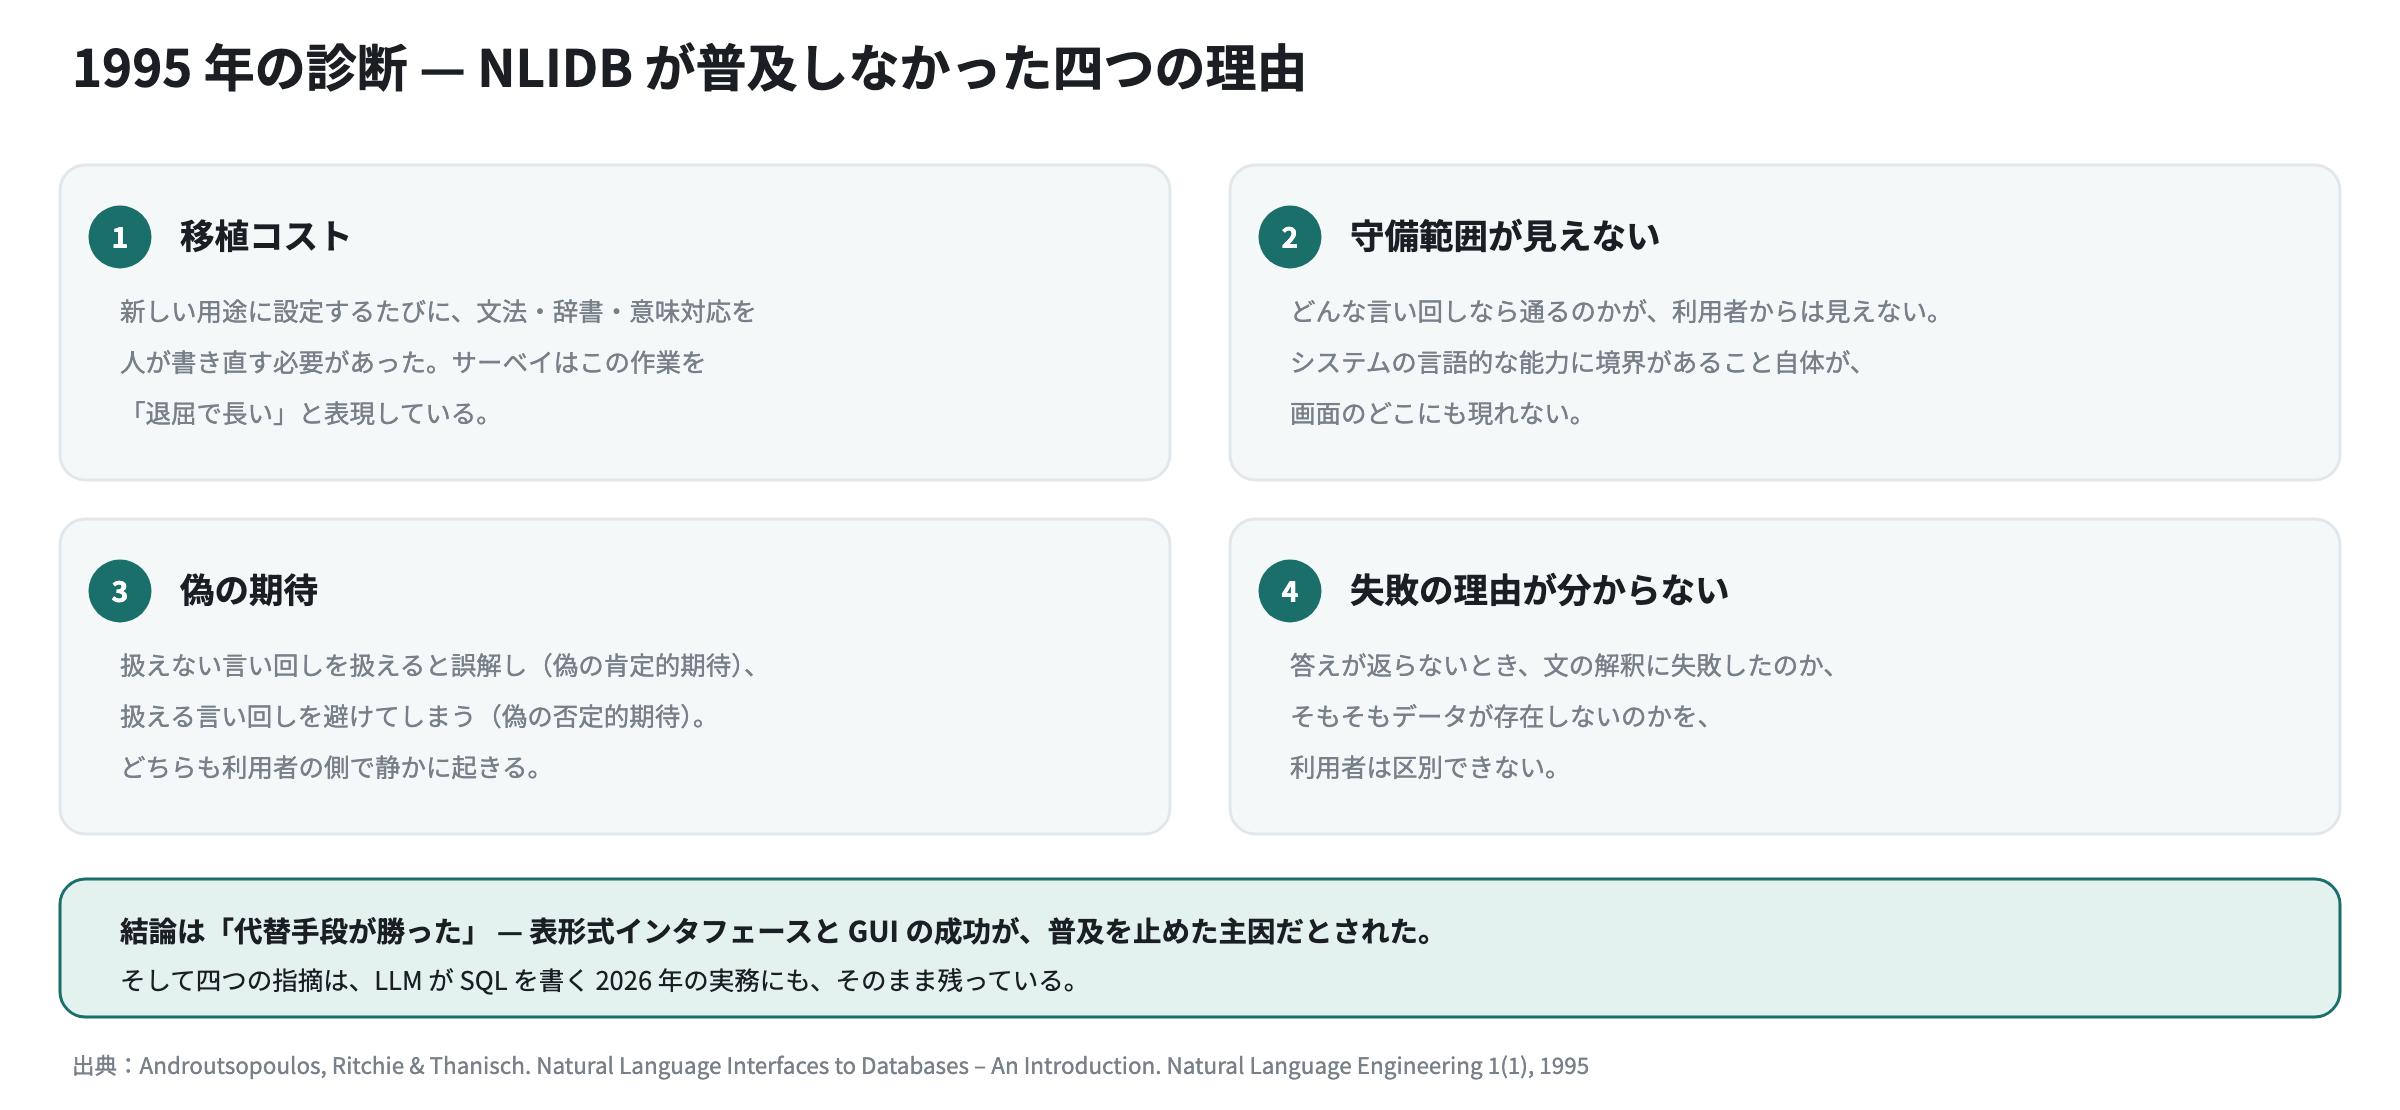
そして、NLIDB が期待されたほど普及しなかった理由は、1995 年の古典的サーベイがすでに数え上げていました。
3. 四つの溝
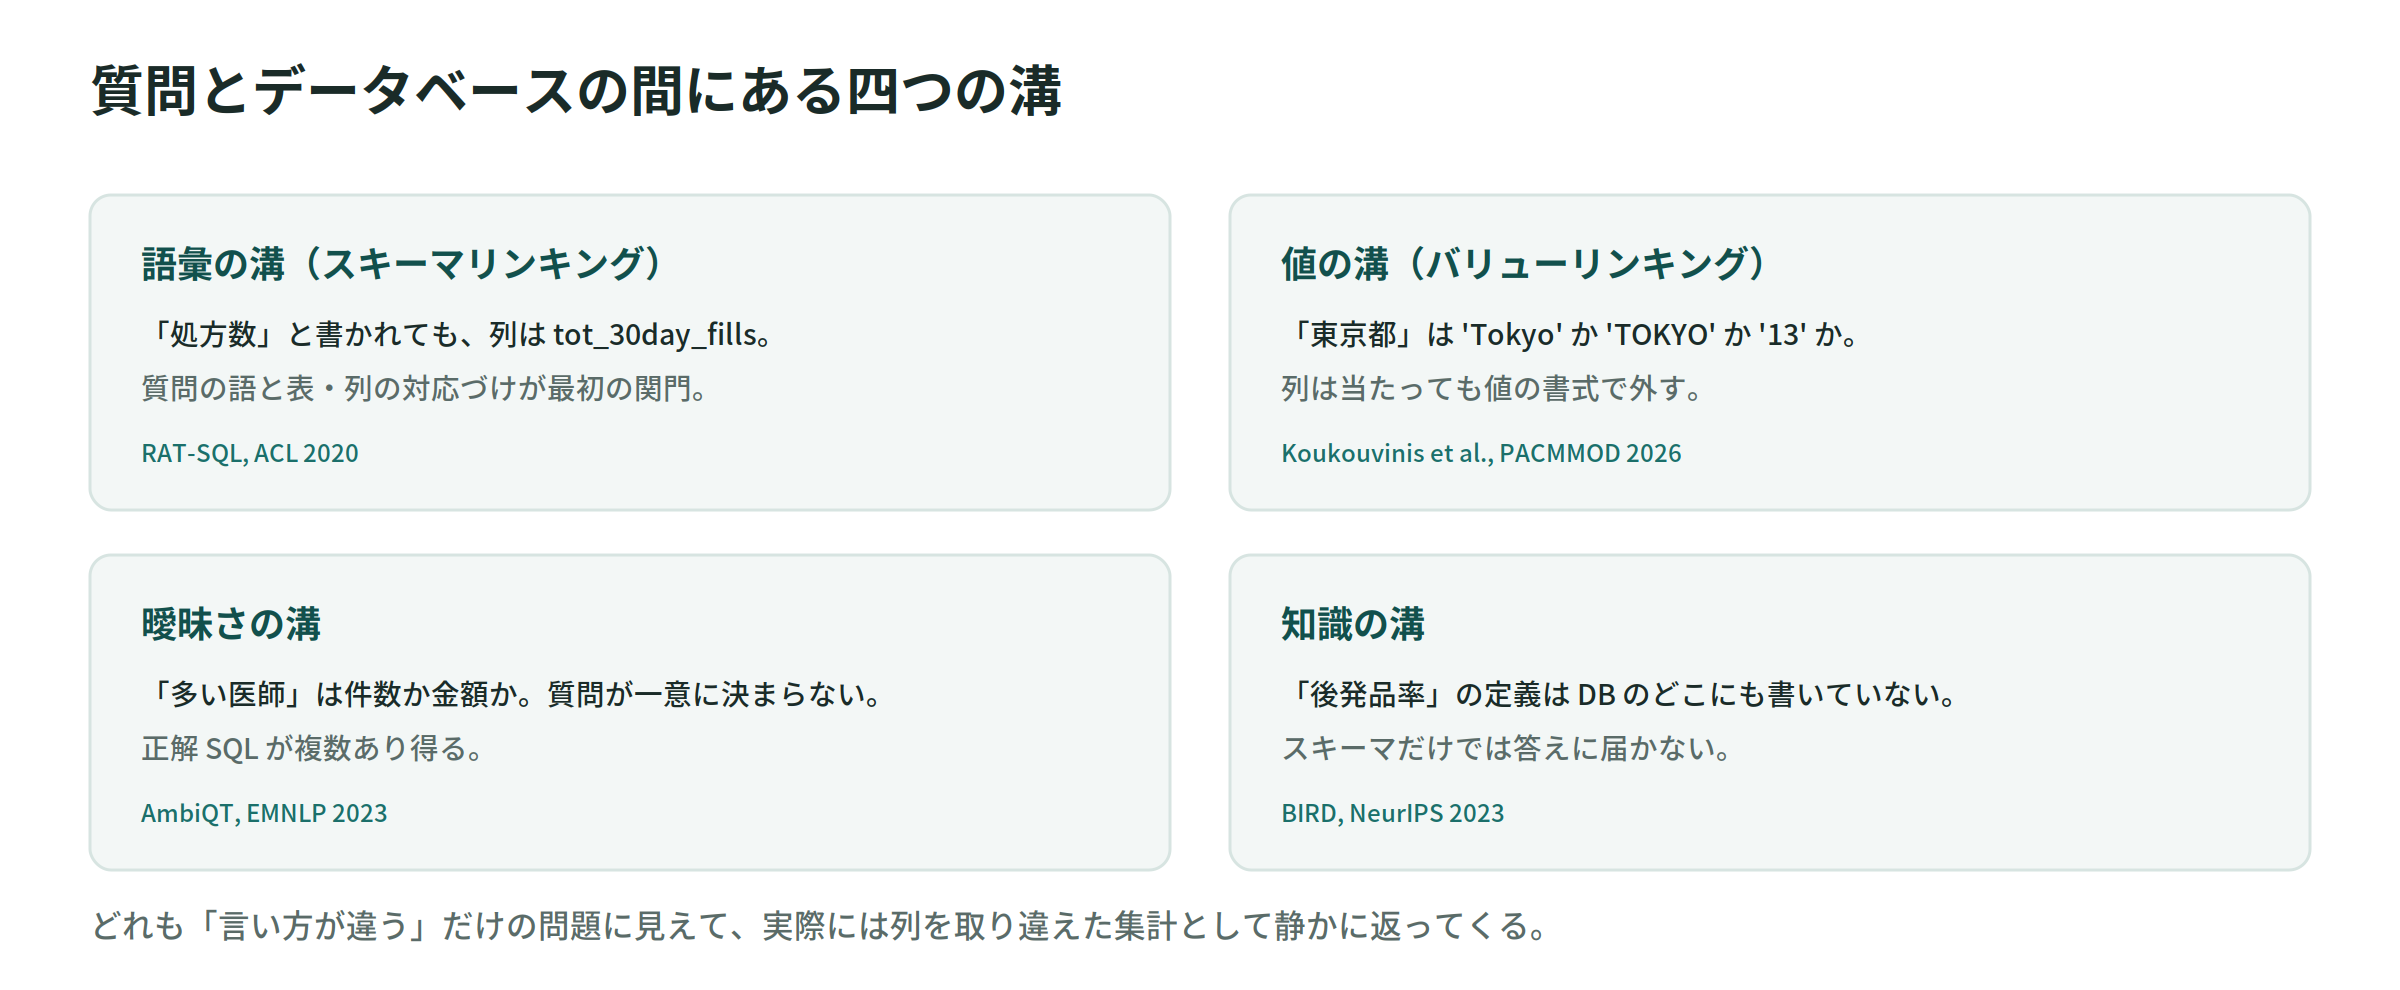
研究で繰り返し名指しされてきた難所は、上の四つに整理できます。語彙の溝については、LLM 時代には「推論力の高いモデルには、刈り込んだスキーマより全体を渡した方がよい」という反証も出ており(Maamari ら, 2024 年)、決着していません。ただし数百表・数千列という実務規模では、渡す前の絞り込みは依然として必要です。値の溝は専用の研究が最近まで乏しく、2026 年の調査では、最先端システムでも値リンキングの誤りによって実行一致が最大 64% 失われると報告されています。
これに SQL 方言と規模が重なります。16 方言を揃えた 2026 年のベンチマークでは、最高のモデルでも平均 54.63%、SQLite で正解した質問のうち全方言で正解を保ったものは 33.66% にとどまりました。Spider 2.0 が扱う企業データベースは 1,000 列を超え、正解 SQL が 100 行を超えることもあります。
4. 評価指標の歴史
Text-to-SQL は「動く」と「正しい」が別で、しかも「正しい」の定義が難しい技術です。指標の歴史は、字面を見ると実行結果を見るの往復として読めます。
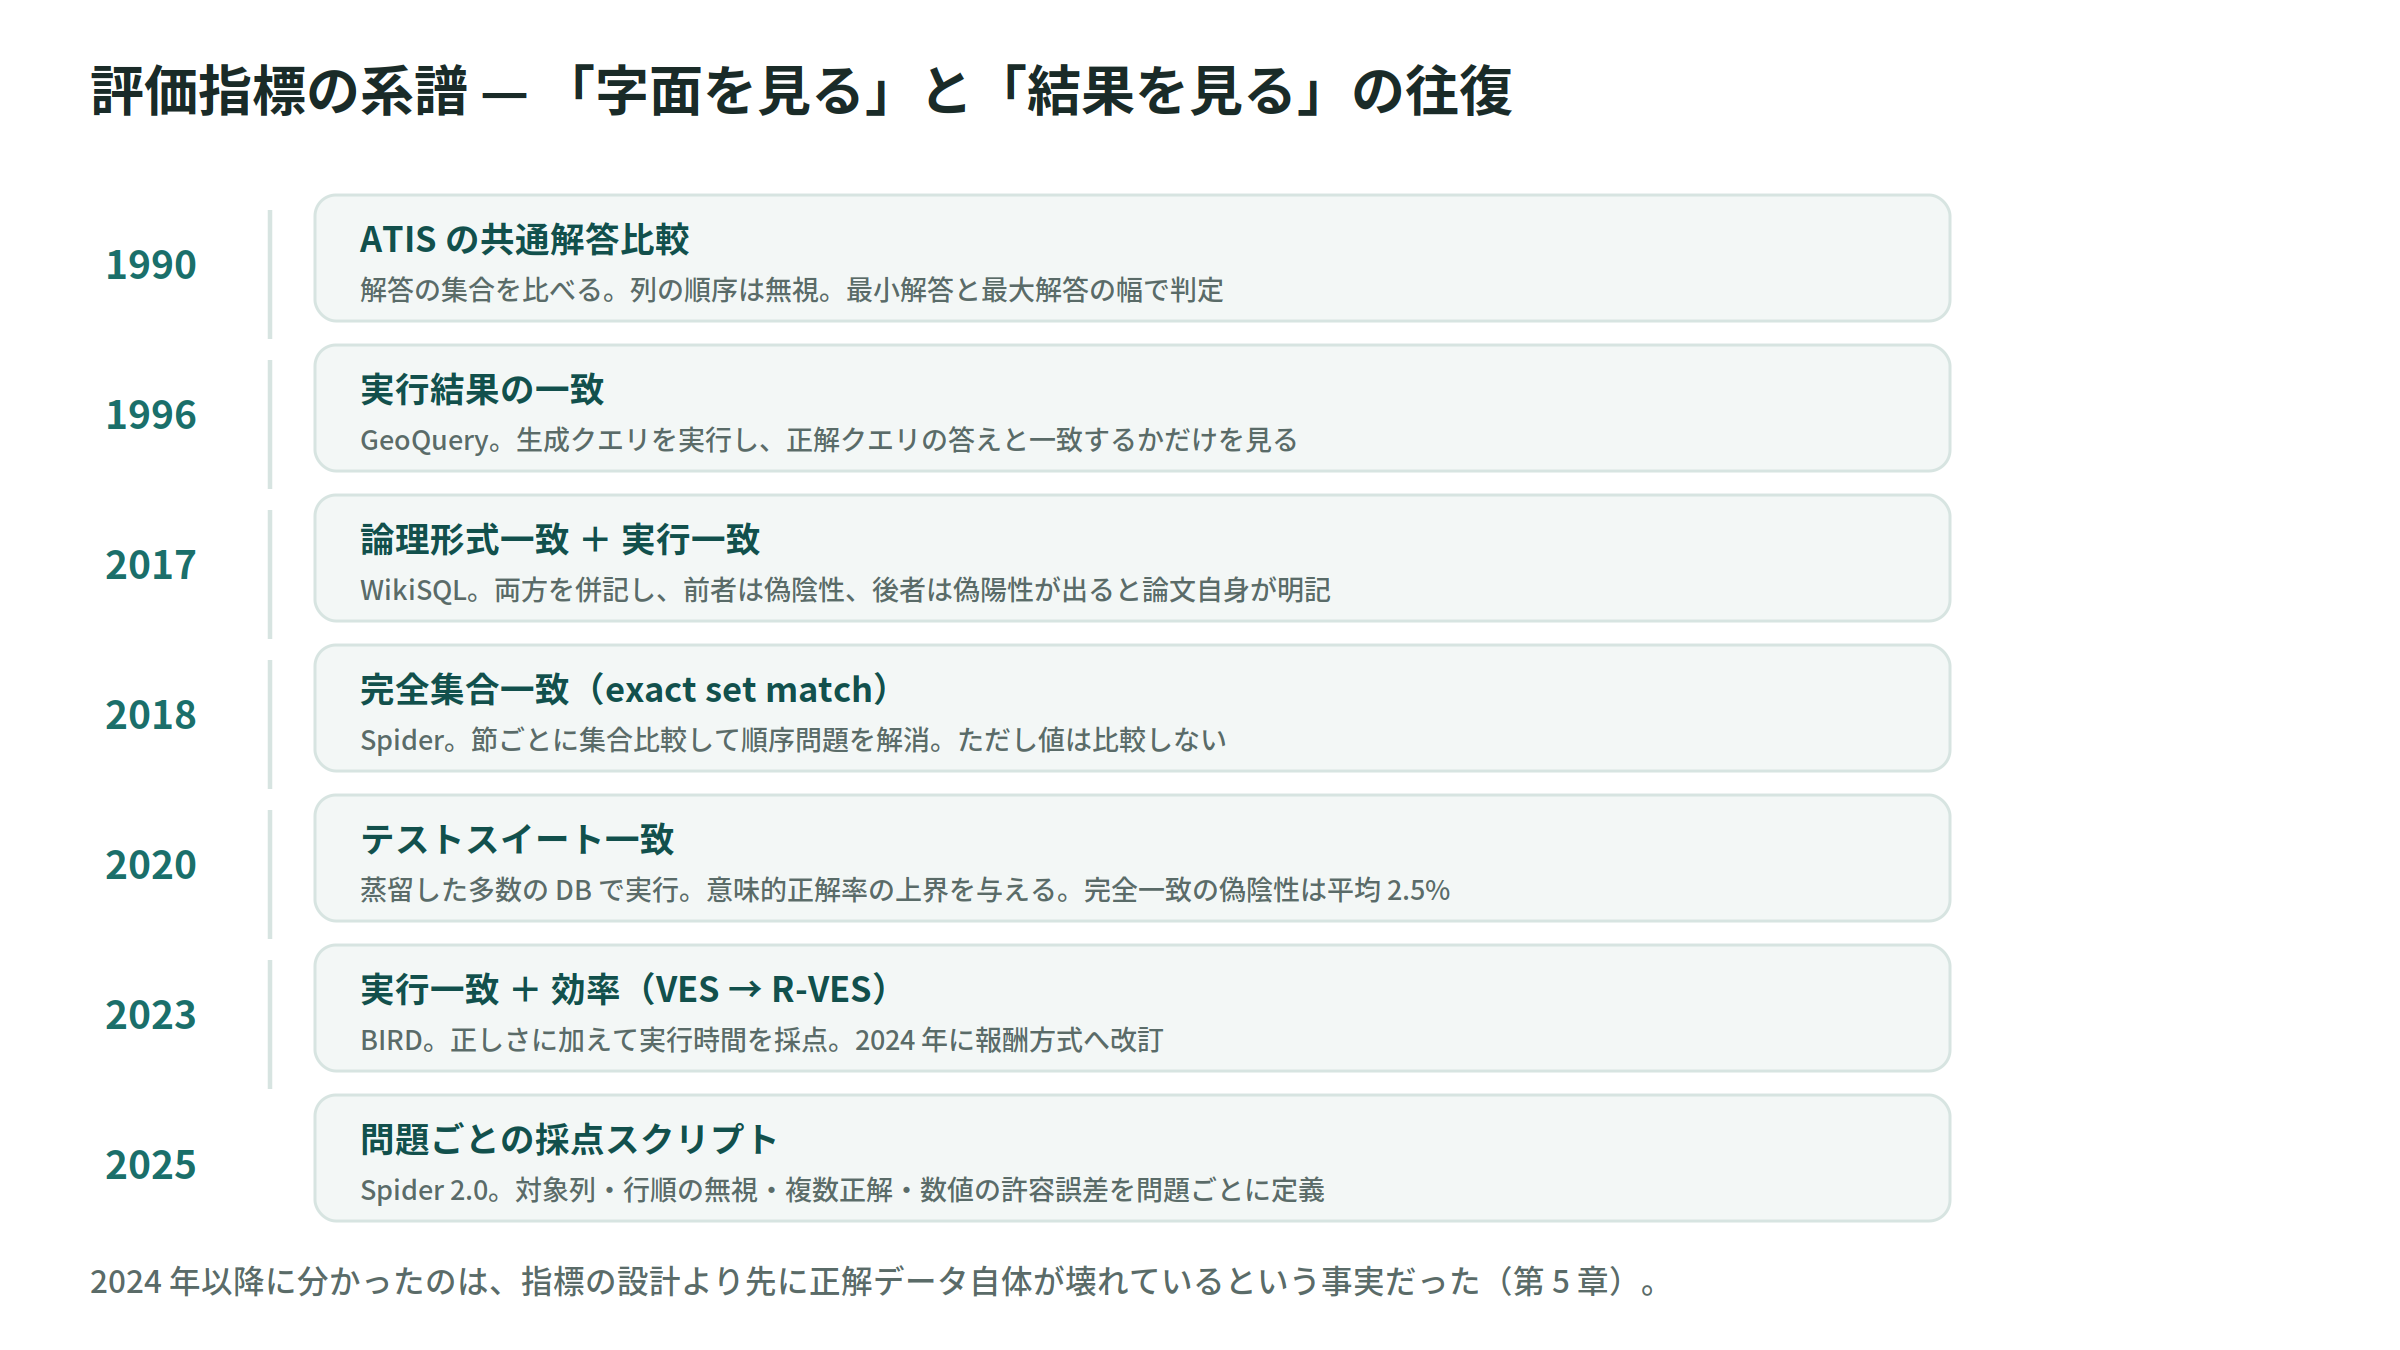
論点の多くは、1990 年の ATIS の採点方式に出揃っていました。表の列の順序は正しさに関係しないという原則も、誤答と無回答を区別して数えるという発想も、この時点で明示されています。2026 年の指標が再発明した論点は、ほぼここで出尽くしていました。
転回点は 2020 年です。Zhong・Yu・Klein は、スキーマに沿ってランダムなデータベースを大量に生成し、正解クエリの「近傍クエリ」(比較演算子や定数を少しずつ変えた、意味の違うクエリ)を区別できるものだけを貪欲に選んで蒸留したテストスイートを作りました。その全データベースで結果が一致したときだけ正解とする方式です。この論文が示した含意関係が、評価を考えるときの基本になります。
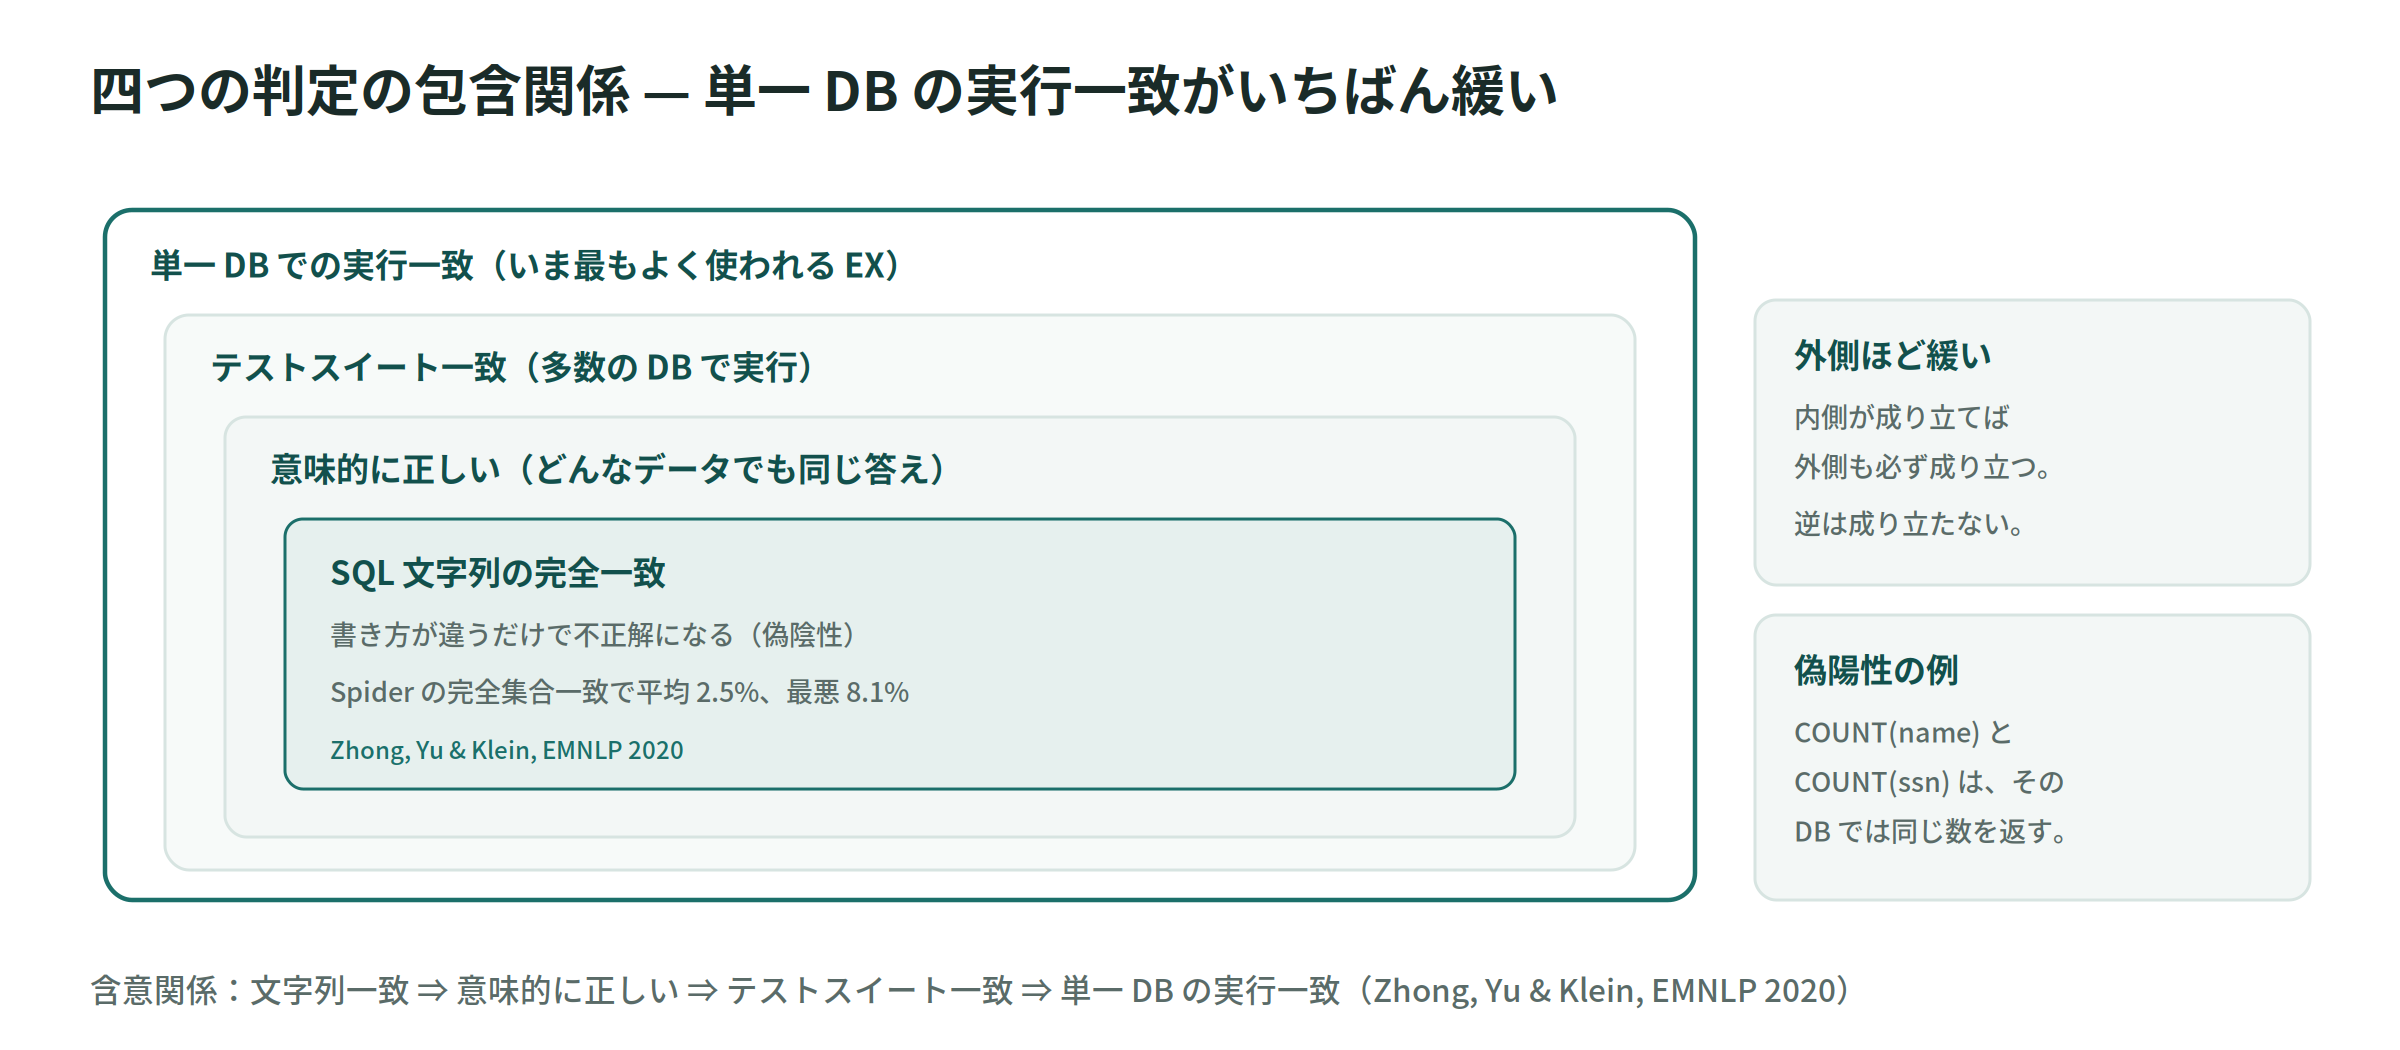
内側が成り立てば外側も必ず成り立ち、逆は成り立ちません。つまり、いま最もよく使われる単一データベースの実行一致が、意味的正解率のいちばん緩い上界です。同論文は Spider への提出 21 件を検証し、完全集合一致が意味的に正しいクエリを落とす率を平均 2.5%、最悪 8.1% と測りました。両指標の順位相関は全体で 91.4%、難問部分集合では 74.1% まで落ちます。Spider は 2020 年 10 月から、この指標を公式に採用しました。
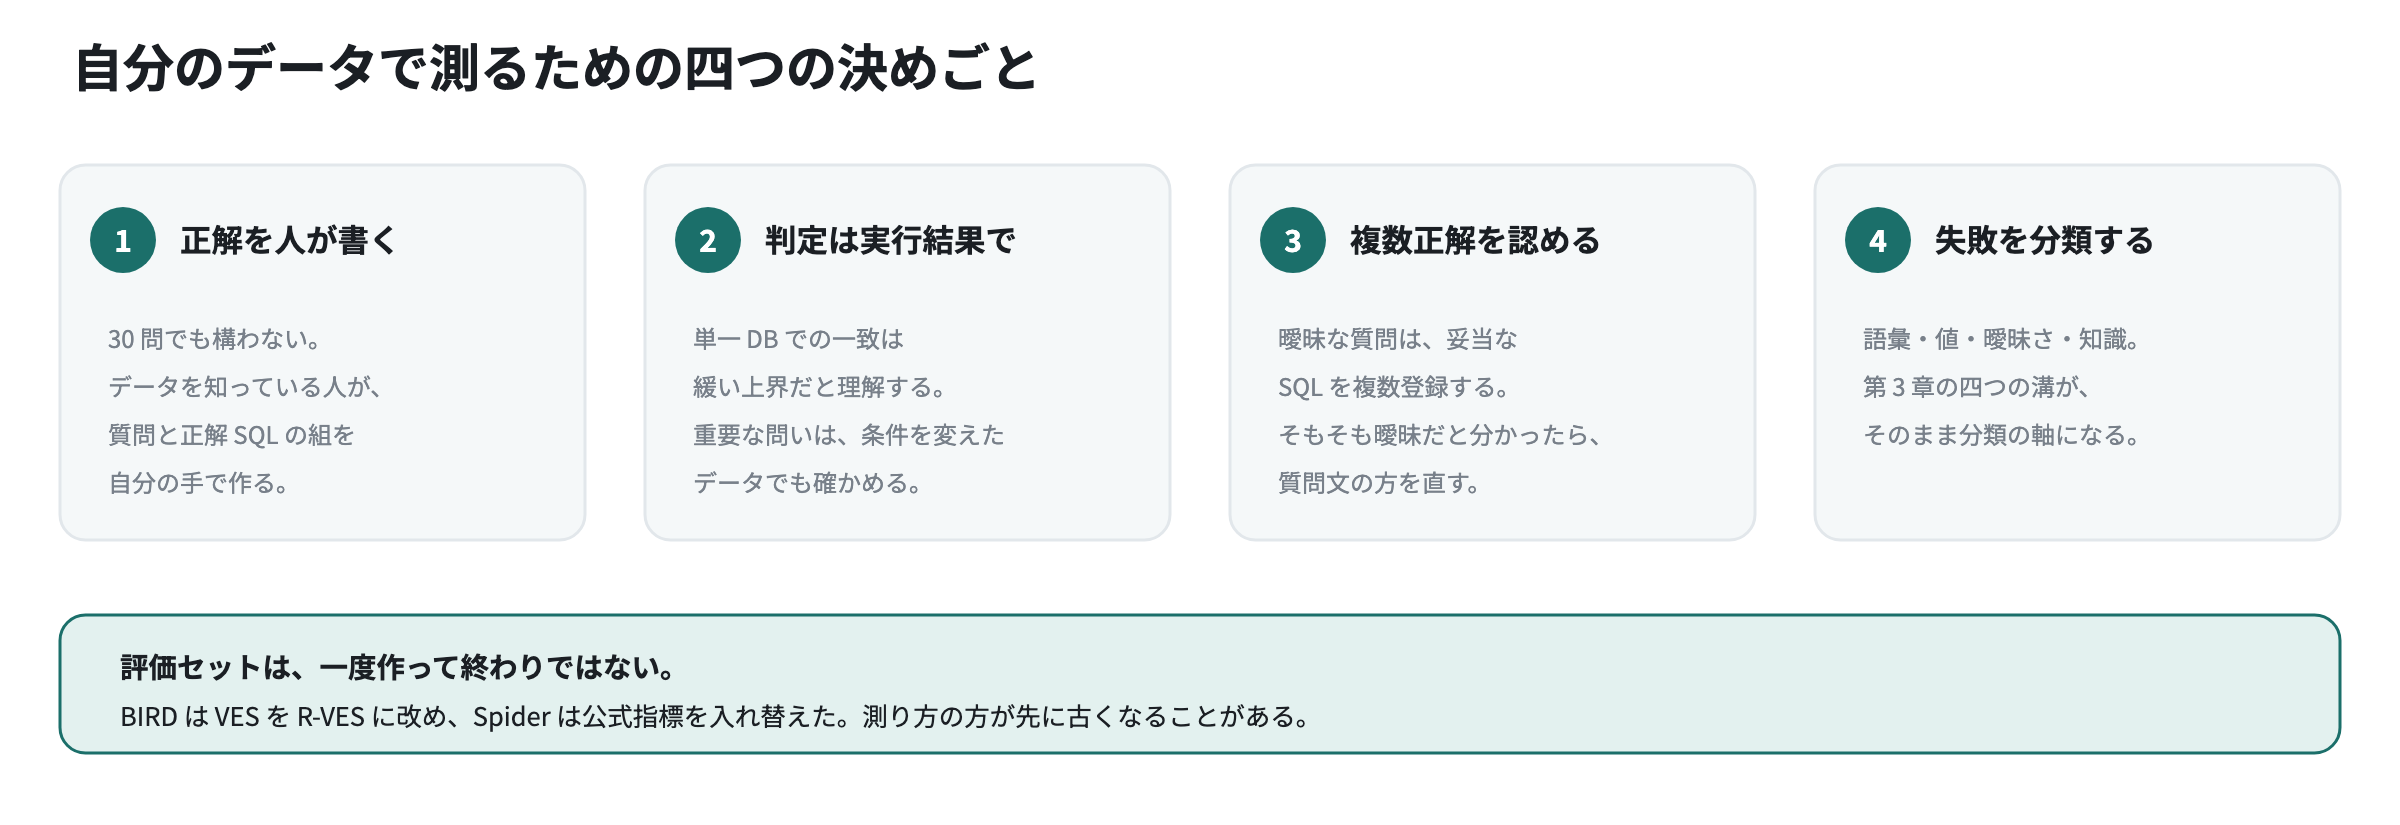
指標は一度作って終わりではありません。BIRD(2023 年)は実行一致に効率を足し、当初の VES を 2024 年 8 月に R-VES へ改めました。Spider 2.0(2025 年)は汎用の一致判定そのものをやめ、採点対象の列・行順を無視するか・複数の正解表を許すか・数値の許容誤差を、問題ごとに定義しています。
指標の整理
| 指標 | 見るもの | 強み | 取りこぼし |
|---|---|---|---|
| 文字列の完全一致 | SQL の字面 | 実行環境が要らない | 等価な書き換えを不正解にする |
| 完全集合一致 | 節ごとの集合 | 句の順序差を吸収 | 値を見ない。等価な書き換えは依然落ちる |
| 実行一致(単一 DB) | 結果の表 | 書き方を問わない | 偶然一致する誤りを正解にする |
| テストスイート一致 | 多数の DB での結果 | 意味的正解率の上界を締める | DB 生成の手間。有限個ゆえ完全ではない |
| 実行一致+効率 | 結果と実行時間 | 実務的な質を測れる | 環境差の影響を受ける |
| 問題ごとの採点 | 問題単位で定義 | 実務の多様さに合う | 設計と保守の人手が要る |
5. 正解データ自体の問題
2024 年以降に明らかになったのは、指標の設計より先に、正解データそのものが壊れているという事実でした。
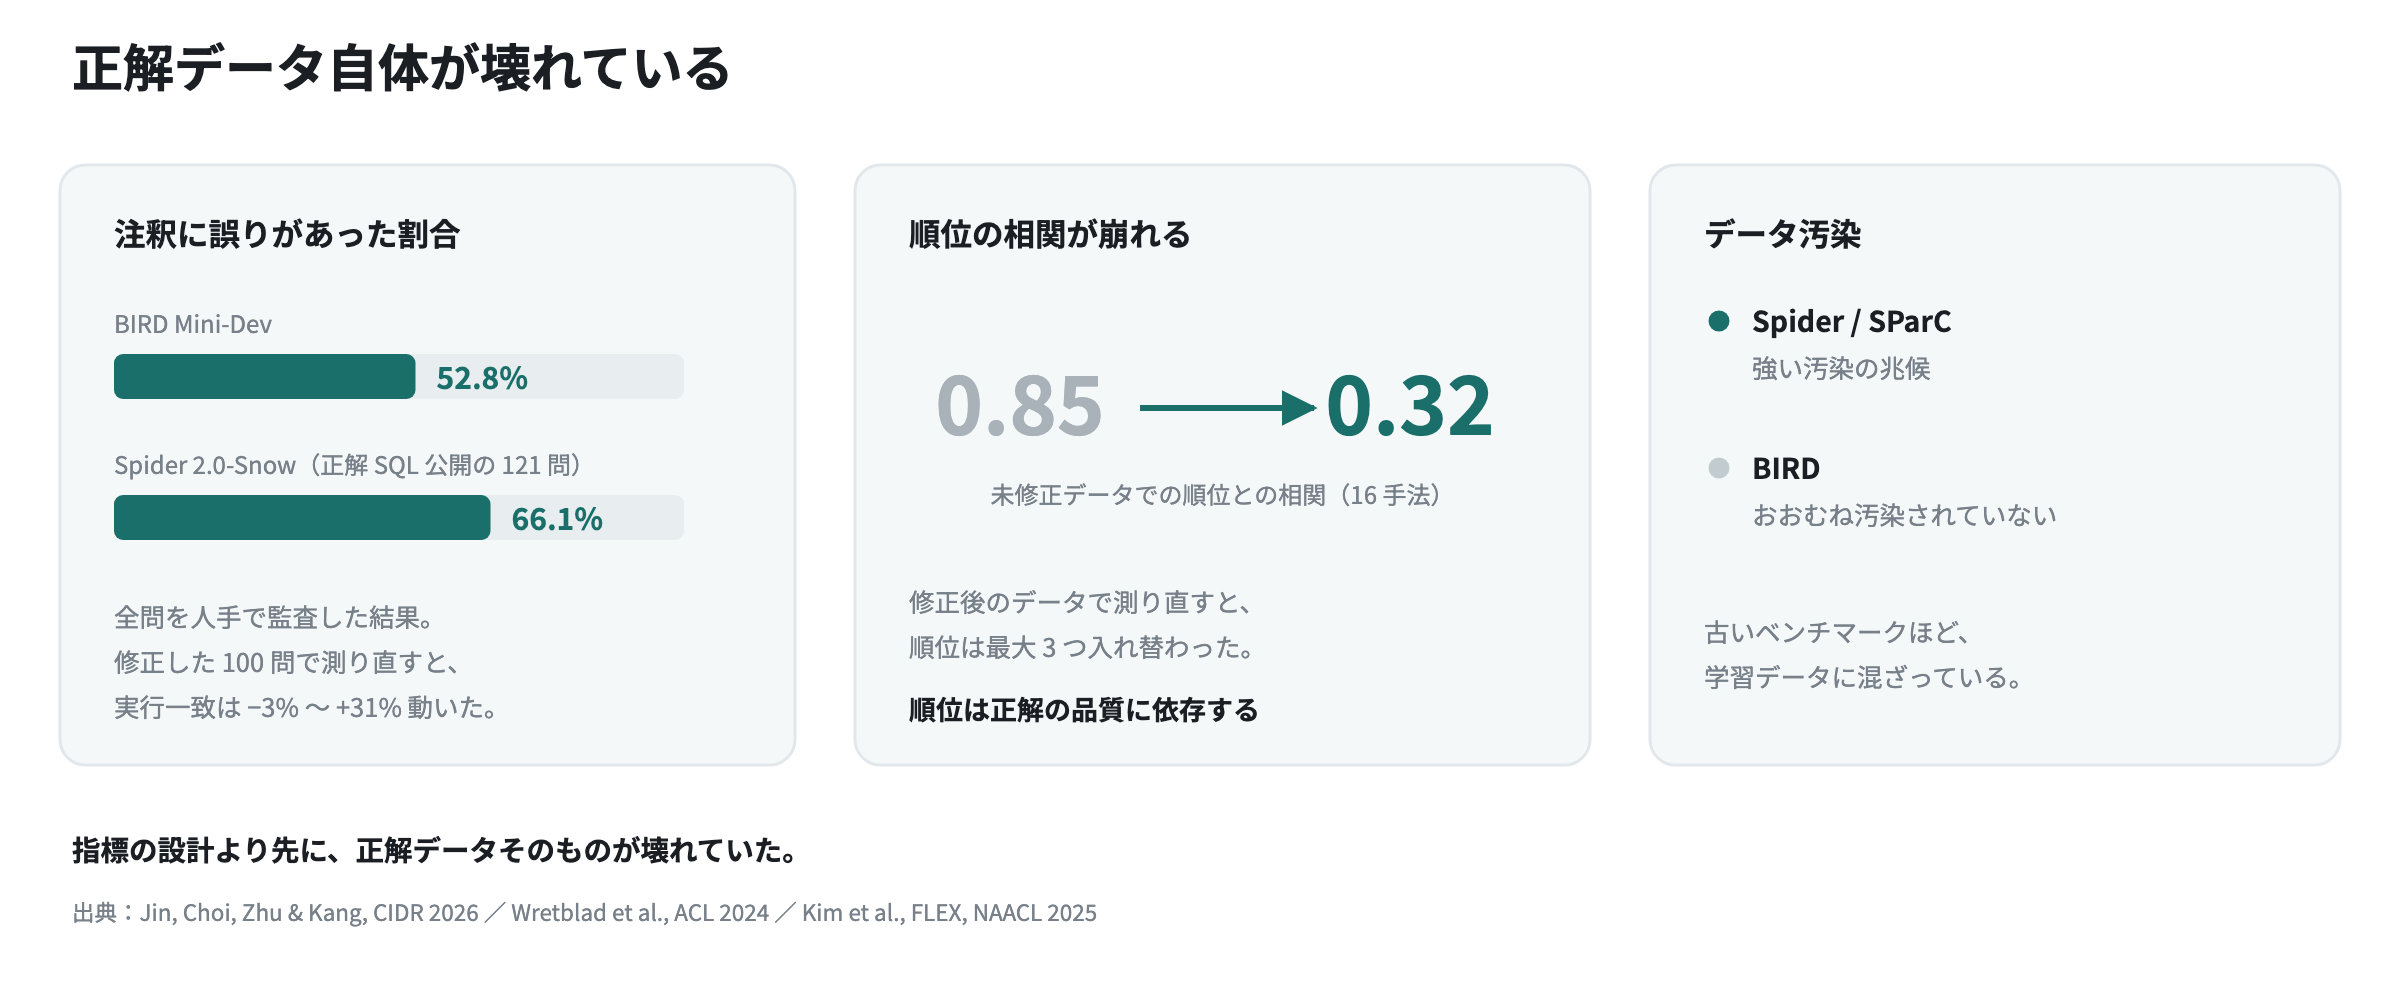
Wretblad らは BIRD の質問と正解クエリにノイズが広く存在することを示し、正解を修正して測り直すと、素朴な zero-shot が高度なプロンプト手法を上回るという順位の逆転が起きると報告しました(ACL 2024)。FLEX(NAACL 2025)は、実行一致と専門家の判断の一致度(Cohen の κ)を 62 から 87.04 に改善したうえで、モデルが過小評価される主因は注釈の品質にあると結論づけています。
要するに、リーダーボードの順位は、正解データの品質という別の変数に強く依存しています。
6. 現在地
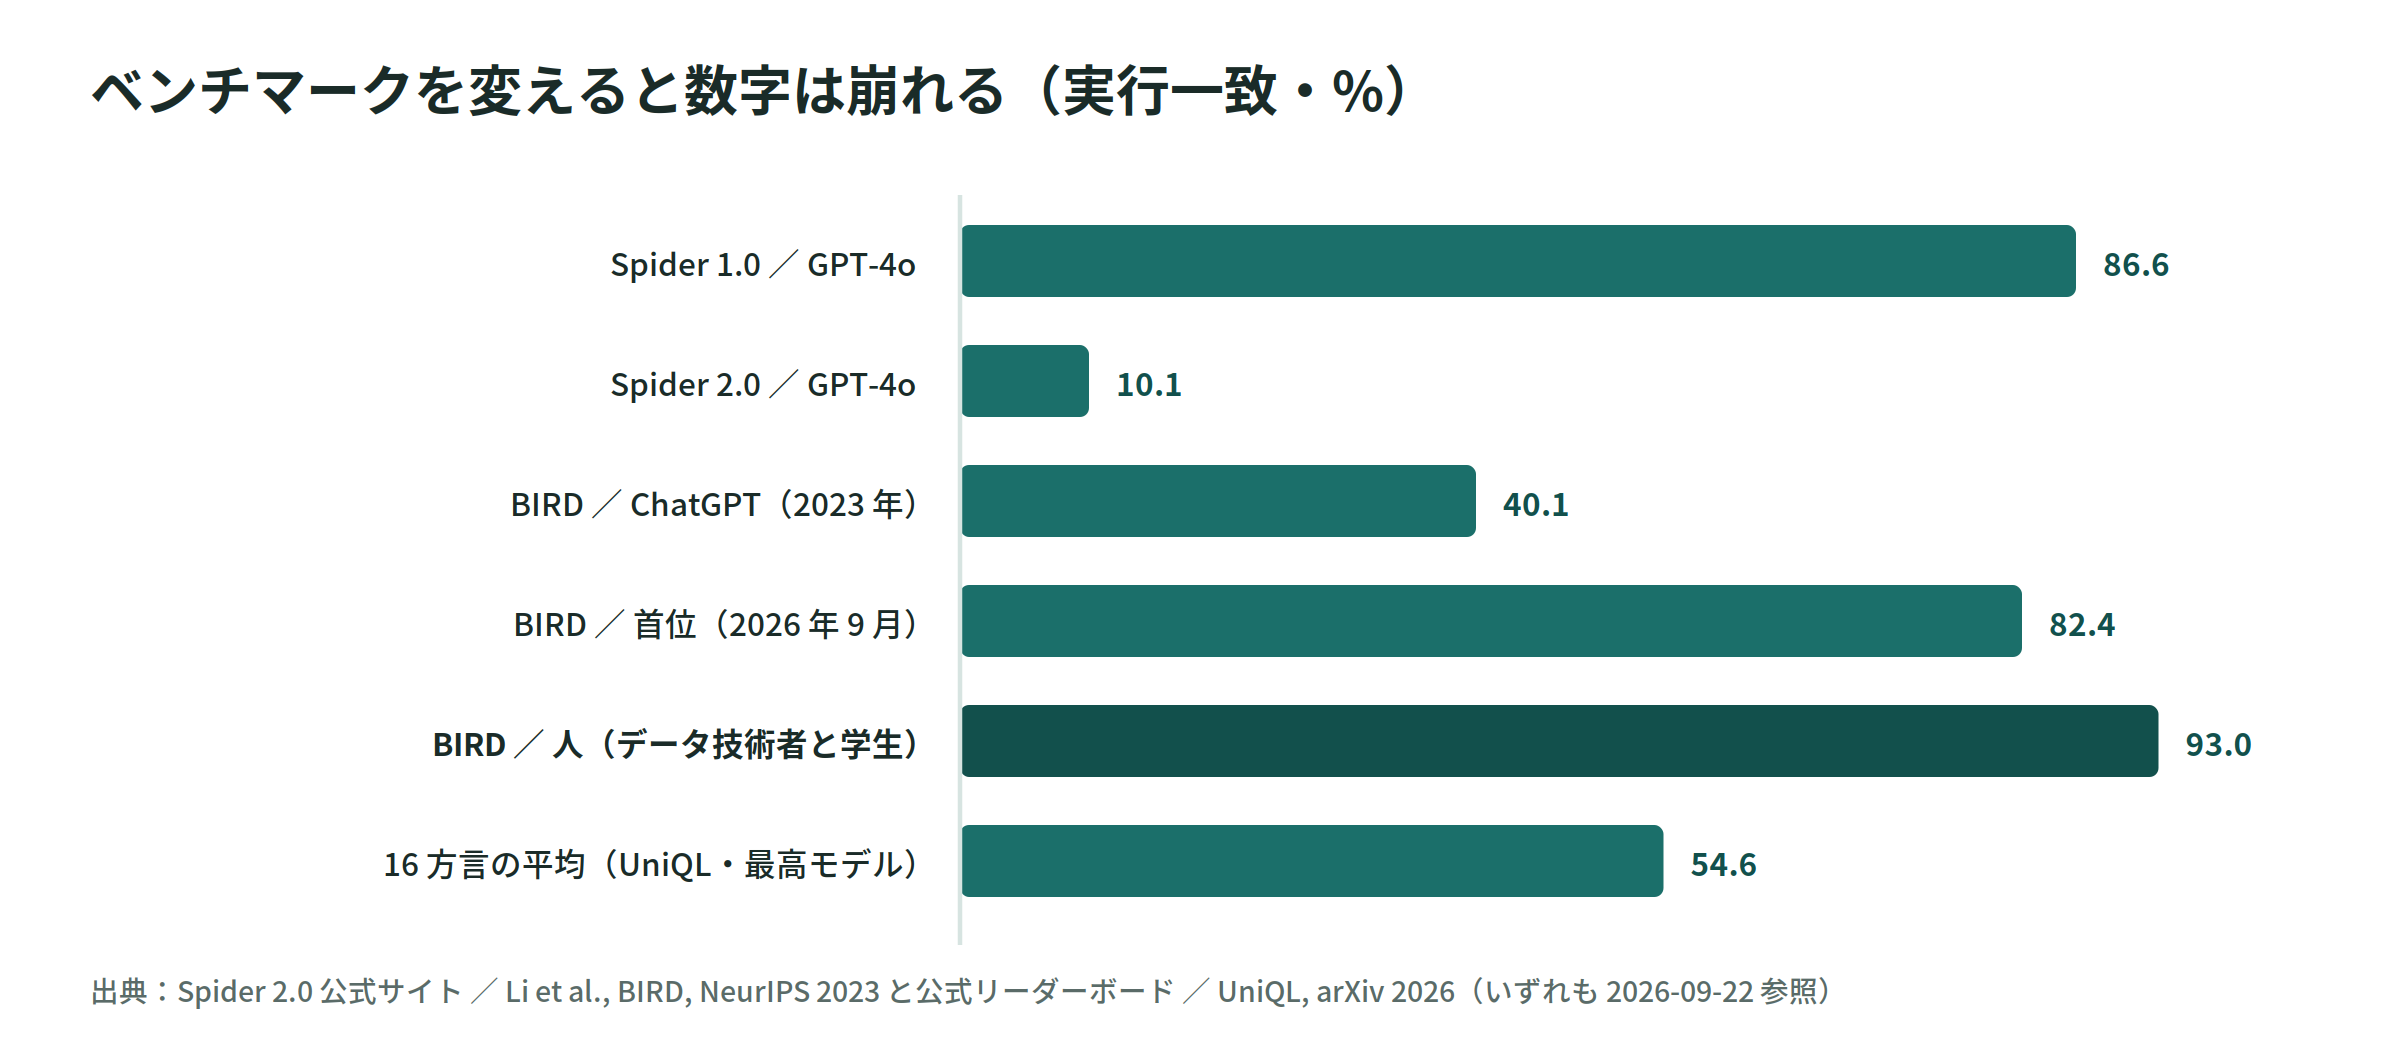
Spider 2.0 の公式サイトによれば、Spider 1.0 で 86.6% を出した GPT-4o が、Spider 2.0 では 10.1% しか解けません。論文(ICLR 2025)でも、o1-preview を用いたコードエージェントの成功率は 21.3% にとどまります。ベンチマークは解かれたが、問題は解かれていない、という状態です。
BIRD では、2023 年時点で 40.08% だった実行一致が、2026 年 9 月の公式リーダーボード首位で 82.39% まで伸びました。それでも、同ベンチマークが公表する人(データ技術者と学生)の水準 92.96% には約 10 ポイント届いておらず、直近 1 年の伸びは 1 ポイント程度です。Spider 2.0 のリーダーボードにはこれを大きく上回る数値も並んでいますが、検証手順が公開されておらず、前章の注釈エラー率と同じ問題集合であるため、額面どおりには扱えません。再現できる基準点としては、論文が報告した 21.3% を見るのが安全です。
7. 自分のデータで測るための作法
公開ベンチマークの数字は、自分のデータでの精度ではありません。実務で使うなら、規模が小さくても自前の評価セットを作るのが唯一の方法です。最低限、次の四つを決めます。
8. まとめ
- Text-to-SQL は質問・スキーマ・外部知識を入力に SQL を出力するタスクで、意味解析の一分野にあたる
- 60 年の系譜の中心にあるのは一貫して「新しいデータベースにそのまま移せるか」という問いで、1995 年の移植性、2018 年の未知スキーマ、2023 年の業務知識、2025 年の企業規模と形を変えて現れ続けている
- 難所は語彙・値・曖昧さ・知識の四つの溝に、方言と規模が重なる形で整理できる
- 評価指標は「字面を見る」と「実行結果を見る」の往復として発展し、含意関係の中で、いま最も使われる指標が最も緩いことが分かっている
- 2024 年以降、正解データ自体の注釈誤り(BIRD Mini-Dev で 52.8%)とデータ汚染が明らかになり、リーダーボードの順位は正解品質に強く依存する
- 公開ベンチマークの数字は自分のデータの精度ではない。小さくても自前の評価セットを作る
次のステップ
連載本編では、この技術を実際に動かす側を扱います。Part 2 では用語辞書とツール定義を作り、生成された SQL を実行前に機械的に検査する仕組みを、Part 3 では自前の評価セットで精度を測る工程を扱います。
出典
- Androutsopoulos, Ritchie & Thanisch. Natural Language Interfaces to Databases – An Introduction. Natural Language Engineering 1(1), 1995. https://arxiv.org/abs/cmp-lg/9503016
- Woods, Kaplan & Nash-Webber. The Lunar Sciences Natural Language Information System. BBN Report 2378, 1972.
- Warren & Pereira. An Efficient Easily Adaptable System for Interpreting Natural Language Queries. American Journal of Computational Linguistics 8(3-4), 1982. https://aclanthology.org/J82-3002/
- Bates, Boisen & Makhoul. Developing an Evaluation Methodology for Spoken Language Systems. HLT Workshop, 1990. https://aclanthology.org/H90-1022/
- Hemphill, Godfrey & Doddington. The ATIS Spoken Language Systems Pilot Corpus. HLT Workshop, 1990. https://aclanthology.org/H90-1021/
- Zelle & Mooney. Learning to Parse Database Queries Using Inductive Logic Programming. AAAI-96, 1996. https://cdn.aaai.org/AAAI/1996/AAAI96-156.pdf
- Popescu, Etzioni & Kautz. Towards a Theory of Natural Language Interfaces to Databases. IUI 2003. https://turing.cs.washington.edu/papers/nli-iui03.pdf
- Li & Jagadish. Constructing an Interactive Natural Language Interface for Relational Databases. PVLDB 8(1), 2014. https://dl.acm.org/doi/10.14778/2735461.2735468
- Zhong, Xiong & Socher. Seq2SQL: Generating Structured Queries from Natural Language using Reinforcement Learning. arXiv:1709.00103, 2017. https://arxiv.org/abs/1709.00103
- Yu et al. Spider: A Large-Scale Human-Labeled Dataset for Complex and Cross-Domain Semantic Parsing and Text-to-SQL Task. EMNLP 2018. https://aclanthology.org/D18-1425/
- Wang et al. RAT-SQL: Relation-Aware Schema Encoding and Linking for Text-to-SQL Parsers. ACL 2020. https://aclanthology.org/2020.acl-main.677/
- Zhong, Yu & Klein. Semantic Evaluation for Text-to-SQL with Distilled Test Suites. EMNLP 2020. https://aclanthology.org/2020.emnlp-main.29/
- Scholak, Schucher & Bahdanau. PICARD: Parsing Incrementally for Constrained Auto-Regressive Decoding from Language Models. EMNLP 2021. https://aclanthology.org/2021.emnlp-main.779/
- Rajkumar, Li & Bahdanau. Evaluating the Text-to-SQL Capabilities of Large Language Models. arXiv:2204.00498, 2022. https://arxiv.org/abs/2204.00498
- Li et al. Can LLM Already Serve as A Database Interface? A BIg Bench for Large-Scale Database Grounded Text-to-SQLs (BIRD). NeurIPS 2023 Datasets & Benchmarks. https://arxiv.org/abs/2305.03111
- Bhaskar et al. Benchmarking and Improving Text-to-SQL Generation under Ambiguity (AmbiQT). EMNLP 2023. https://aclanthology.org/2023.emnlp-main.436/
- Wretblad et al. Understanding the Effects of Noise in Text-to-SQL: An Examination of the BIRD-Bench Benchmark. ACL 2024. https://aclanthology.org/2024.acl-short.34/
- Ranaldi et al. Investigating the Impact of Data Contamination of Large Language Models in Text-to-SQL translation. Findings of ACL 2024. https://aclanthology.org/2024.findings-acl.827/
- Lei et al. Spider 2.0: Evaluating Language Models on Real-World Enterprise Text-to-SQL Workflows. ICLR 2025. https://arxiv.org/abs/2411.07763
- Kim et al. FLEX: Expert-level False-Less EXecution Metric for Reliable Text-to-SQL Benchmark. NAACL 2025. https://aclanthology.org/2025.naacl-long.228/
- Jin, Choi, Zhu & Kang. Text-to-SQL Benchmarks are Broken: An In-Depth Analysis of Annotation Errors. CIDR 2026. https://www.vldb.org/cidrdb/papers/2026/p5-jin.pdf
- Koukouvinis, Katsogiannis-Meimarakis & Koutrika. Comparison and Analysis of Value Linking in Text-to-SQL Systems. PACMMOD 4(3), 2026. https://doi.org/10.1145/3802029
- Gao et al. UniQL: Towards Dialect-Universal Benchmarking for Text-to-SQL. arXiv:2606.08018, 2026. https://arxiv.org/abs/2606.08018
- BIRD 公式リーダーボード https://bird-bench.github.io/ / Spider 2.0 公式リーダーボード https://spider2-sql.github.io/(いずれも 2026-09-22 参照)
コードは GitHub で公開しています: github.com/HerzLeben/medicare-partd-text-to-sql