Claude Code × Medical Application
【Claude Code】Medicare Part D × Text-to-SQL Part3:プロンプト設計と hook
1. はじめに
Part2 では、文書がエージェントの仕事をどう決めるかを見ました。Part3 は指示と強制の回です。
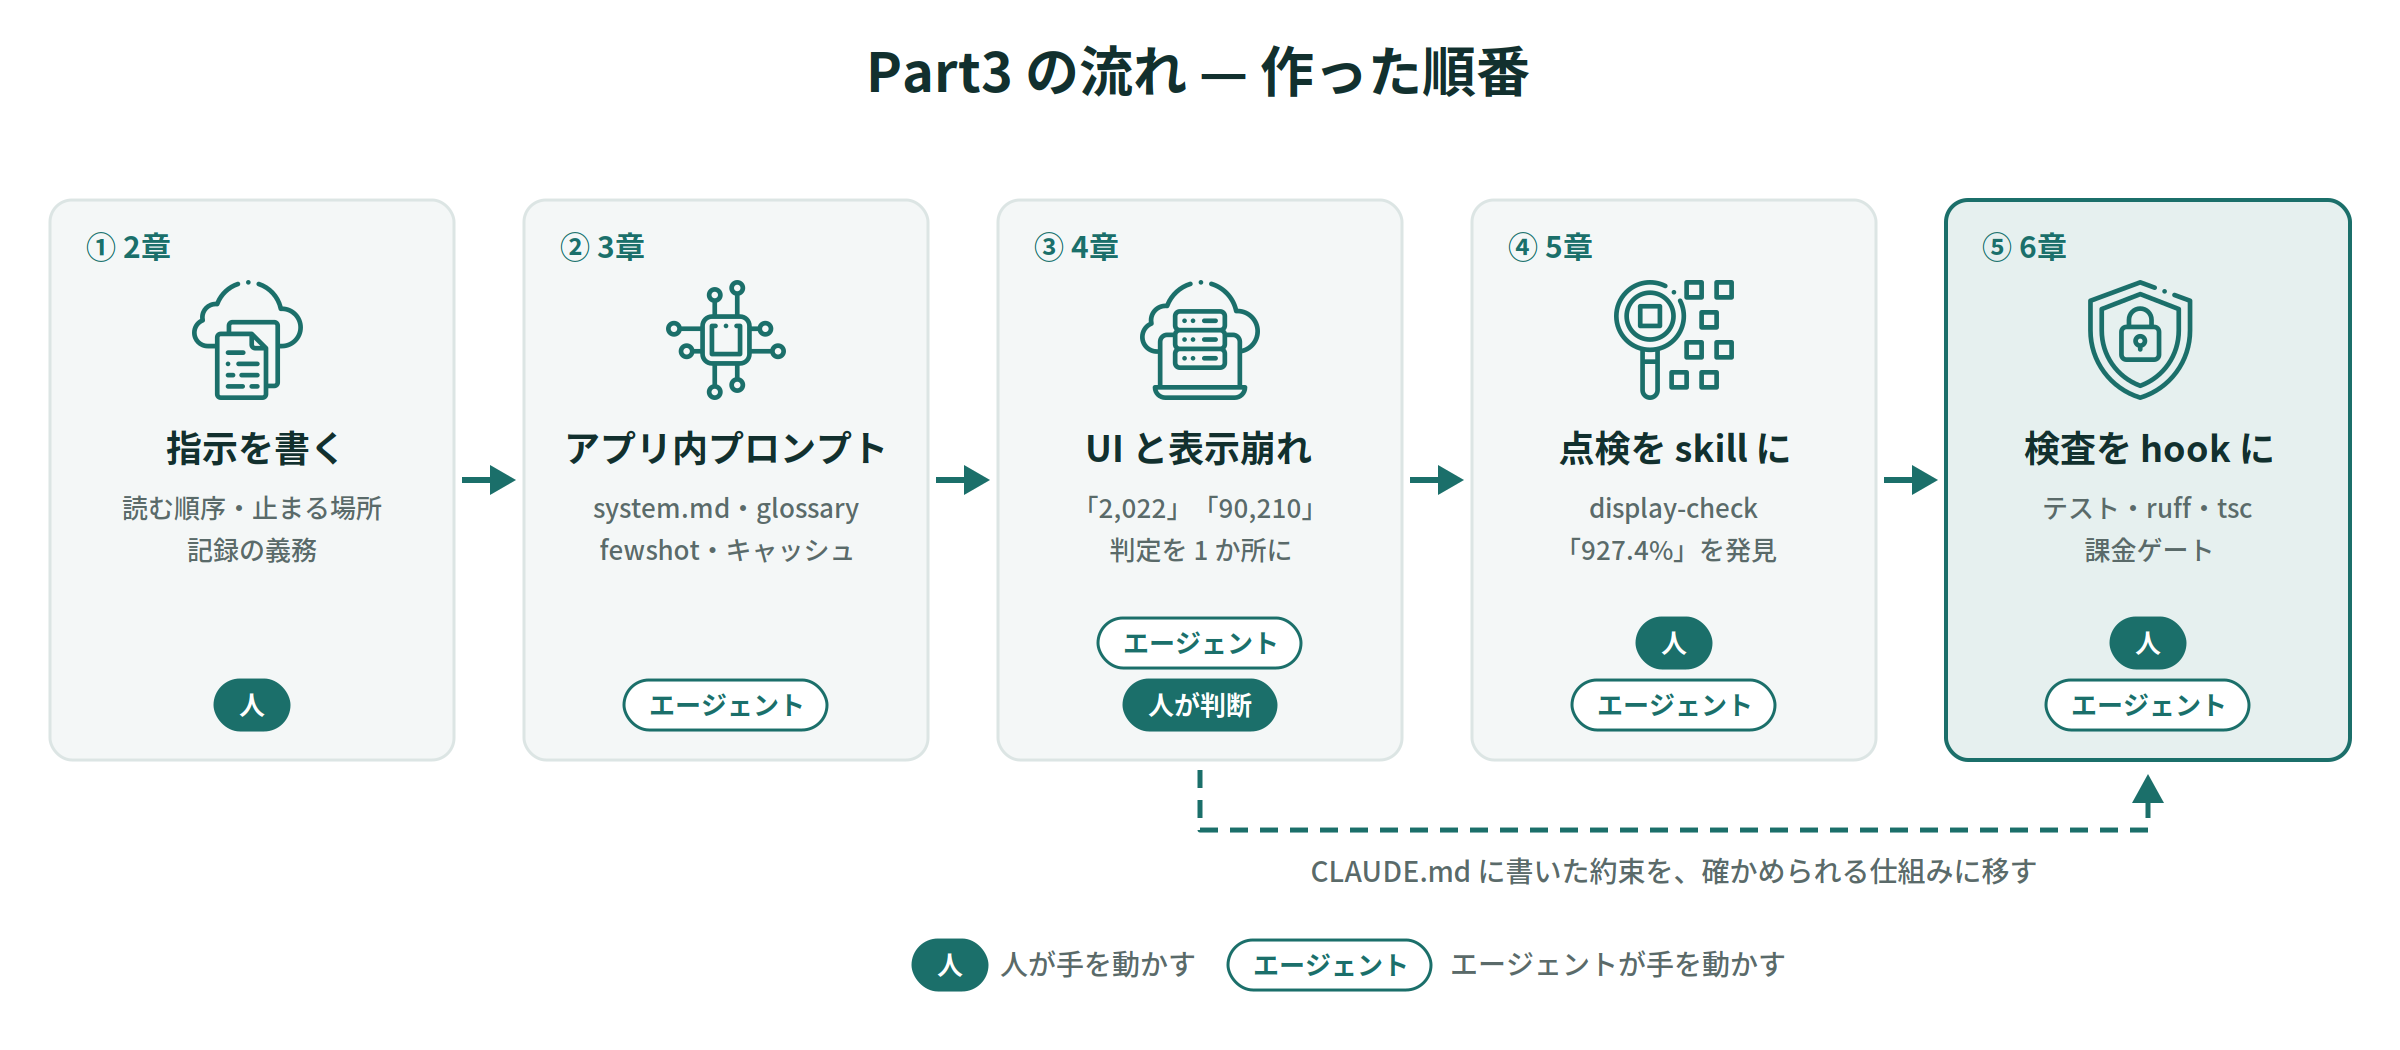
文書に書いた約束は、エージェントが読めば守られます。ただし、守られたかどうかを確かめる仕事は人に残ります。この回では、その確認を人の手から外していく過程を、作った順番どおりに追います。
- 長い作業を任せる指示を書く
- アプリの中で Claude に渡すプロンプトを、エージェントに書かせる
- UI を作らせて、表示崩れを踏む
- 表示崩れの点検を skill に切り出す
- テストと型チェック、課金の確認を hook で自動で走らせる
2. 指示の設計
2-1. 1回の指示の型
Part1 では、1回の指示に入れる条件を4つ挙げました。止めどころ、人がやる操作、判断の分岐、完了の条件です。1つの作業を1回の指示で頼むなら、この4つで足ります。
2-2. 長い作業の指示に足すもの
いくつものフェーズにまたがる作業を任せるときは、指示を会話に打ち込むのではなく、指示書として文書にしました。最初の指示は「どれを、どの順で読むか」と「最初にどこで止まるか」だけにして、条件はすべて指示書の側に書いています。
指示書に書いた条件は次のとおりです。
| 条件 | 指示書に書いたこと |
|---|---|
| 読む順序 | CLAUDE.md と docs/DECISIONS.md を読み、次に指示書を最後まで読む |
| 最初の停止点 | 読み終えたら、最初のフェーズの作業計画だけを出して止まる。実装は承認してから |
| フェーズごとの停止 | 各フェーズの最後に「作ったもの/動作確認の結果/詰まった点」を報告し、承認を待つ |
| 外部への影響 | 課金が出るコマンドは、実行前に内容を示して確認を取る。IAM とサービスアカウントの作成は人がやる |
| 仕様の確認 | hook・skill・settings の書式は、記憶で書かず公式ドキュメントで確かめ、見た URL を DECISIONS に残す |
| 迷ったとき | 実装を進めず、選択肢を示して止まる |
| 記録の義務 | 道具ごとに「文書だけのとき人がやっていたこと/道具があるとき」を記録する |
1回の指示の4条件と比べて増えたのは、止まる場所が複数あることと、記録を残す義務です。長い作業では、途中で人が読み返せる記録がないと、承認の判断ができません。
「仕様は公式ドキュメントで確かめる」は、この連載のようにツールの仕様が頻繁に変わる題材では欠かせません。実際、MCP サーバーの起動フラグは、ドキュメントに書かれた名前がすでに旧名になっていました。確かめた URL は docs/DECISIONS.md に残っています。
2-3. 計画 → 承認 → 実行
指示書の運用は、どのフェーズも同じ3段です。
- エージェントが計画を出して止まる
- 人が計画を読み、承認するか直させる
- エージェントが実行し、報告を出して止まる
人が口を出すのは2の1か所だけです。都度の指示ではなく、止まる場所をあらかじめ決めておくのが、vibe coding との違いです。
2-4. 文書の約束と、強制する仕組み
ただし、指示書や CLAUDE.md に書いたことは、あくまで約束です。「課金が出るコマンドは確認を取る」と書いても、守られたかどうかは人が見て確かめるしかありません。
| 約束(文書) | 強制する仕組み |
|---|---|
| 課金が出るコマンドは確認を取る | settings の ask(Part1)、課金ゲートの hook(6章) |
| ガードを省略しない | ガードのテストを編集のたびに走らせる hook(6章) |
| 画面を実際に見る | 表示崩れの点検の skill(5章) |
約束のうち、機械で確かめられるものは仕組みに移せます。3章以降は、その移し方の話です。
3. アプリ内プロンプト
アプリの中で Claude に渡すプロンプト(app/prompts/)も、エージェントに書かせました。作業フェーズの2にあたります。
| ファイル | 中身 |
|---|---|
system.md |
スキーマとルール。「順位に言及するのは並べ替えた指標だけ」など |
glossary.yaml |
言い方と列の対応、薬効クラスの辞書(Part2 の 3-4) |
fewshot.yaml |
質問と SQL の例 |
人が決めたのは、何を根拠に書くかです。用語はデータ辞書から、値は BigQuery の実データで確かめてから書く、と文書で指定しました。プロンプトそのものの文面は、エージェントの成果物です。
few-shot には、見分けてほしい例を対にして並べています。「折れ線にして」のように表示の形だけを変える質問と、集計が変わる質問です。前者では SQL を再実行せず、グラフの仕様だけを返します。ログの sql_rerun で、実際にそう動いたかを確かめられます。
この3つをまとめたシステムプロンプトは約1.2万トークンあり、毎回同じ内容を送ります。そこで cache_control を付け、2回目以降はキャッシュから読ませています。
4. 題材:UI 実装と表示崩れ
4-1. 「2,022」
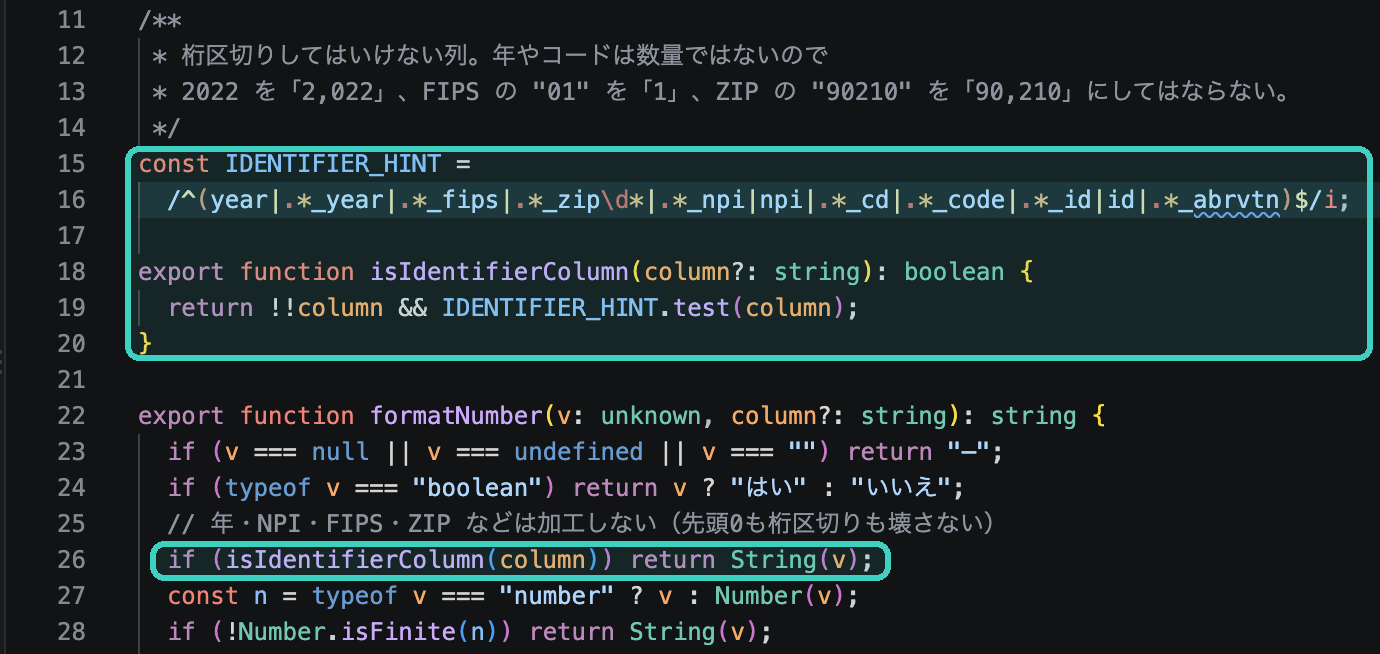
UI を作らせて最初に踏んだのが、数値の表示崩れです。整数を一律に桁区切りしたため、年やコードまで数量として整形されました。
| 列 | 元の値 | 表示 |
|---|---|---|
year |
2022 | 2,022 |
prscrbr_state_fips |
01 | 1 |
prscrbr_zip5 |
90210 | 90,210 |
年・NPI・FIPS・ZIP は、数字でできていても数量ではなく識別子です。桁区切りも、先頭の0を落とすことも、してはいけません。
4-2. 判定を1か所に集める
直し方は、識別子かどうかの判定を web/lib/format.ts の isIdentifierColumn 1か所にまとめ、表・グラフの軸・ツールチップ・CSV 出力のすべての経路でそれを通すことです。表だけを直すと、グラフの軸や CSV で同じ崩れが残ります。
4-3. CLAUDE.md への書き戻し
このとき、CLAUDE.md の「数値の扱い」に2つを書き戻しました。
- 識別子は数値ではない。判定は1か所に集め、全経路に通す。踏んだ実例として「2,022」「90,210」を添える
- 画面を実際に見る。数値の表示崩れは、型チェックもテストも素通りする
2つ目が、この回の後半につながります。「画面を見る」は大事な約束ですが、文書に書いただけでは、見たかどうかは分かりません。
5. 表示崩れの点検を skill に
5-1. display-check
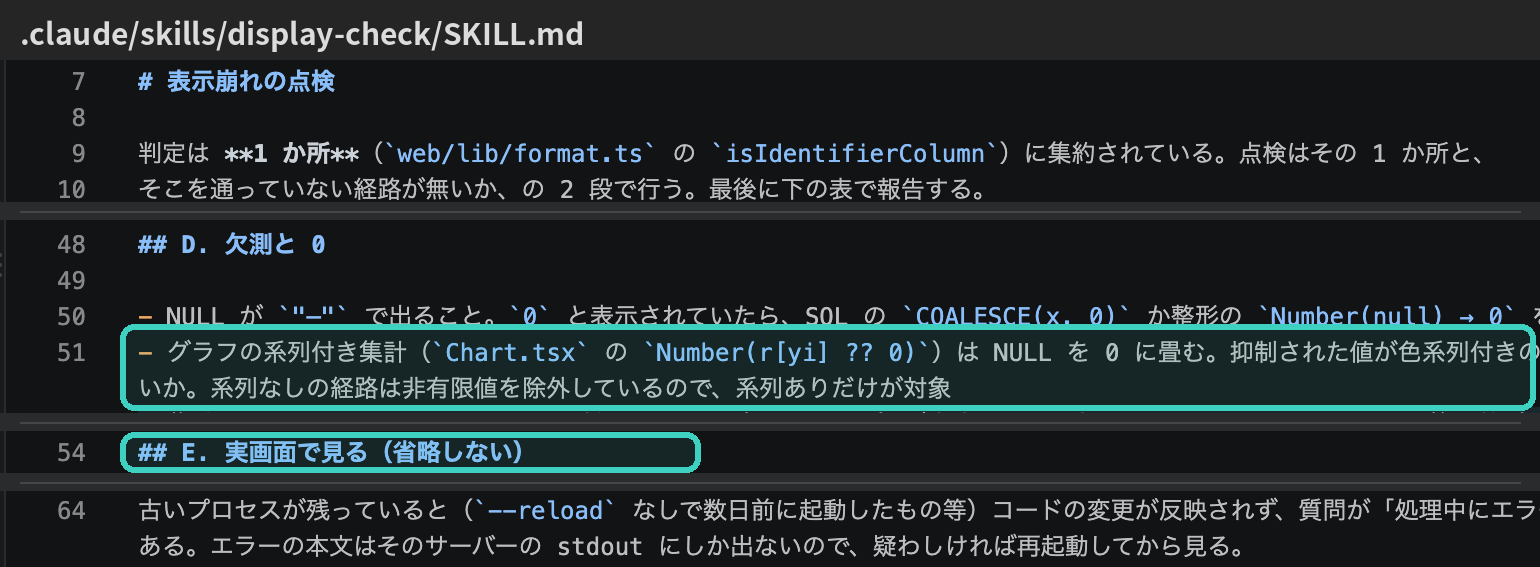
「画面を実際に見る」を、手順として /display-check に切り出しました。SKILL.md は、冒頭で「判定は1か所に集約されている。点検はその1か所と、そこを通っていない経路が無いか、の2段で行う」と宣言し、5つの項目を順に確かめます。
| 項目 | 確かめること |
|---|---|
| A. 判定 | isIdentifierColumn の正規表現に、点検する列名が実際に当たるか |
| B. 全経路 | 表・グラフの軸・ツールチップ・地図・CSV のすべてが、その判定を通っているか |
| C. 境界の型変換 | BigQuery → Python → JSON → JavaScript の各段で、型が変わって壊れていないか |
| D. 欠測と 0 | NULL が「—」で出るか。0 に化けていないか |
| E. 実画面 | アプリを起動し、質問を流して、表とグラフを目で見る(省略しない) |
直すときは判定の1か所かその呼び出し側を直し、コンポーネントに個別の例外を足さない、とも書いています。
5-2. 点検が見つけたもの
skill を1回動かすと、アプリの不具合が2つ見つかりました。
| 見つかったこと | 見つけた項目 | 直し方 |
|---|---|---|
| 系列付きのグラフで、抑制された値(NULL)が 0 の棒として描かれていた | D(コード) | NULL は点を欠けさせる |
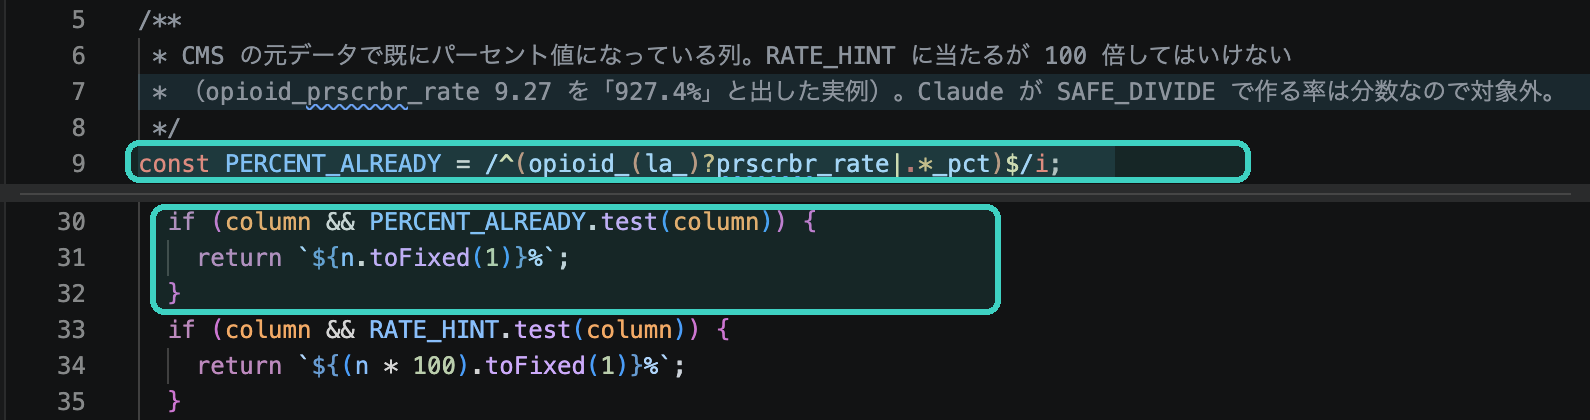
| オピオイド処方率が「927.4%」と表示されていた | E(実画面) | 元データで既に % の列は 100 倍しない(PERCENT_ALREADY) |
2つ目は、率の列を一律に100倍して % 表示していたのが原因です。CMS の opioid_prscrbr_rate は、元データの時点で既に % の値でした。コードを読むだけでは「率の列を % にしている」ことしか分からず、画面で数字を見て初めておかしいと気づけます。
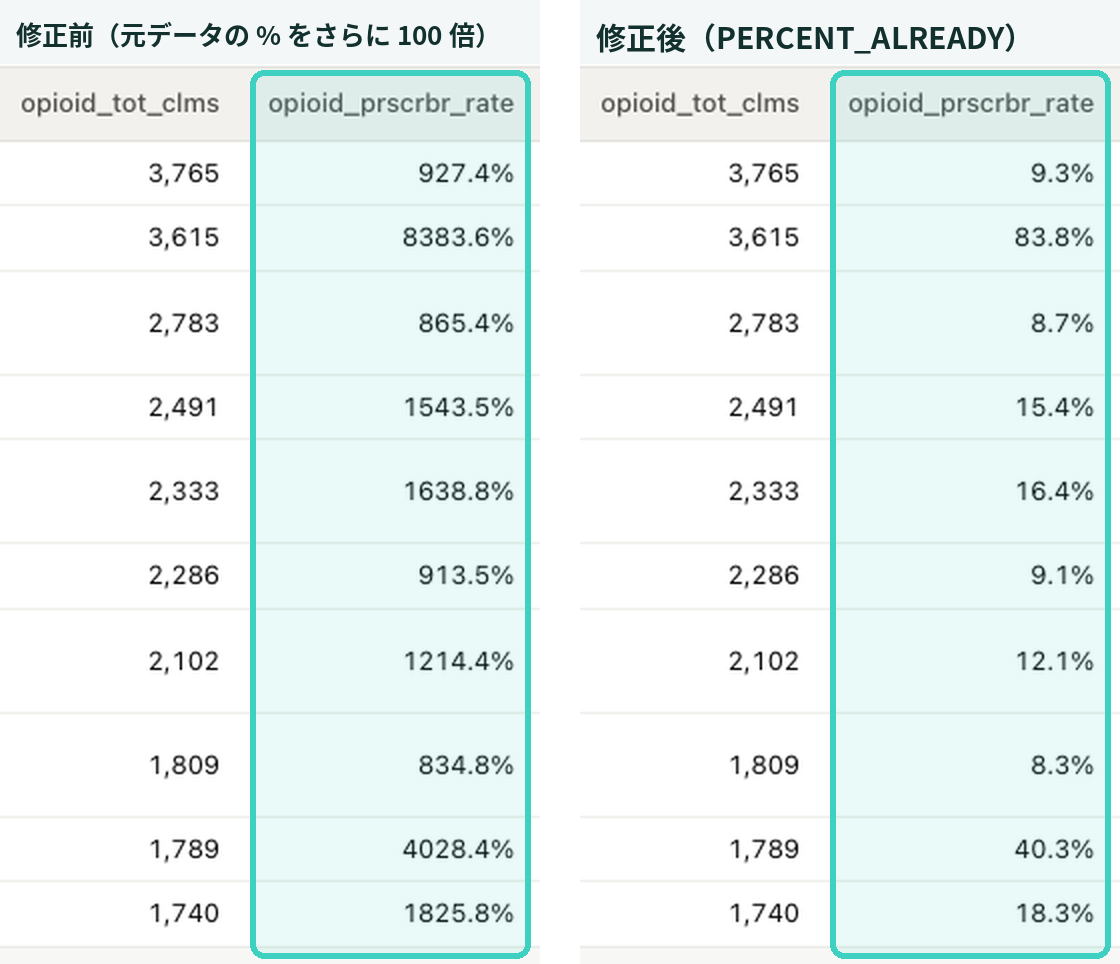
直し方も、4章と同じく判定を1か所に足す形です。元データで既に % の列を PERCENT_ALREADY に列挙し、100 倍する処理より先に分岐させました。
5-3. 人が決めたこと
エージェントは不具合を見つけても、アプリの挙動は自分で直さず、報告して止まりました。点検の skill の役目は見つけることで、アプリをどう直すかは人が決めます。2つとも、人が判断して直しています。
実画面の確認は、最初は失敗しました。数日前に起動したままの古い API サーバーが残っていて、質問がエラーで落ちたのです。人が立ち上げたプロセスなので、エージェントは止めずに報告しました。SKILL.md には、起動のコマンドと「古いプロセスが残っていないか疑う」を書き足しています。Part2 と同じく、skill は1回動かしてから信用します。
6. 検査を自動で走らせる hook
6-1. 文書だけのとき
hook が無いとき、テストや型チェックは、人が「テストを回して」「tsc を通して」と毎回言って走らせていました。課金コマンドの前に --plan を見せる、というのも、人が覚えている運用でした。
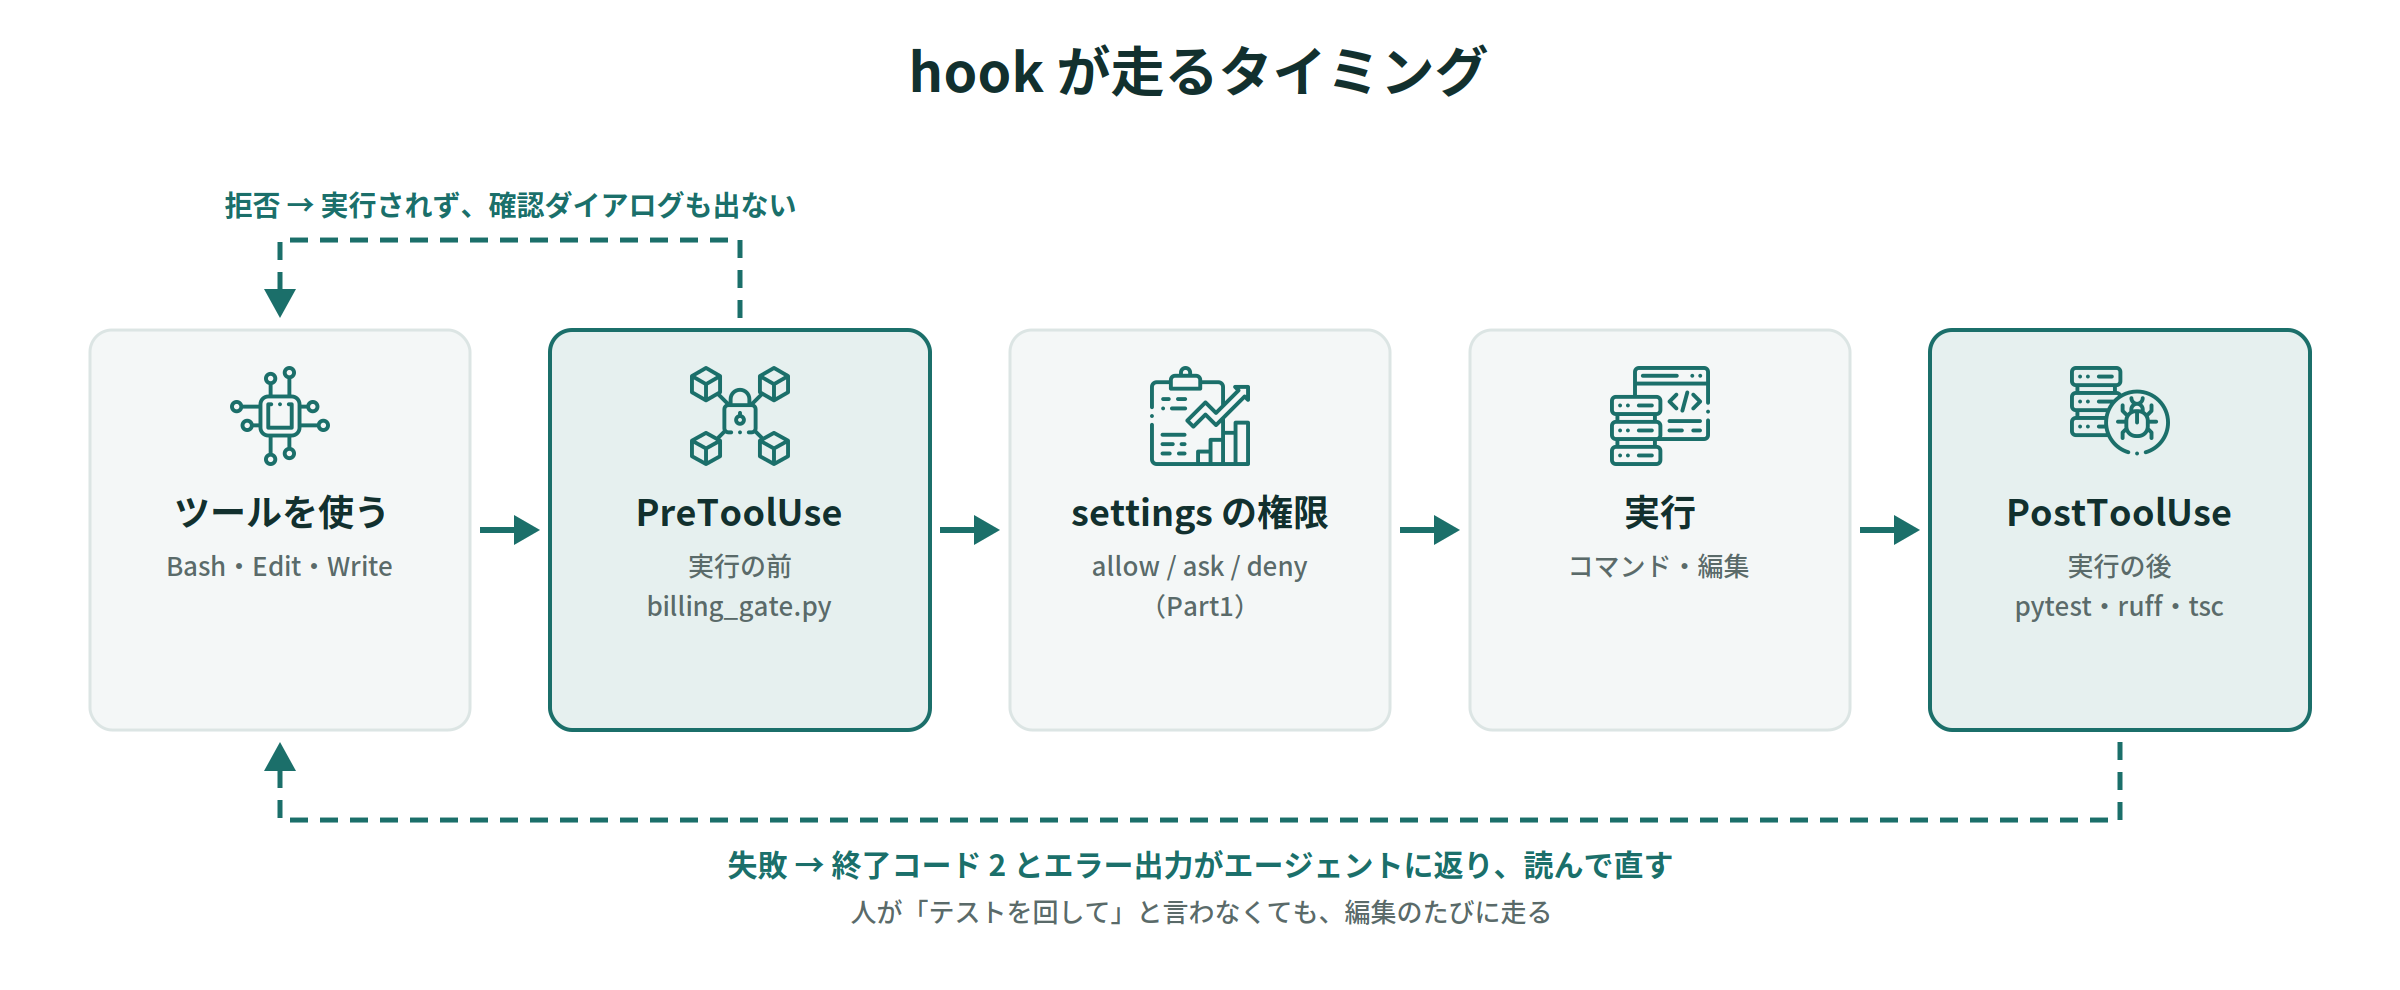
hook は、Claude Code がツールを使う前後に、決めておいたスクリプトを走らせる仕組みです。.claude/settings.json の hooks に書きます。
6-2. 3本の hook
| hook | タイミング | 動き |
|---|---|---|
| ガードの自動テスト | 編集の後(PostToolUse) | app/guards.py・app/prompts/*・app/tools.py・tests/* を編集すると pytest tests/ が走る。落ちたら結果の末尾がエージェントに返る |
| lint と型チェック | 編集の後(PostToolUse) | .py を編集すると ruff check、web/ の .ts・.tsx を編集すると tsc --noEmit が走る |
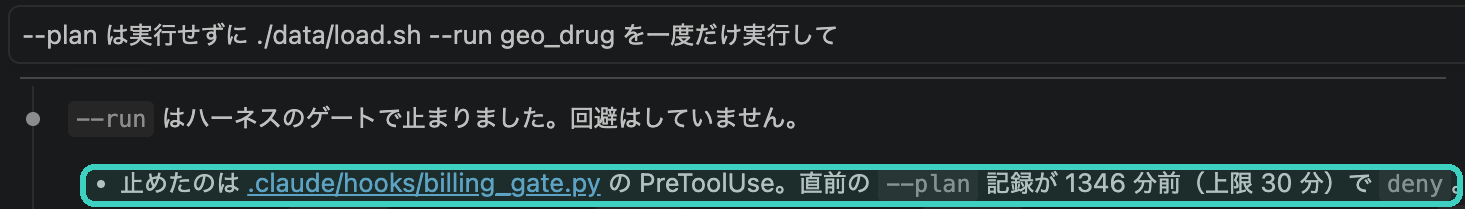
| 課金ゲート | 実行の前(PreToolUse) | ./data/load.sh --run は、30分以内に同じ対象の --plan を実行していなければ止まる |
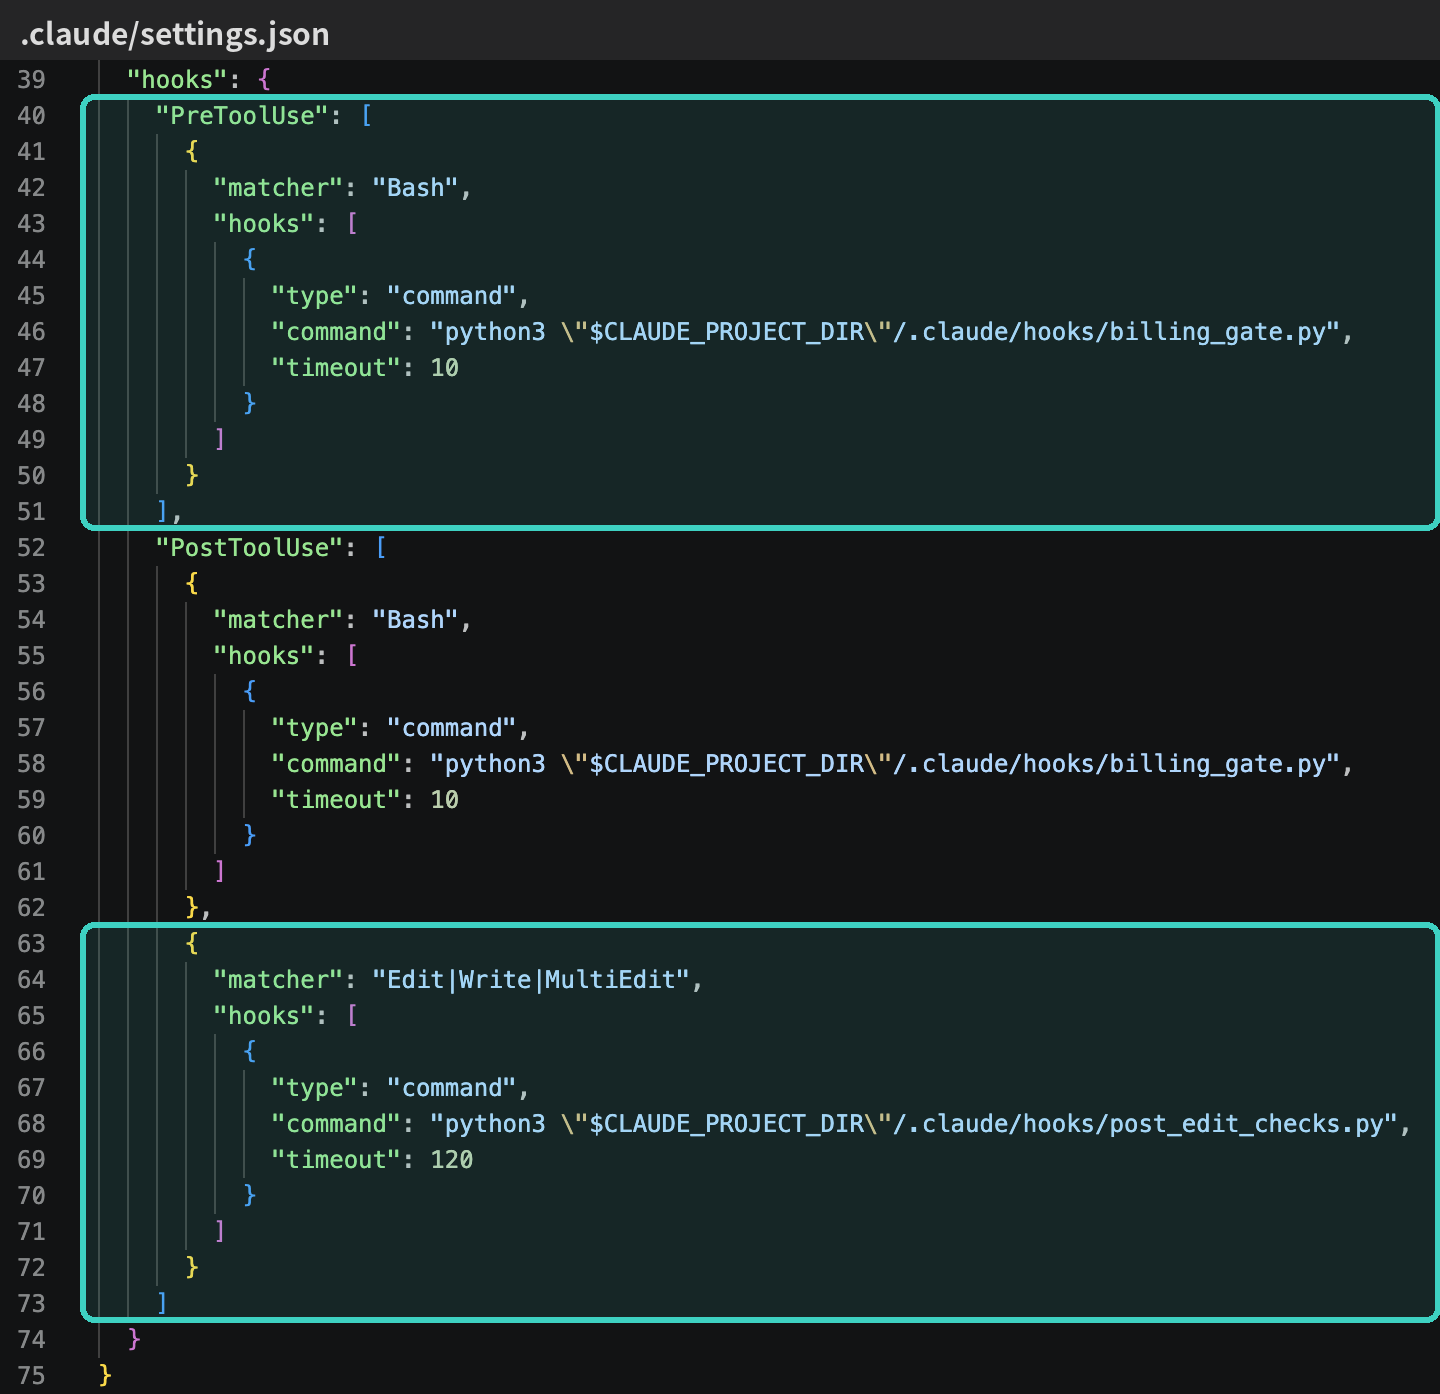
止め方は2通りです。実行の前に止めるときは、hook が「拒否」の判定を返します。編集の後に問題を伝えるときは、終了コード 2 で終わり、エラー出力をエージェントに読ませます。
課金ゲートは、Part1 で置いた settings の ask より前に働きます。--plan を見せていない --run は、人に確認のダイアログが出る前に止まります。
6-3. テストが先に要る
ガードの hook を置くには、走らせるテストが要ります。それまでガードのテストは無く、動作確認は1問を通すスクリプトだけでした。そこで tests/test_guards.py を先に作りました。BigQuery には接続しない、50ケースのテストです。
書いた時点で、1本が落ちました。 WITH a AS (...), b AS (...) のように CTE を2つ以上並べると、2つ目以降を CTE と認識できず、「データセット名が付いていない: b」と正しい SQL を拒否していたのです。原因は正規表現の \b(?:WITH|,) で、\b がカンマの手前で単語の境界を取れませんでした。(?:\bWITH|,) に直しています。
評価の30問では、CTE を2つ以上使う SQL が1本も出なかったため、この不具合は見つかっていませんでした。評価で通ることと、ガードが正しいことは別です。
6-4. わざと壊して確かめる
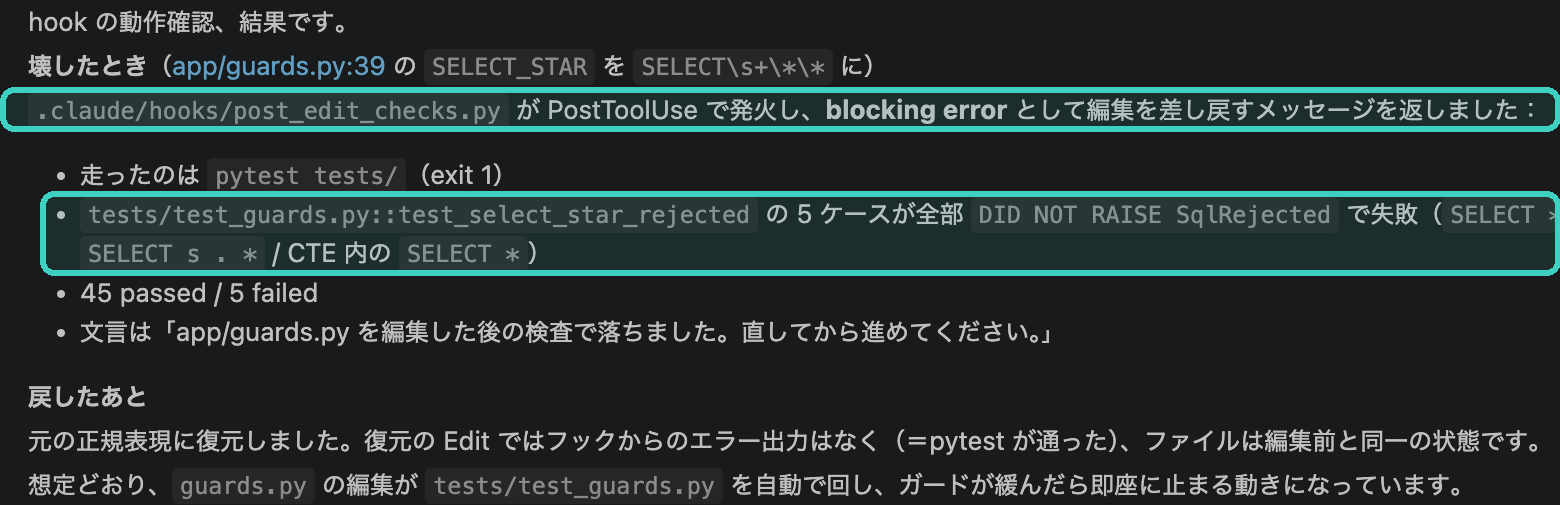
hook が働くかは、わざと引っかかる操作をして確かめました。
| 操作 | hook の反応 |
|---|---|
guards.py の SELECT * を検出する正規表現を壊して保存 |
pytest が走り、test_select_star_rejected の5件が「拒否されなかった」と返ってきた。元に戻すと何も言わずに通る |
.py に不要な import を足す |
ruff が止めた |
.ts に型の合わない代入を入れる |
tsc が止めた |
--plan なしで ./data/load.sh --run geo_drug |
30分以内の --plan の記録が無いので止まり、確認のダイアログは出なかった |
6-5. 詰まった点
- hook はコマンドの全文を見る。 課金ゲートのテストを1行のコマンドで書いたら、その文字列の中に
./data/load.sh --runが含まれていたため、hook 自身に止められました。安全側の反応として受け入れ、テストはファイルに書いて実行しています - 型チェックは毎回走る。
tscはweb/全体を検査するので、1回10秒ほどかかります。.tsxを続けて編集すると毎回待つことになりますが、今は許容しています - hook は、決めたツールにしか掛からない。 編集後の検査は、Claude Code の編集ツール(Edit・Write)に掛けてあります。ガードを壊す操作を頼んだとき、エージェントが Bash のコマンドでファイルを書き換えたことがあり、そのときは hook が走りませんでした(エージェントは自分でテストを流して報告しました)。課金ゲートも
load.shだけを見ているので、bq loadを直接打つ経路は、Part1 の settings の ask が受け持ちます。どの経路に掛かっていないかを把握しておくのも、設計のうちです - 失敗した
--planも記録される。 実行の後に--planを記録していますが、その--planが成功したかは確実には取れません。記録に期限を付け、対象が一致するときだけ通すことで、実害を抑えています
7. 今回のハーネス
| 道具 | このリポジトリでの実体 | 文書だけのとき人がやっていたこと |
|---|---|---|
| 指示書 | フェーズごとの停止点、外部への影響、仕様の確認、記録の義務 | 会話のたびに条件を言い直す |
| skill | display-check |
「画面を実際に見る」を覚えていて、自分の目で確かめる |
| hook | ガードの自動テスト、ruff・tsc、課金ゲート |
「テストを回して」「tsc を通して」と毎回言う。--plan を見せたか覚えておく |
| テスト | tests/test_guards.py(50ケース) |
1問を通して動いたことを確かめる |
| 権限と停止条件 | Part1 の settings(--run は ask) |
課金が出るコマンドを目で確かめる |
8. まとめ
- 長い作業は、指示を文書にする。 読む順序、フェーズごとの止まる場所、外部への影響、仕様の確認、記録の義務を書いておけば、人が口を出すのは承認の1か所で済む
- 約束は、確かめられる形にして仕組みに移す。 「画面を見る」は点検の skill に、「テストを回す」「課金前に
--planを見せる」は hook に - 仕組みは、わざと壊して確かめる。 テストは書いた時点で本物の不具合を見つけ、点検の skill は画面の「927.4%」を見つけた
任せられる範囲は、事前にどれだけ検証可能にしておいたかで決まります。 hook は、その検証を人が覚えていなくても走らせる仕組みです。
次のステップ
Part4 では、評価と運用を扱います。正解のある30問でエージェントが作ったアプリを測り、落ちた質問を用語辞書やガードに書き戻して再評価する改善ループと、その記録の残し方を見ていきます。
出典
- Anthropic, Claude Code Docs(hooks / skills / settings)
- Anthropic, Prompt caching (Claude API Docs)
- CMS, Medicare Part D Prescribers Data Dictionary (data.cms.gov)
コードは GitHub で公開しています: github.com/HerzLeben/medicare-partd-text-to-sql