Claude Code × Medical Application
【Claude Code】Medicare Part D × Text-to-SQL Part1:CSV を落として BigQuery に載せるまで
1. 概要
Part0 でアプリの全体像を見ました。この回は、その土台にあたるデータを実際に手元へ落とし、BigQuery に載せるまでを扱います。
読んで終わりにならないよう、コマンドと、そのとき出た数字と、踏んだ落とし穴をそのまま書きます。データそのものの解説(Medicare の仕組み、3つの表、抑制ルール、できないこと)は別ページに分けてあるので、必要なときにそちらを開いてください。
1-1. この回でやること
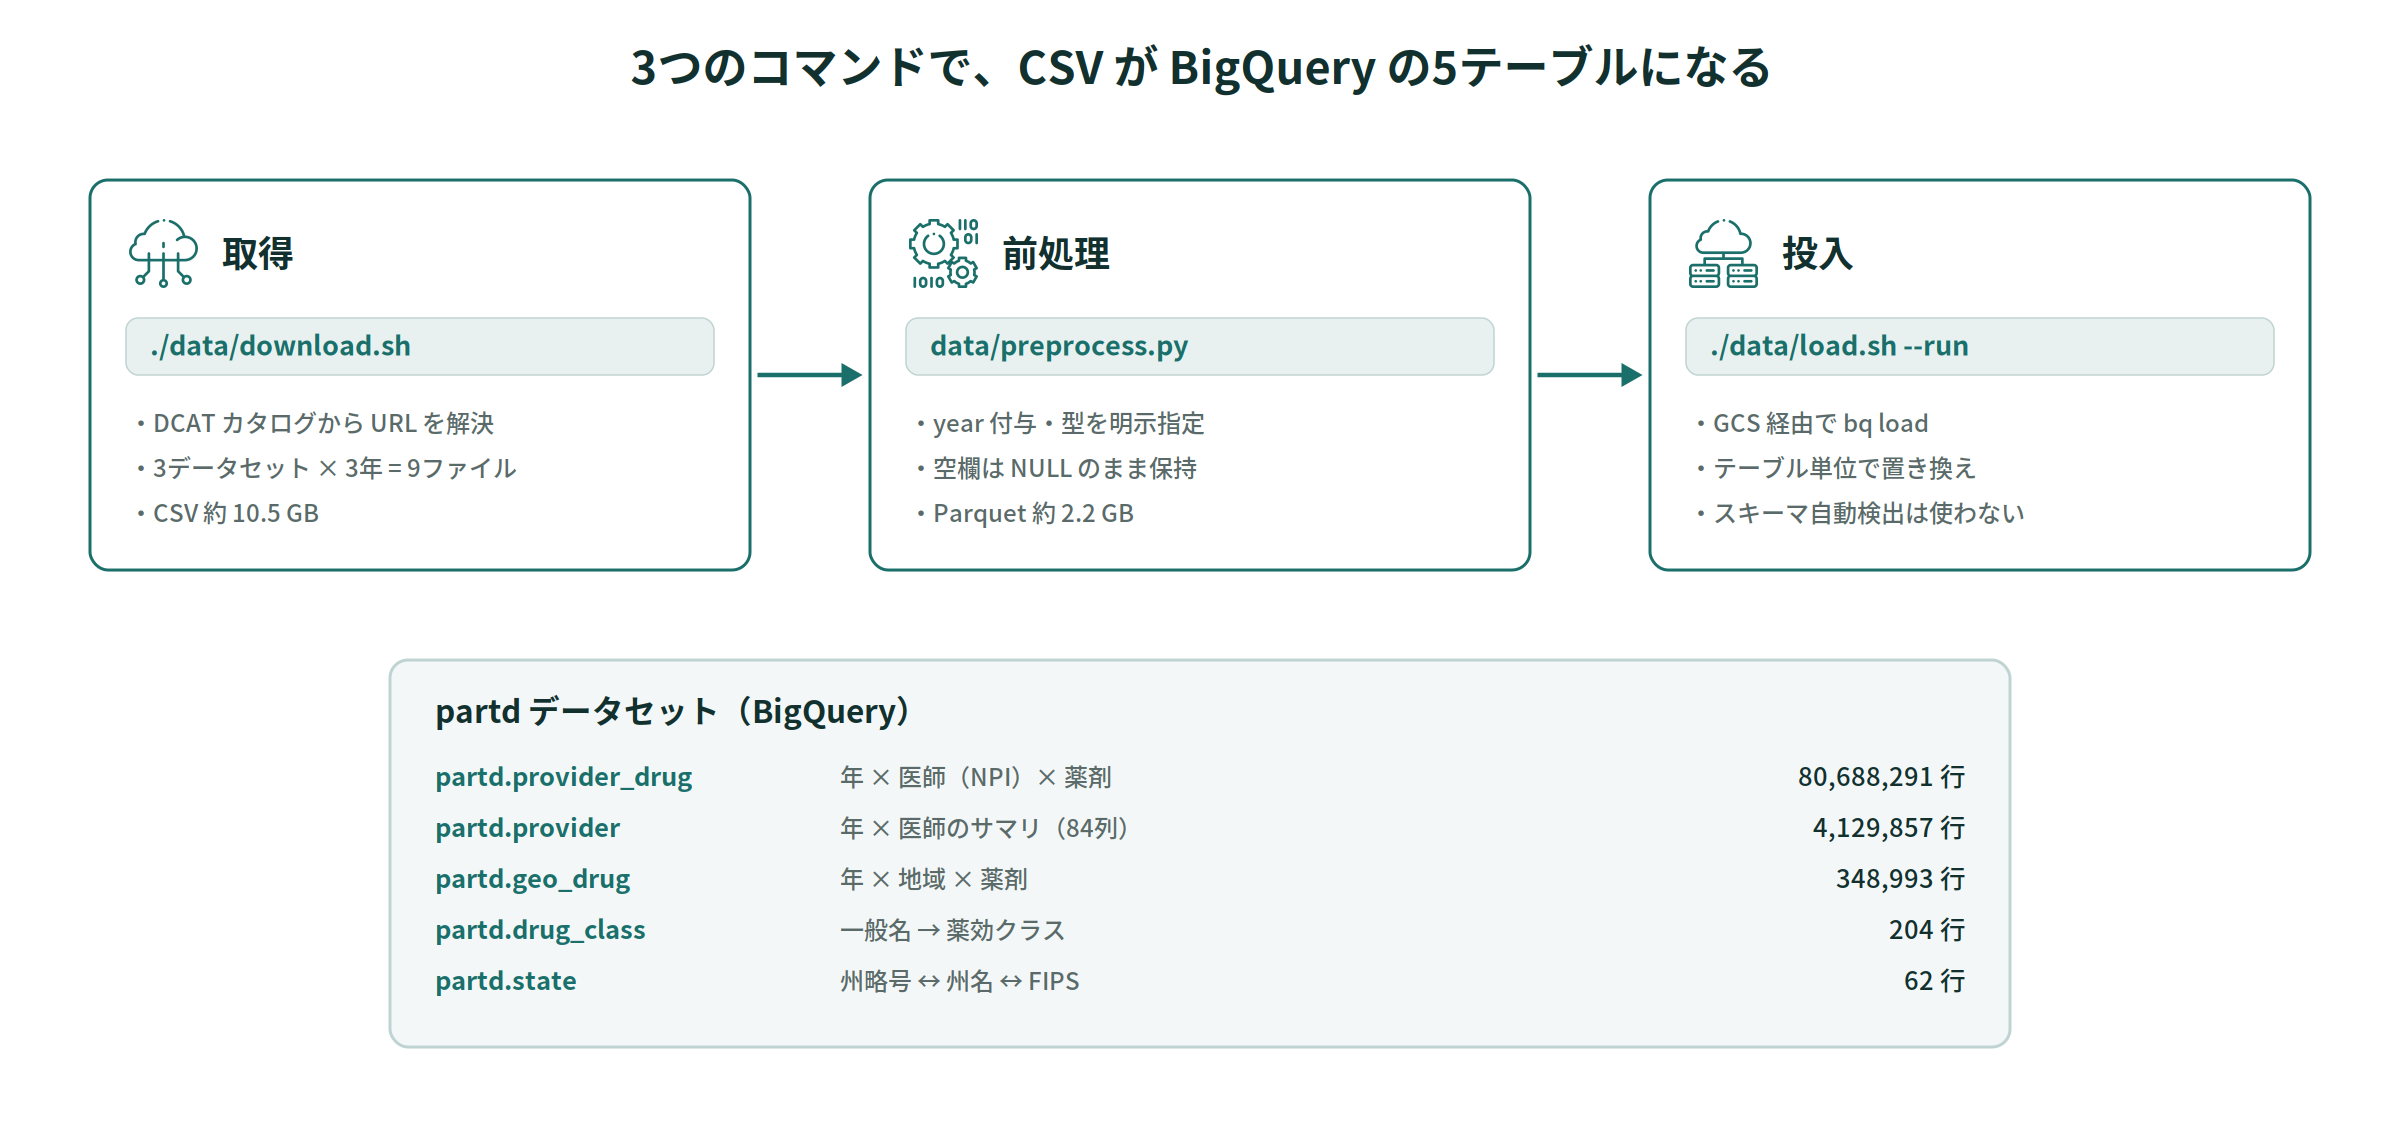
作業は3コマンドです。
./data/download.sh                     # CMS から CSV を取得
.venv/bin/python data/preprocess.py    # year 付与・型明示・Parquet 化
./data/load.sh --plan                  # 実行されるコマンドを確認
./data/load.sh --run                   # BigQuery に投入
初回は1〜2時間ほどかかります。ほとんどはダウンロードの待ち時間なので、走らせておいて別の作業をしていて構いません。
1-2. 用意するもの
- Python 3.12 以上と
gcloudCLI - Google Cloud のプロジェクト(BigQuery を有効化し、課金アカウントを紐付けたもの)
- ディスクの空き(CSV で約10.5GB、Parquet で約2.2GB)
Anthropic の API キーはこの回では使いません。Claude に SQL を書かせるのは Part2 からで、ここまではただのデータ投入です。前提条件の詳細はリポジトリの README にまとめてあります。
1-3. 扱うデータ
CMS(米国メディケア・メディケイドサービスセンター)が毎年公開している Medicare Part D Prescribers の3つのデータセット、CY2022〜2024 の3年分を使います。医師(NPI)× 薬剤 × 年の粒度で、処方医の氏名・専門科・所在地が付いた公開データです。
Medicare と Part D の仕組み、3つの表の関係、主要な列、抑制ルール、このデータでできないことは、解説ページ「Medicare Part D とは」に分けて書きました。データの中身を先に押さえたい方はそちらを読んでから戻ってきてください。この記事は手を動かす側に絞ります。
2. データの入手
2-1. 公開カタログと3つのファイル
CMS のダウンロード URL を、スクリプトに直書きしていません。
CMS は年次更新のたびにファイル名と配置パスを変えます。URL を固定すると翌年には動かなくなるので、data/download.sh は毎回 DCAT カタログ(data.cms.gov/data.json)を取得し、データセット名と対象年からダウンロード URL を解決しています。カタログは24時間キャッシュします。
取得するのは3データセット × 3年の計9ファイルです。
| データセット | 手元のファイル名 | 粒度 |
|---|---|---|
| by Provider and Drug | provider_drug_<年>.csv |
年 × 医師 × 薬剤 |
| by Provider | provider_<年>.csv |
年 × 医師(サマリ84列) |
| by Geography and Drug | geo_drug_<年>.csv |
年 × 地域 × 薬剤 |
いきなり全部取りにいく前に、何が取得されるかを確認できます。
./data/download.sh --list        # 取得予定の URL を表示するだけ
./data/download.sh geo_drug 2024 # データセットと年を絞る
最初は geo_drug の2024年だけで試すのがおすすめです。3つの中でいちばん小さく、疎通確認が数分で終わります。
2-2. ダウンロードと、途中で止まったときの挙動
絞り込みなしで実行すると、9ファイルを順に取りにいきます。
./data/download.sh[catalog] https://data.cms.gov/data.json を取得中...
[get ] geo_drug 2022 <- ...
[done] geo_drug_2022.csv 73M
[get ] provider 2022 <- ...ここで一つ、実際に踏んだ挙動があります。data.cms.gov は Content-Length を返さず、Range リクエストも無視します。 レスポンスは 206 ではなく 200 で返ってくるため、curl -C - によるレジュームが効きません。数GBのファイルのダウンロードが中断すると、続きからではなく最初からやり直しになります。
対策として、スクリプトは .part という一時名に落とし、完了してから正式名に変更します。すでに完成しているファイルはスキップするので、中断したら同じコマンドをもう一度叩けば、落とし切れていないファイルだけを取り直します。
3. 生データの確認
BigQuery に入れる前に、CSV を直接覗きます。この確認を飛ばすと、あとで「空欄をゼロとして集計してしまった」という種類の事故が起きます。
3-1. 行数と列名
wc -l data/raw/geo_drug_2024.csv
head -1 data/raw/geo_drug_2024.csv | tr ',' '\n' | head -20
列名は Prscrbr_NPI、Tot_Clms、Gnrc_Name のような略記の混在表記です。母音を落とした独特の省略(Prscrbr = Prescriber、Sprsn = Suppression、Sply = Supply)なので、最初は公式データ辞書を横に置いて読むことになります。
3-2. 空欄の正体
このデータでいちばん重要な確認がこれです。CSV の空欄は「ゼロ」ではありません。
CMS は個人が特定されるのを防ぐため、件数が1〜10 の値を空欄(blank)にして公開しています。さらに、医師 × 薬剤の組み合わせで請求数が11未満の行は、そもそも主表に存在しません。つまり空欄は「1〜10件だった」という情報であり、行が無いことは「0件だった」ではなく「少数だったので出していない」という意味になります。
どの値が抑制されたかは、末尾が _sprsn_flag の列に入っています。
| 値 | 意味 |
|---|---|
* |
一次抑制。その値そのものが1〜10 |
# |
従属抑制。他の内訳から逆算できてしまうため隠している |
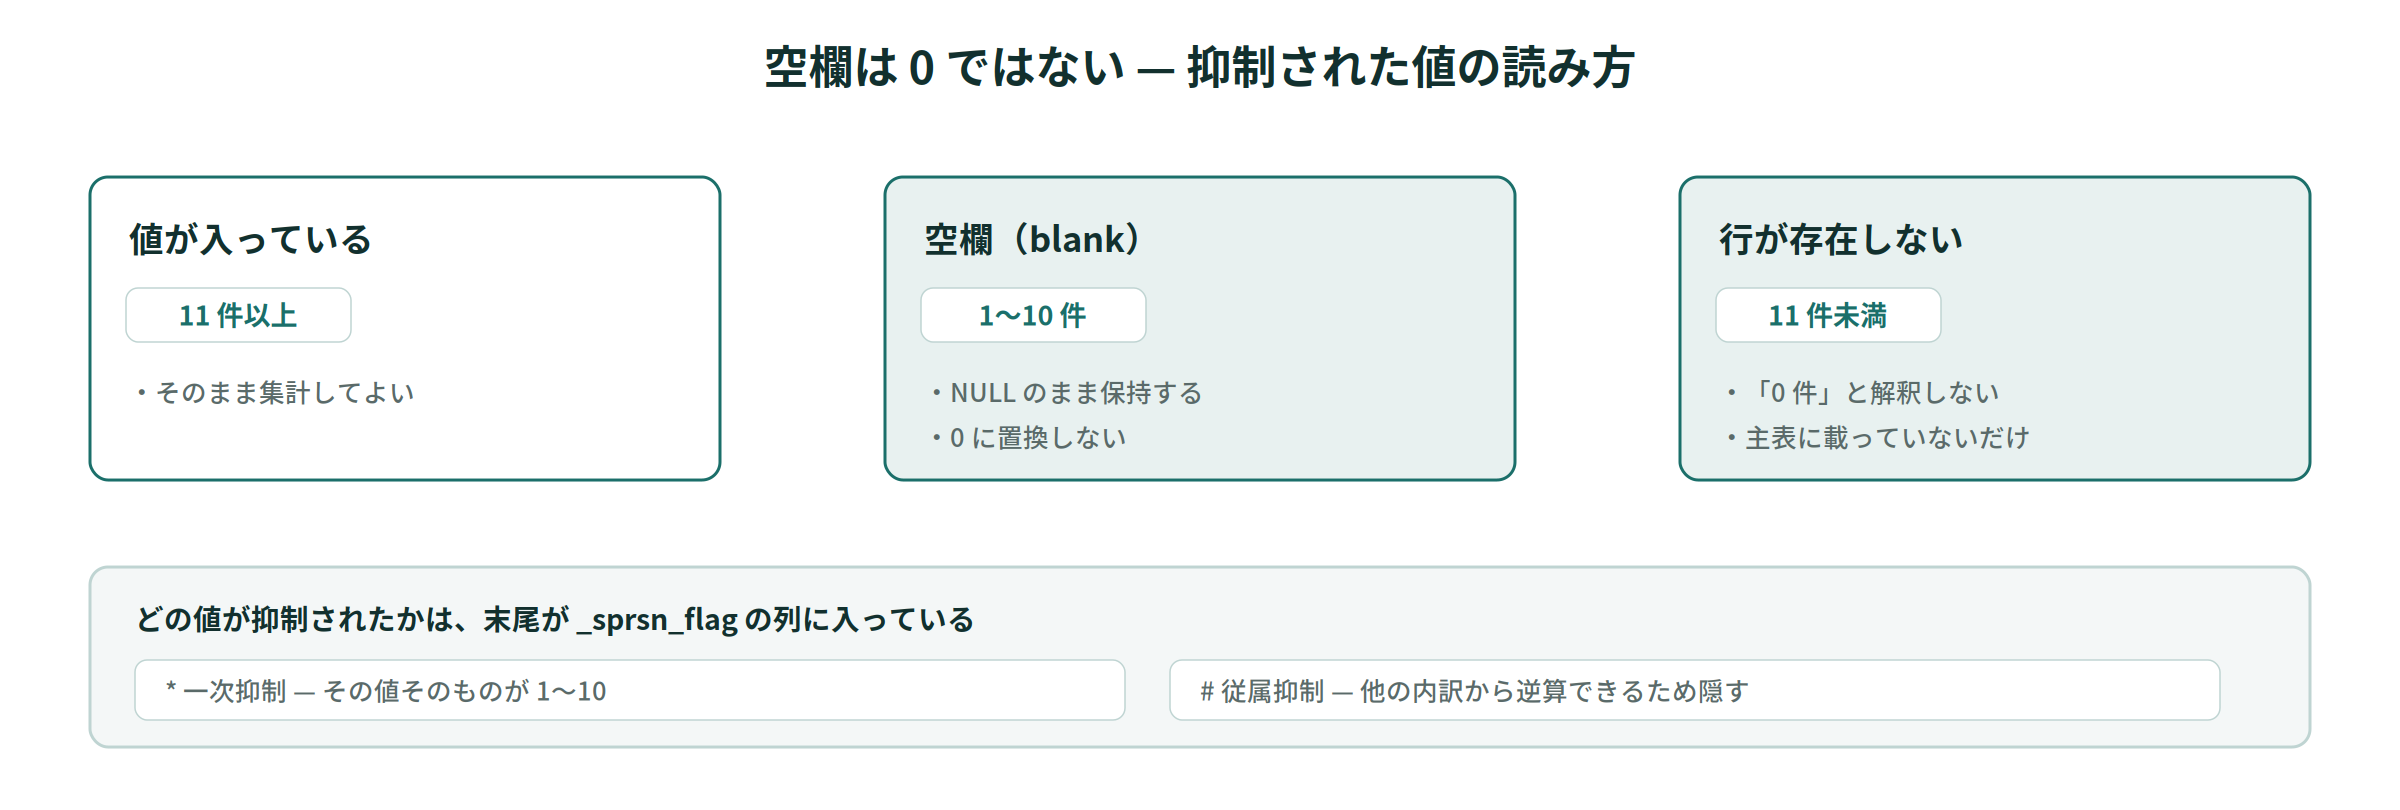
ここから、この記事とアプリを通じて守っているルールが1つ決まります。空欄は NULL のまま持ち、0 に置換しない。 置換してしまうと、SUM も AVG も「少数例を0とみなした値」になり、しかも見た目には正常な数字が出るため気づけません。
同じ理由で、地域別の表と医師別の表は合計が一致しません。抑制のかかり方が粒度ごとに違うからです。抑制ルールの詳細は解説ページ「Medicare Part D とは」に整理してあります。
3-3. 薬剤名の切り詰め
もう一つ、生データの段階で気づいておくべき癖があります。一般名(Gnrc_Name)が列幅の都合で切り詰められています。
EMPAGLIFLOZ/LINAGLIP/METFORMIN
DAPAGLIFLOZ PROPANED/METFORMIN
教科書どおりの薬剤名を IN で並べて絞り込むと、この種の配合剤を静かに取りこぼします。表記は Ozempic / Semaglutide のような Title Case で、年やファイルによって揺れもあります。この2点への対処が、次の前処理と補助テーブルの設計理由になります。
4. 前処理
4-1. 型の明示と year 列の付与
data/preprocess.py が DuckDB で CSV を読み、Parquet に変換します。やっていることは4つです。
- 列名を snake_case の小文字に統一する
- CSV に無い
year列を、ファイル名の年から付与する - 型を
data/schema/*.jsonの定義どおりに明示指定する gnrc_name_norm/brnd_name_norm(大文字化した正規化列)を追加する
3番が肝心なところです。型の自動検出を使っていません。 prscrbr_npi を数値と判定されると、先頭が0で始まる NPI の0が落ちて別の医師になってしまいます。schema JSON を列名と型の正本と決め、ここを直さない限りテーブル定義も変わらない構造にしました。
読み込み時にはヘッダを schema JSON と突き合わせ、一致しなければその場で止めます。CMS 側の列構成が変わったときに、黙って NULL 列ができる代わりに、差分が名指しで表示されます。
provider_2024.csv: ヘッダがスキーマと不一致
  CSV にあってスキーマに無い: ['bene_race_othr_cnt']
  スキーマにあって CSV に無い: []
空文字は nullstr='' で NULL として読み、0 には置換しません。3-2 のルールがここで実装になります。
4-2. 正規化列と Parquet 化
薬剤名は CMS 原文の Title Case をそのまま保持し、照合用に大文字化した *_norm 列を別に持ちます。表示は原文、結合と絞り込みは正規化列、という使い分けです。BigQuery のクラスタリングにもこの正規化列を使います。
変換後は、テーブル × 年ごとの行数がそのまま表で出ます。
| テーブル | 年 | 行数 | CSV | Parquet |
|---|---|---:|---:|---:|
| geo_drug | 2024 | 116,331 | 73.4 MB | 9.8 MB |
CSV 約10.5GB が Parquet 約2.2GB になります。列指向で圧縮が効くうえ、型がすでに確定しているので、このあとの投入でスキーマ推定をさせずに済みます。
5. BigQuery への投入
5-1. データセットと5つのテーブル
partd というデータセットに、主表3つと補助表2つを作ります。
| テーブル | 行数(3年) | 内容 |
|---|---|---|
partd.provider_drug |
80,688,291 | 年 × 医師(NPI)× 薬剤 |
partd.provider |
4,129,857 | 年 × 医師のサマリ(84列) |
partd.geo_drug |
348,993 | 年 × 地域 × 薬剤 |
partd.drug_class |
204 | 一般名 → 薬効クラス(17クラス) |
partd.state |
62 | 州略号 ↔ 州名 ↔ FIPS |
テーブル定義は sql/ddl.sql にあり、schema JSON から生成しています。主表3つは共通して次の設計です。
PARTITION BY RANGE_BUCKET(year, ...)— 年で絞るクエリがパーティションだけを読むようにするCLUSTER BYに州と正規化した一般名 — 「州 × 薬剤」という、このデータでいちばん多い絞り方に合わせるprscrbr_npiはSTRING— 先頭の0を保持する
5-2. GCS 経由のロード
data/load.sh が、データセット作成からロード、行数確認までを順に実行します。まず --plan で中身を読みます。
./data/load.sh --plan   # 実行されるコマンドを表示するだけ
./data/load.sh --run    # 実際に実行する
--plan を既定にしているのは、自分の GCP プロジェクトに対して書き込みが走る最初のコマンドだからです。表示されたコマンドを読んでから --run に進みます。
投入は Parquet を GCS にコピーし、bq load でテーブルに流し込む形です。スキーマは ddl.sql で作った既存テーブルのものを使い、ここでも自動検出はしません。
冪等性はテーブル単位の --replace で担保しています。年ごとに追記していく方式だと、同じ年を二重に入れる事故が起きます。そのテーブルの Parquet を全部まとめて置き換える方式にしたので、途中で失敗しても同じコマンドを叩き直せば整合した状態に戻ります。ロードが終わったら GCS 上の一時ファイルは削除します。
5-3. 補助テーブルの作り方
主表だけでは答えられない質問が2種類あります。「GLP-1受容体作動薬の処方を州別に」と「フロリダ州の処方医は何人」です。前者は薬効クラス、後者は州名と略号の対応が要ります。
partd.drug_class は一般名を薬効クラスに対応付ける表です。手で薬剤名を並べるのではなく、実データに存在する一般名(3年分の geo_drug で2,109種)から語幹一致で生成しています。3-3 で見た切り詰めがあるので、教科書どおりの名前を並べる方法は最初から成立しません。
語幹一致には語幹一致の落とし穴があり、実際に次の2つを踏みました。
STATINで拾うとIMIPENEM/CILASTATIN SODIUM(抗菌薬)が混ざるPRAZOLEで拾うとARIPIPRAZOLE/BREXPIPRAZOLE(抗精神病薬)が混ざる
いずれも語幹を薬剤名まで具体化して回避しました。あわせて、配合剤は成分ごとに複数クラスに属します(EMPAGLIFLOZIN/METFORMIN HCL は SGLT2 とビグアナイドの両方)。クラスをまたいで合計すると二重計上になるので、集計は必ず1クラスに絞る、という制約が残ります。この制約は Part2 で Claude に渡す用語辞書にそのまま持ち込みます。
partd.state は、州名フルで持つ geo_drug と、略号で持つ provider を橋渡しする表です。FIPS コードと、50州+DC かどうかのフラグを持たせています。準州や軍事郵便コードを「州」として地図に出さないための列です。
6. 最初の集計
6-1. 行数の確認
load.sh は最後に、テーブル × 年の行数を出して終わります。ここが Parquet 変換時に出た行数表と一致していれば、投入は成功です。
6-2. 薬剤別の処方医数
最初の1本は、Part0 で触れた「日本のオープンデータには無い粒度」を確かめる集計です。
SELECT gnrc_name_norm, COUNT(DISTINCT prscrbr_npi) AS prescribers
FROM `partd.provider_drug`
WHERE year = 2024
GROUP BY 1
ORDER BY prescribers DESC
LIMIT 10;
セマグルチドの処方医数は 174,885 人です。この値は、あとでデプロイの検査に使う既知の値としても使っています(Part4)。医師個人まで降りたデータなので、COUNT(DISTINCT prscrbr_npi) という集計そのものが成立します。
6-3. 州別の集計
地域別の表と州マスタを結合します。
SELECT s.state_abrvtn, SUM(g.tot_clms) AS claims
FROM `partd.geo_drug` g
JOIN `partd.state` s ON g.prscrbr_geo_desc = s.state_name
JOIN `partd.drug_class` c ON g.gnrc_name_norm = c.gnrc_name_norm
WHERE g.year = 2024 AND c.drug_class = 'GLP1' AND s.is_state
GROUP BY 1
ORDER BY claims DESC;
これが、Part3 で州別の地図として描く元データです。補助テーブル2つがどちらも登場していることに注目してください。薬効クラスでの絞り込みと、州の正規化は、どちらも主表だけでは書けません。
📷 スクショ予定:BigQuery コンソールで上のクエリを実行した結果
7. Claude Code に任せた範囲
この回の作業は、ほぼ Claude Code に任せています。最初に渡したのは設計書とデータ辞書で、指示はこれだけでした。
CLAUDE.md と docs/ 配下を読んでから始めてください。フェーズ1「データ」から着手します。
まず CY2024 の Geography and Drug(最小ファイル)だけで疎通確認してから、残りのファイル・年に広げてください。
外部に影響するコマンドは実行前に見せてください。詰まった点は docs/DEPLOY.md に日付付きで残してください。
人が決めたのは方針の部分です。URL を直書きしないこと、schema JSON を列定義の正本にすること、抑制された空欄を0にしないこと、外部に影響するコマンドは --plan を先に出すこと。いずれもデータの性質と事故の起き方に関わる判断で、コードを書く前に決めておく必要がありました。
一方、実際に手を動かして見つかった落とし穴は Claude Code 側から出てきました。data.cms.gov がレジュームに対応していないこと、語幹一致に別クラスの薬剤が混入すること、配合剤が二重計上になること。どれも実データを流して初めて分かる類のもので、設計書には書けなかった部分です。
分担としては、「壊れ方を決めるのは人、壊れ方を見つけるのは実行」という形に落ち着きました。この線引きは Part2 以降でも変わりません。
📷 スクショ予定:Claude Code が download.sh のレジューム不可に気づいて
.part方式に切り替えた作業画面
8. まとめ
CMS の公開 CSV 約10.5GB を、BigQuery の5テーブルに載せるまでを見ました。作業自体は3コマンドですが、その中身で効いているのは次の3点です。
- URL を直書きしない。 CMS は毎年ファイル名と配置を変える
- 型を自動検出に任せない。 NPI の先頭0が落ちると別人になる
- 空欄を0にしない。 1〜10件の抑制と0件は別の意味を持つ
どれも、データが手元に入ってから直すのが難しい種類の判断です。逆に言えば、ここさえ押さえておけば、あとは何を聞くかの問題になります。
次のステップ
次は、載せたデータに Claude が SQL を書けるようにします。医療用語の辞書をどう与えるか、生成された SQL を無条件に実行しないための2つのツールをどう分けるか、そして「切り詰められた薬剤名」や「抑制された空欄」をプロンプト側でどう扱うかを、実際のコードと一緒に見ていきます。
出典
- CMS, Medicare Part D Prescribers - by Provider and Drug / by Provider / by Geography and Drug, Data Dictionary (data.cms.gov)
- CMS, Medicare Part D Prescribers Datasets: A Methodological Overview
- CMS, data.cms.gov DCAT-US Catalog (data.cms.gov/data.json)
コードは GitHub で公開しています: github.com/HerzLeben/medicare-partd-text-to-sql