Claude Code × Medical Application
【Claude Code】Medicare Part D × Text-to-SQL Part4:評価と運用
1. はじめに
Part3 では、文書に書いた約束を hook と skill に移し、人が覚えていなくても検査が走るようにしました。最終回の Part4 は評価の回です。
ここまでの道具は、どれも「作業の途中で間違えない」ためのものでした。評価は、できあがったアプリが質問に正しく答えるかを、正解と突き合わせて測ります。測れれば、どこを直せばよいかが分かり、直したことで何が壊れたかも分かります。
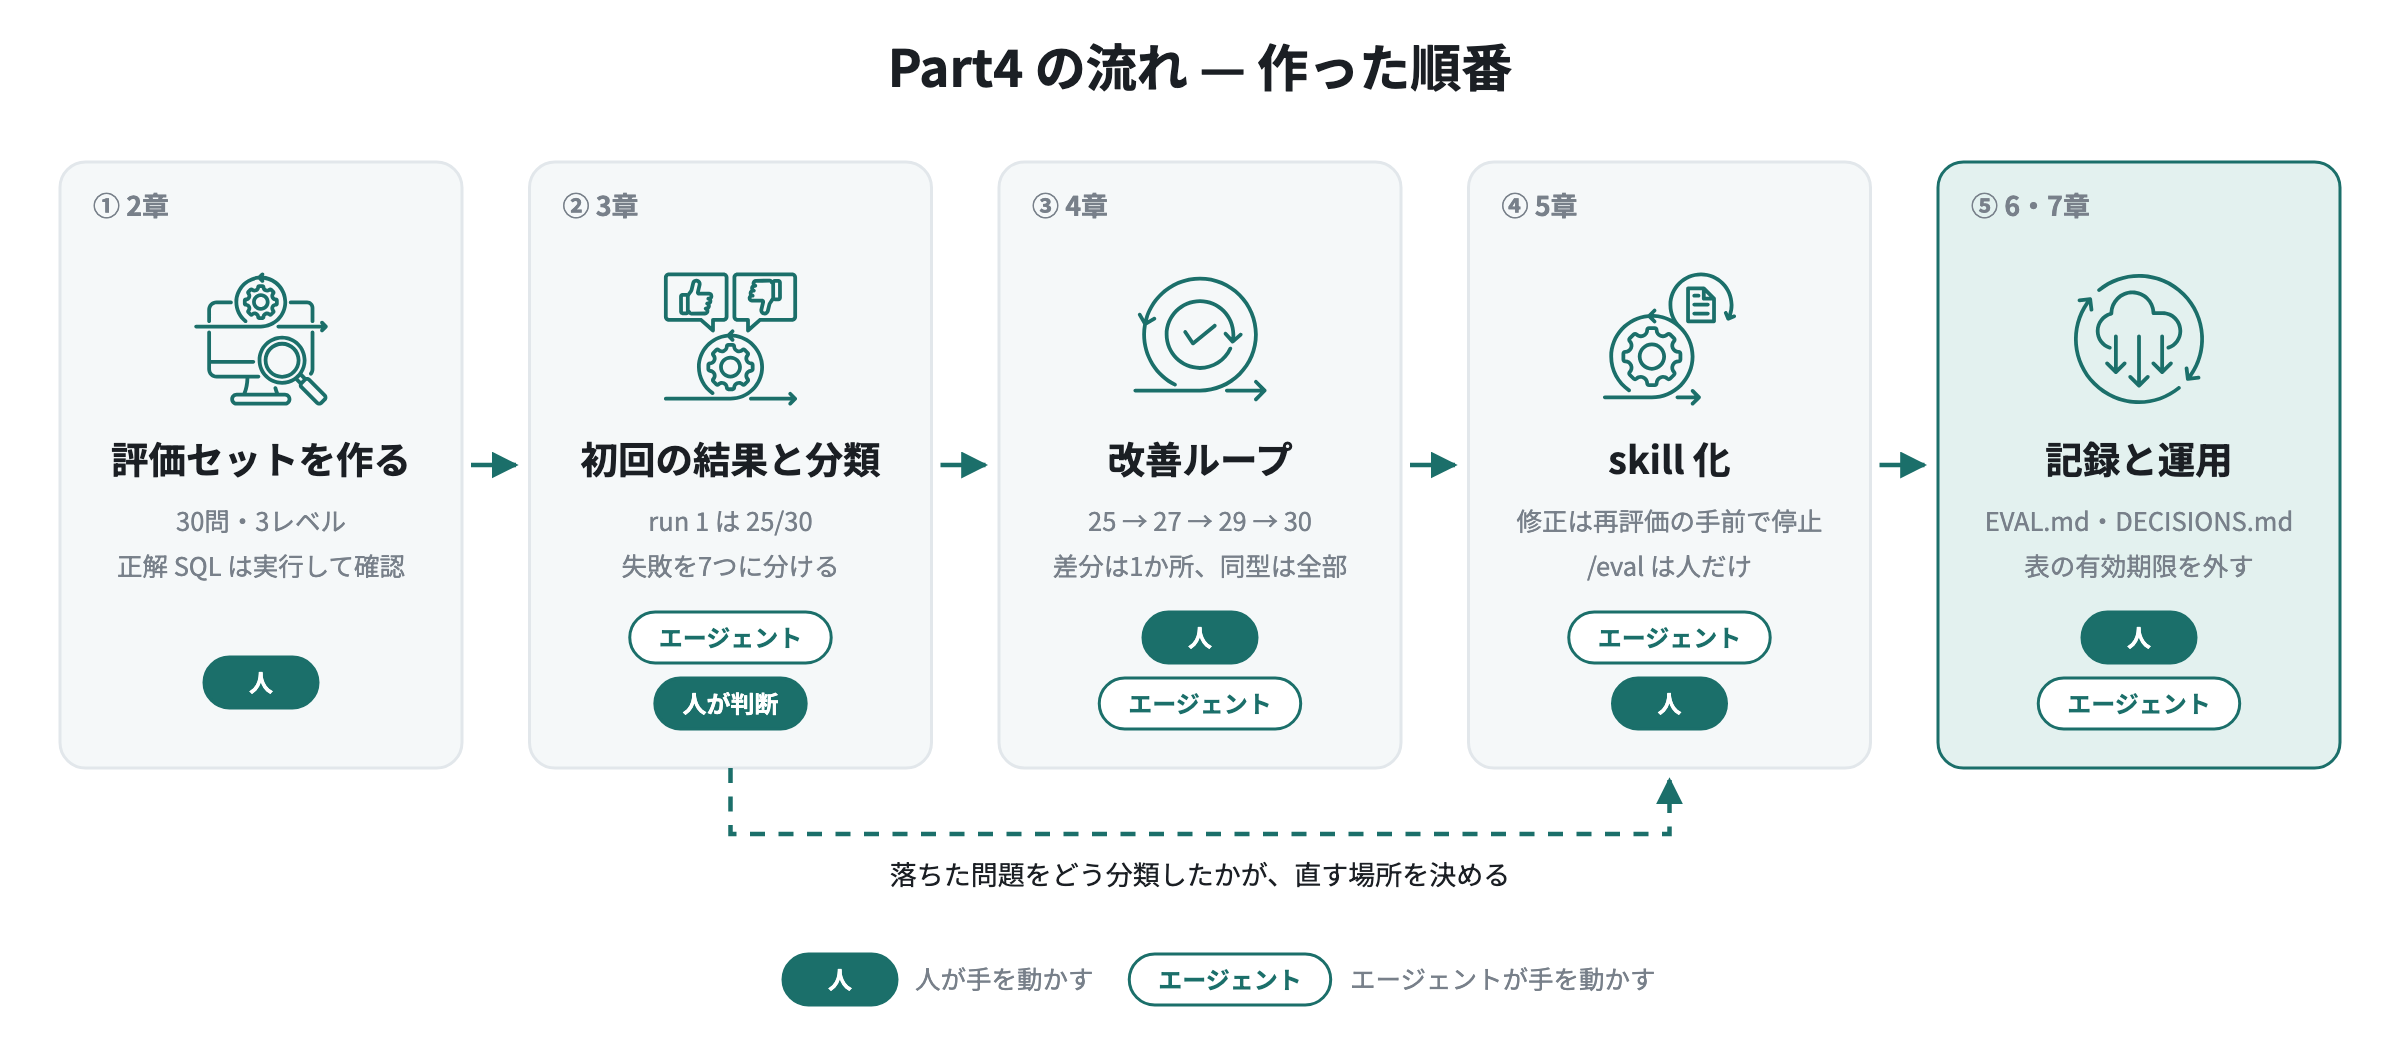
この回は、作った順番どおりに次の流れを追います。
- 正解のある評価セットを先に作る
- 初回の結果を読み、失敗を分類する
- 分類に沿って直し、再評価する(改善ループ)
- 評価と修正の手順を skill にする
- 記録を残し、運用で壊れないようにする
2. 評価セットを先に作る
2-1. 30問・3レベル
評価セットは eval/questions.yaml の30問です。難しさで3つのレベルに分けました。
| レベル | 内容 | 問数 | 例 |
|---|---|---|---|
| L1 | 単純集計 | 8 | 2024年にセマグルチドを処方した医師は何人? |
| L2 | 結合・条件が複数 | 12 | 2024年、フロリダ州の内科医でオピオイド処方回数が多い上位20 |
| L3 | 用語辞書がないと解けない | 10 | SGLT2阻害薬の全国処方量(30日換算)の年次推移 |
L3 は、薬効クラス(SGLT2阻害薬、DOAC など)やブランド名(オゼンピック)を、データの列と値に読み替えないと解けない質問です。Part2 で作った用語辞書が効いているかを、ここで測ります。
2-2. 正解は SQL で持ち、実行して確かめる
各問には正解の SQL(expected_sql)を付けました。正解の SQL は、書いただけでは信用せず、BigQuery で実行して結果を確かめています。run_eval.py --validate を流せば、30本がすべて実行できるかをいつでも確かめ直せます。
評価セットを作るのは人の仕事です。何を正解とするかは、アプリが答えるべきことを決める判断で、エージェントに任せると「作ったものに合わせた正解」になりかねません。
2-3. 判定は結果の一致
判定では、SQL の文字列を比べません。同じ答えを出す SQL は何通りも書けるからです。生成された SQL と正解の SQL を両方実行し、結果の表を突き合わせます。
| 指標 | 正解とする条件 |
|---|---|
| 実質正解 | 正解の行と値が、生成結果に含まれている。列名・列順・行順は問わない。数値は相対誤差1%まで。補助の列が増えているのは許す |
| 厳密一致 | 実質正解に加えて、行数と列数まで一致する |
指標を2本にしたのは、1本では読み違えるからです。最初は厳密一致だけで測っていて、結果は 4/30(13.3%) でした。SQL は正しいのに列が1本多い、という失敗が大半でした。厳密一致だけで測ると、ブランド名の列を1本足しただけの正しい答えも不正解になります。実質正解だけで測ると、「合計はいくら」に50行の内訳を返すような、答えの形の崩れが見えません。
結果は1問ごとに保存しています。途中でタイムアウトしても、--rejudge で判定だけをやり直せます。このとき Claude は呼ばないので、API の課金は出ません。
3. 初回の結果と失敗の分類
3-1. run 1
初回(run 1)の記録では、実質正解は 25/30 でした。落ちた5問の原因は、記録では3つにまとめられています。
| 原因 | 問題 | 何が起きたか |
|---|---|---|
| 「薬剤」の単位 | q01・q07・q10 | ブランド名 × 一般名で分けて集計した。レボチロキシンの処方回数が1割過小(48,632,351 → 43,237,856) |
| オピオイドの定義が2通り | q14 | 薬剤のフラグで数えた値(5,031,547)と、医師単位の列の値(4,885,026)が約3%違う。評価セット側の曖昧さ |
| 集計の粒度 | q22 | 年ごとのクラス合計(3行)を聞かれて、年 × 薬剤の38行を返した |
3つのうち1つは、アプリではなく評価セットの側の問題でした。正解を作るのは人の仕事ですが、人の作った正解も間違えます。
3-2. 失敗を7つに分ける
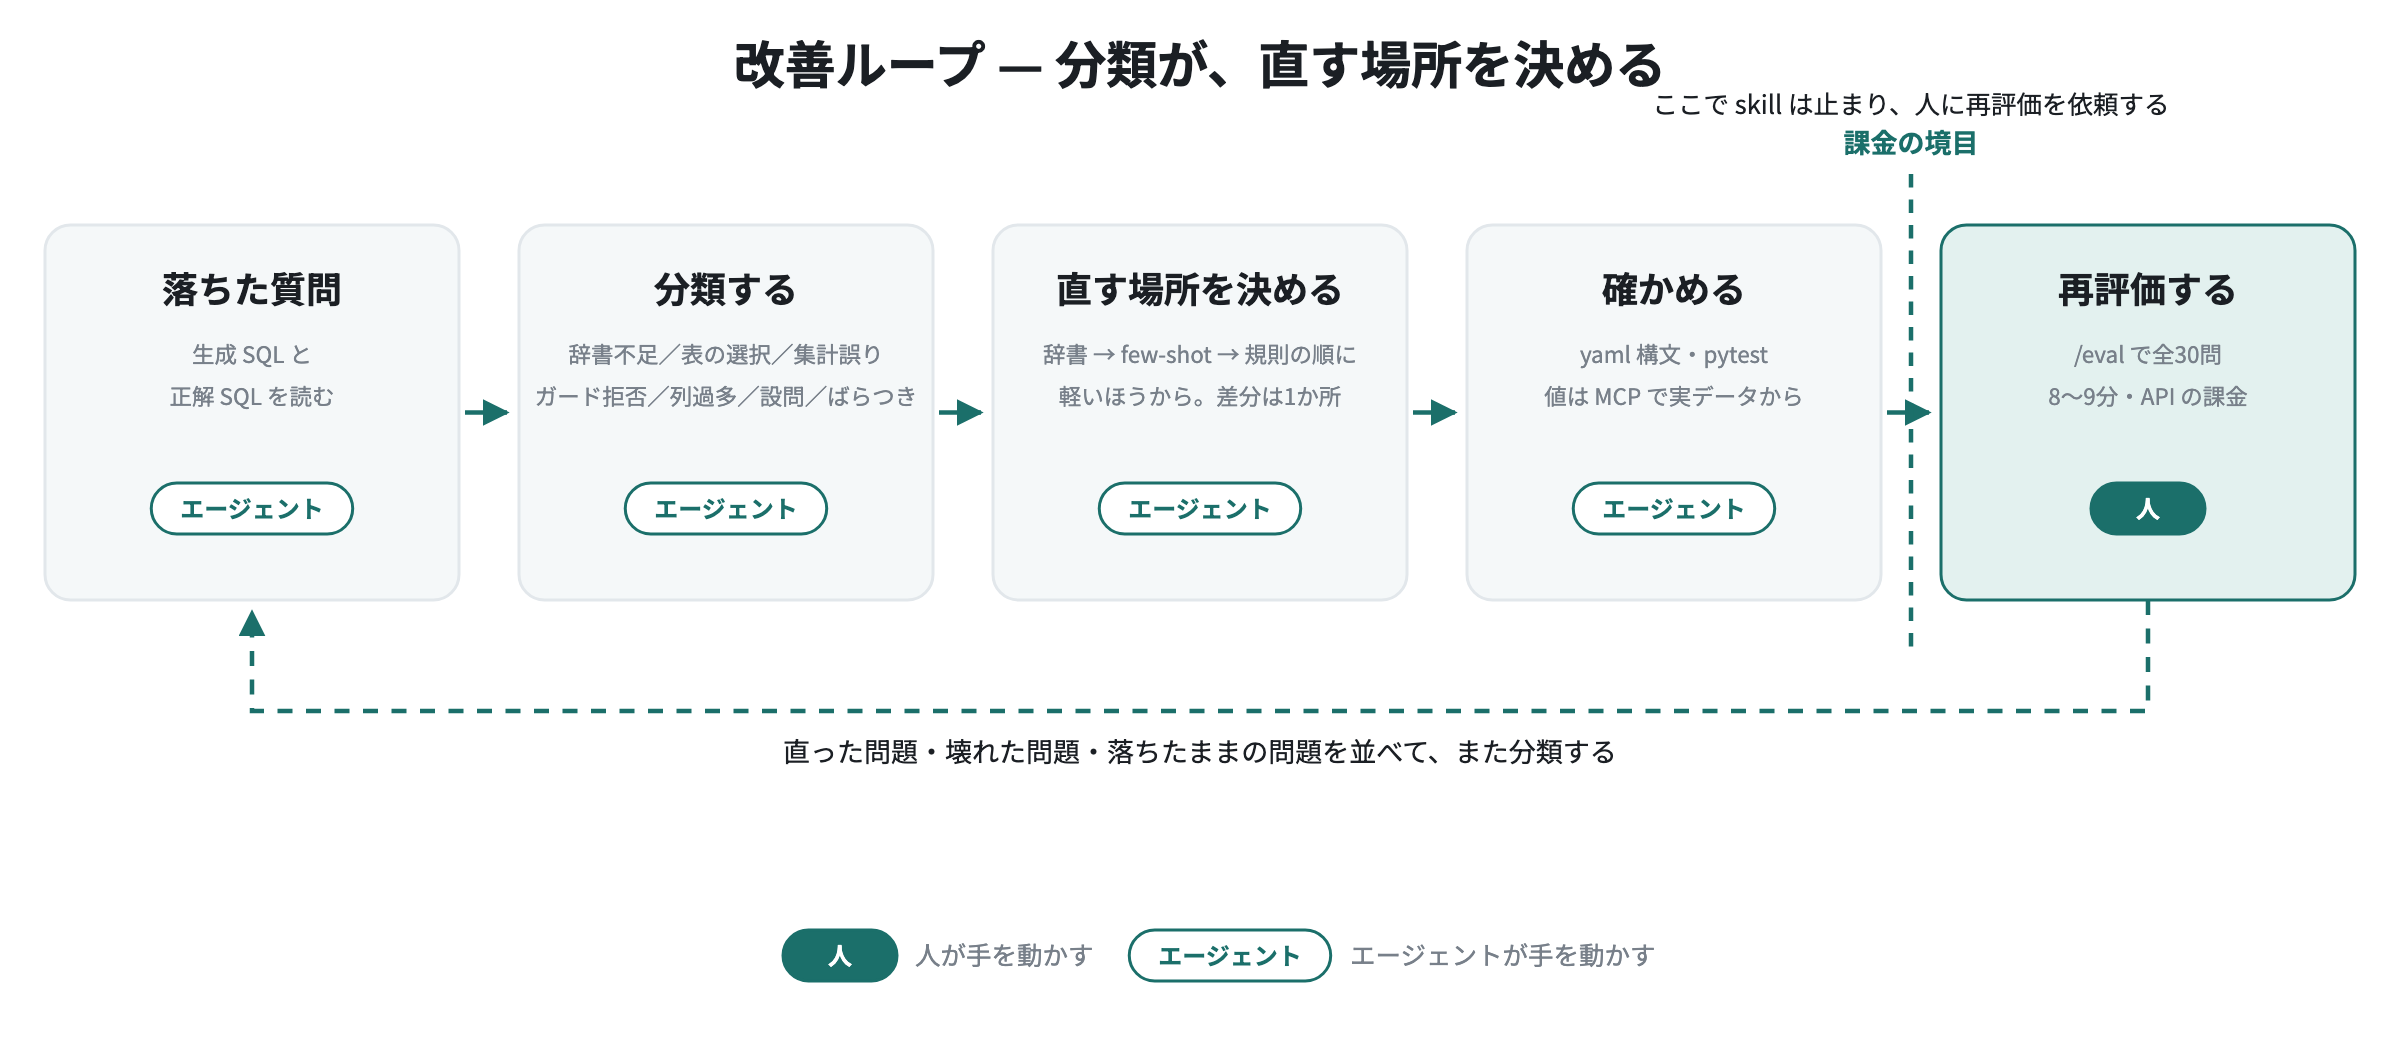
落ちた質問は、生成された SQL を読んで、原因ごとに分けました。分け方を決めておくと、どこを直すかが決まります。
| 分類 | 症状 | 直す場所 |
|---|---|---|
| 辞書不足 | 用語を違う列に読んだ。薬効クラスの言い換えを引けなかった | 用語辞書 glossary.yaml |
| テーブル選択の誤り | 列はあるが表が違う | 用語辞書の table_hints |
| 集計誤り | 列は合っているが、SUM と COUNT DISTINCT、加重平均と単純平均の選び方が違う | 用語辞書の注記 → 直らなければ few-shot に例を1つ |
| ガード拒否 | 正しい SQL をガードが弾いた | guards.py と、先にテスト |
| 列過多・形式 | 答えは合っているが列が多い、1つの数字を50行に分けた | system.md の規則(例外は狭く) |
| 設問の曖昧さ | 正解の SQL と生成された SQL の、どちらの解釈も成り立つ | 評価セットの設問か正解 SQL |
| ばらつき | 同じ条件で通ったり落ちたりする | 直さない。複数回まわして判断 |
分類が2つにまたがるときは、辞書 → 例 → 規則の順に、軽いほうから試します。規則は影響する範囲が広く、別の質問を壊しやすいからです(4章)。
3-3. 辞書が誤りを教えていた
分類の過程で、用語辞書そのものが間違っていたことが分かりました。q04「2024年にセマグルチドを処方した医師は何人?」です。
辞書には「処方医数は tot_prscrbrs をそのまま使う」と書いていました。ところが、セマグルチドには複数のブランドがあり、ブランドごとの行を SUM すると、両方を処方した医師が重複して数えられます。
| 集計のしかた | 処方医数 |
|---|---|
ブランドごとの tot_prscrbrs を SUM |
453,256 |
医師単位で COUNT(DISTINCT prscrbr_npi) |
174,885 |
2.6倍の過大です。辞書は「行が1つに定まるときだけ tot_prscrbrs、まとめるときは COUNT(DISTINCT prscrbr_npi)」に書き換え、数値の根拠を注記に残しました。
エージェントは辞書に書いてあるとおりに SQL を書いていました。間違っていたのは指示の側で、評価の正解(実データで確かめた値)と突き合わせて初めて見つかりました。
3-4. 人が決めたこと/実行が見つけたこと
| 人が決めたこと | 実行が見つけたこと |
|---|---|
| 30問と、その正解 | 辞書が教えていた集計の誤り(q04) |
| 判定を結果の一致にし、指標を2本にする | 実質正解と厳密一致の差(run 6 で 29 と 11) |
| 失敗の分類と、それぞれ直す場所 | 分類ごとの実例(4章) |
4. 改善ループ
4-1. 5問直って、5問壊れた
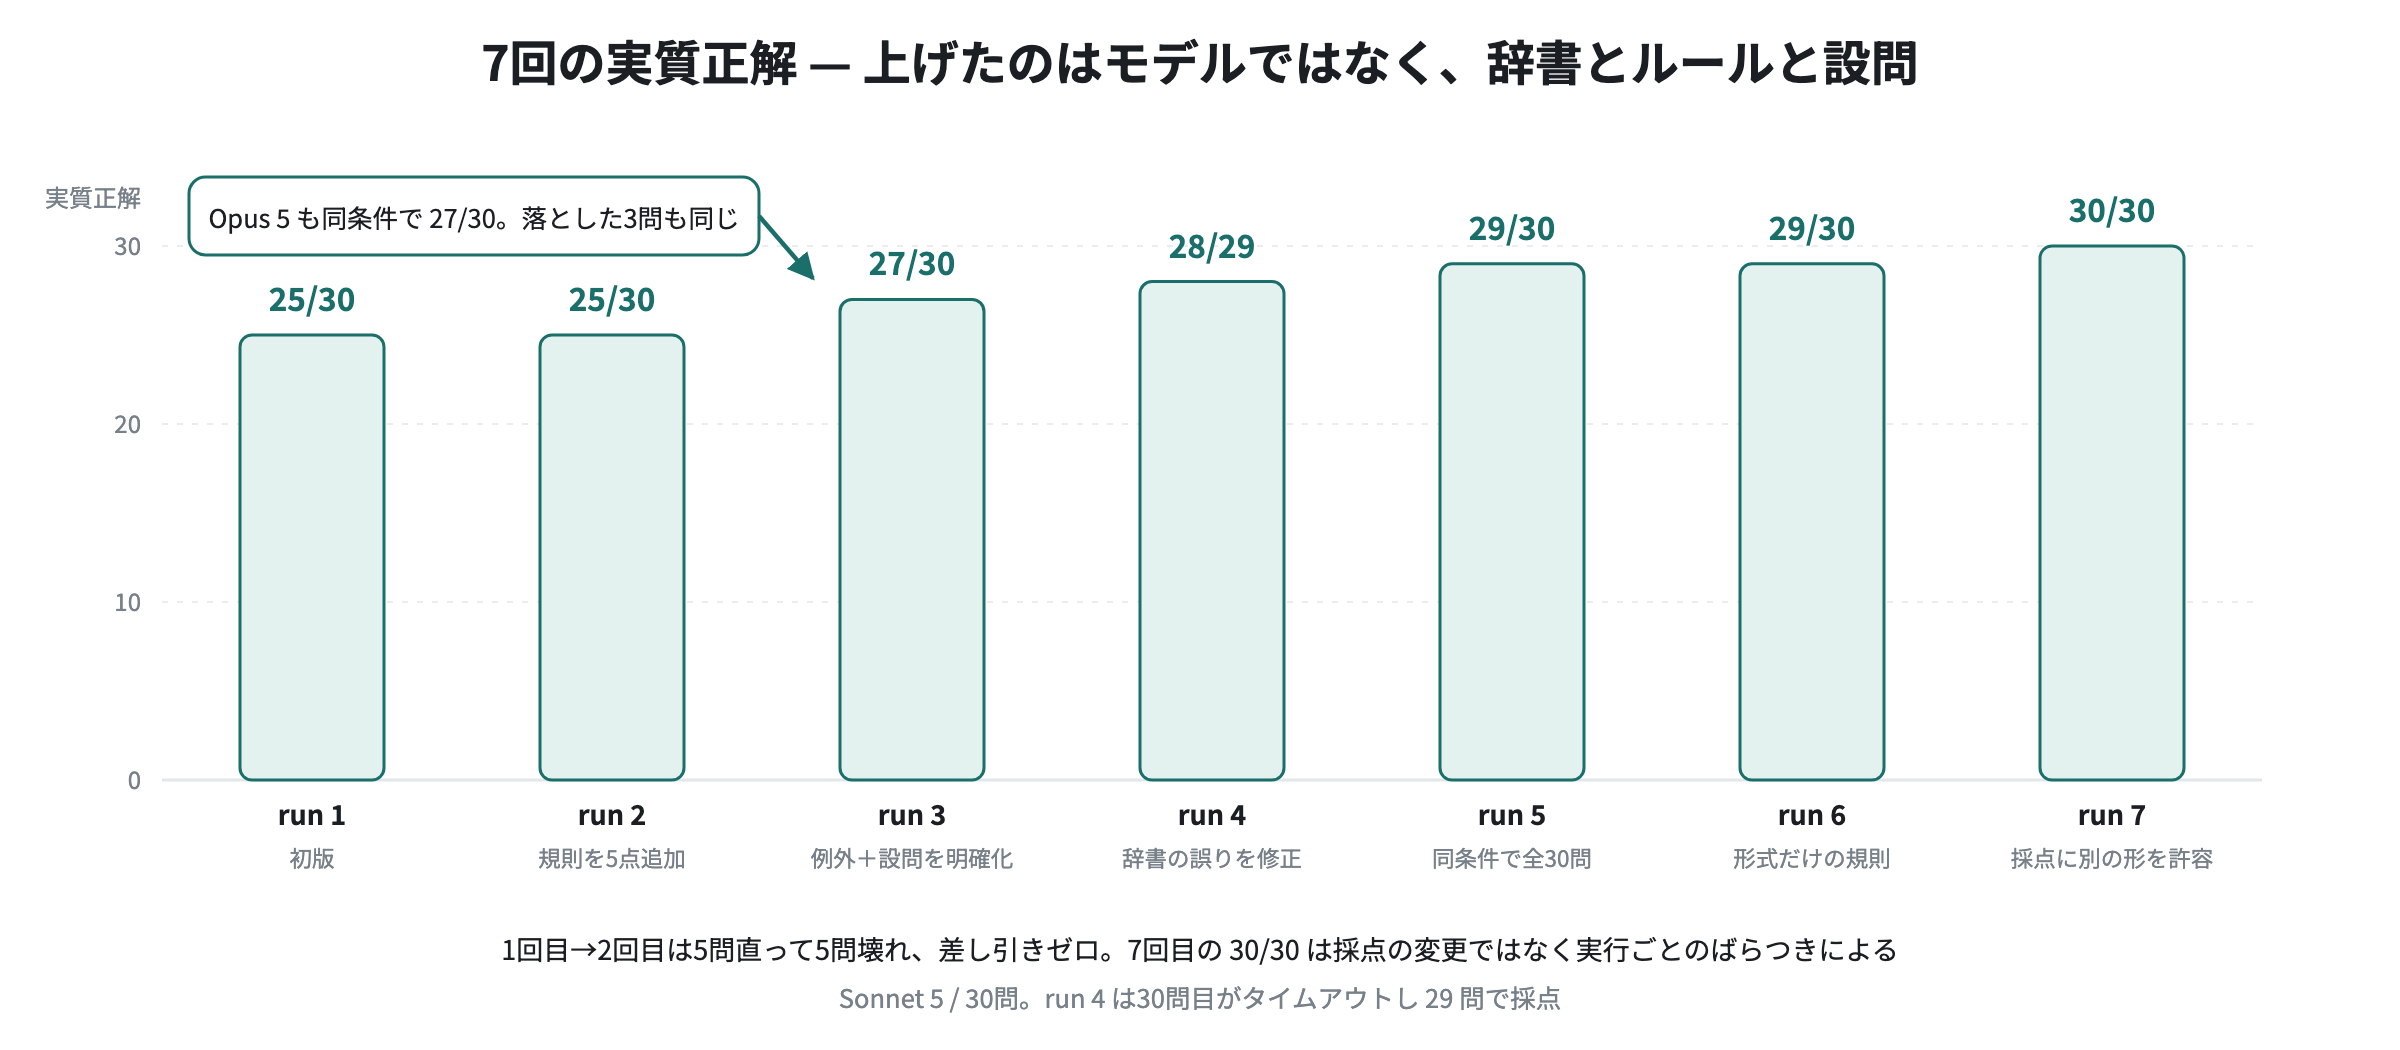
最初の修正では、プロンプトに規則を足しました。run 2 の実質正解は 25/30 で、変わりませんでした。
中身を見ると、5問が直り、別の5問が壊れていました。差し引きゼロです。規則を1つ足すと、その規則が想定していなかった質問が壊れます。
例が q26「2024年のスタチンの総薬剤費は全国でいくら?」です。「費用を聞かれたらブランド名も含める」という規則を足したところ、合計を1つ聞いただけの質問に、ブランド別の50行を返すようになりました。規則は「ランキング・内訳を聞かれたとき」に限定しています。
ここから、修正の原則を1つ決めました。差分は1か所、最小に。
4-2. 同型を全部見る
もう1つの失敗は、直し漏れです。q15(患者の平均リスクスコアが高い専門科)で、加重平均と単純平均のどちらを取るかが曖昧だったので設問を直しました。ところが、同じ形の曖昧さを持つ q18(受給者の平均年齢が高い専門科)を見落としていました。
1問を直したら、同じ型の質問を全部見る。これも手順に入れました。
4-3. モデルを上げても直らない
run 3 では、同じ評価セットを Opus 5 でも流しました。結果は Sonnet 5 と同じ正解数で、落とした3問も同じでした。所要時間は1.5倍、単価は2.5倍です。
原因はモデルの能力ではなく、辞書・規則・設問の側にありました。既定のモデルは Sonnet 5 のままにしています。
そのあと、辞書と few-shot の改訂(run 4)、評価の30問目のタイムアウトの修正(run 5)、形式だけの指示を見分ける規則と few-shot(run 6)を経て、実質正解は29/30になりました。
| run | 変更 | 実質正解 |
|---|---|---|
| 1 | 初版 | 25/30 |
| 2 | プロンプト修正 | 25/30 |
| 3 | 設問の曖昧さを解消(q01・q07 に「一般名で集計」)、Opus 5 と比較 | 27/30 |
| 4 | 用語辞書と few-shot の改訂 | 28/29 |
| 5 | 評価の30問目のタイムアウトを修正 | 29/30 |
| 6 | 形式だけの指示の規則と few-shot 2例 | 29/30 |
| 7 | 採点に別の正解の形(q17・q21) | 30/30 |
run 4 の分母が29なのは、29問目まで終わったところで API の読み取りタイムアウトで止まったためです。結果を1問ごとに保存していたので、それまでの分は失わずに済みました。例外の受け方を直したのが run 5 です。
4-4. run 6 の結果と q21
run 6 の結果は次のとおりです。
- 実質正解 29/30(96.7%)、厳密一致 11/30(36.7%)、所要 8.0分
- レベル別:L1 8/8、L2 12/12、L3 9/10
厳密一致は4割に届きません。実質正解との差の18問は、正解の行と値を含んだうえで、列か行が多いものです。2本立てにしたのは、この差を隠さないためです。
唯一の不正解が q21「オゼンピックの処方医数は2022年から2024年でどれだけ増えた?」でした。正解の SQL は年ごとの2行を返し、生成された SQL は差分の1行を返しています。数値は合っていて、違うのは答えの形です。
4-5. q21 を直す(run 7)
最後の1問を、この回のために実際に直しました。人がしたのは /guard-glossary-update q21 と打つこと、方針を承認すること、再評価を起動することの3つです。
分類。 エージェントは run 4〜6 の記録と採点のコードを読み、原因を「設問の曖昧さ」と分類しました。「どれだけ増えた」には、年ごとの2行でも、差分の1行でも正しく答えられます。ところが採点は、生成結果の行数が正解より少ないと、値を見る前に不正解にしていました。q21 の答えの形は回ごとに揺れていて、run 6 はたまたま1行で答えていました。
同型。 設問を検索し、q17「2022年から2024年で全国の総薬剤費はどれだけ増えた?」が同じ形だと、促されずに見つけました。q17 は run 6 では通っていましたが、差分1行で答えた回には同じ理由で落ちます。4-2 の直し漏れと同じ轍を踏まない動きです。
提案と、退けた案。 直すのは評価の側だけで、プロンプトには触れない、という提案でした。
| 案 | 判断 |
|---|---|
設問に別の正解の形(accept_sql、差分1行)を足し、どちらかを満たせば実質正解にする |
採用 |
system.md で答えの形を決める |
退けた。テストに合わせてアプリを縛ることになり、q26 と同じ道 |
| 正解 SQL を差分1行に書き換える | 退けた。今度は年ごとの2行の答えが落ちる |
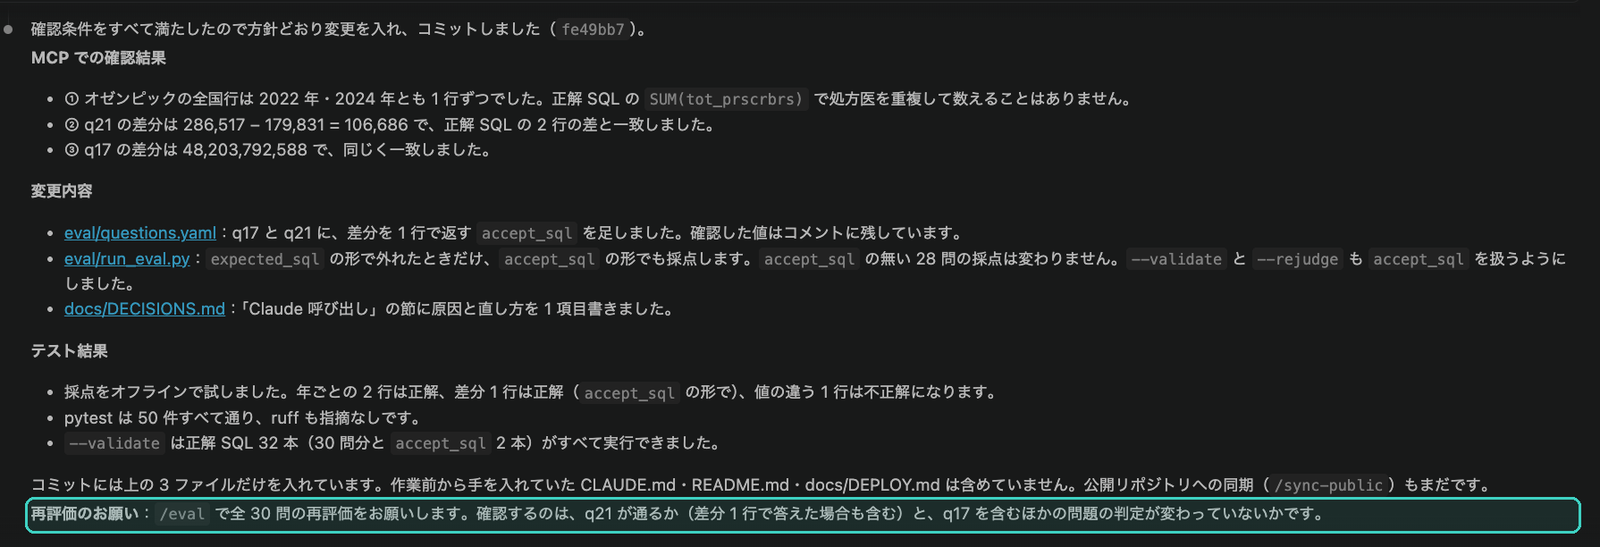
実データ。 値は MCP で BigQuery に流して確かめました。オゼンピックの全国の行は各年1行で、q04 のような重複はありません。2022年は179,831人、2024年は286,517人で、差は106,686人です。q17 の差も正解 SQL の結果と一致しました。
途中で BigQuery の MCP が接続できなくなりました(認証の期限切れ)。エージェントは値を書かず、確認用の SQL を示して止まりました。人が認証を取り直してから、続きを進めています。
確認と停止。 pytest の50件、ruff、正解 SQL 32本(30問と accept_sql 2本)の実行確認を通してコミットし、「全30問で再評価をお願いします」と依頼して止まりました。--limit は先頭 N 問しか流さないので、後ろの q17・q21 を確かめるには結局全問になる、という説明つきです。
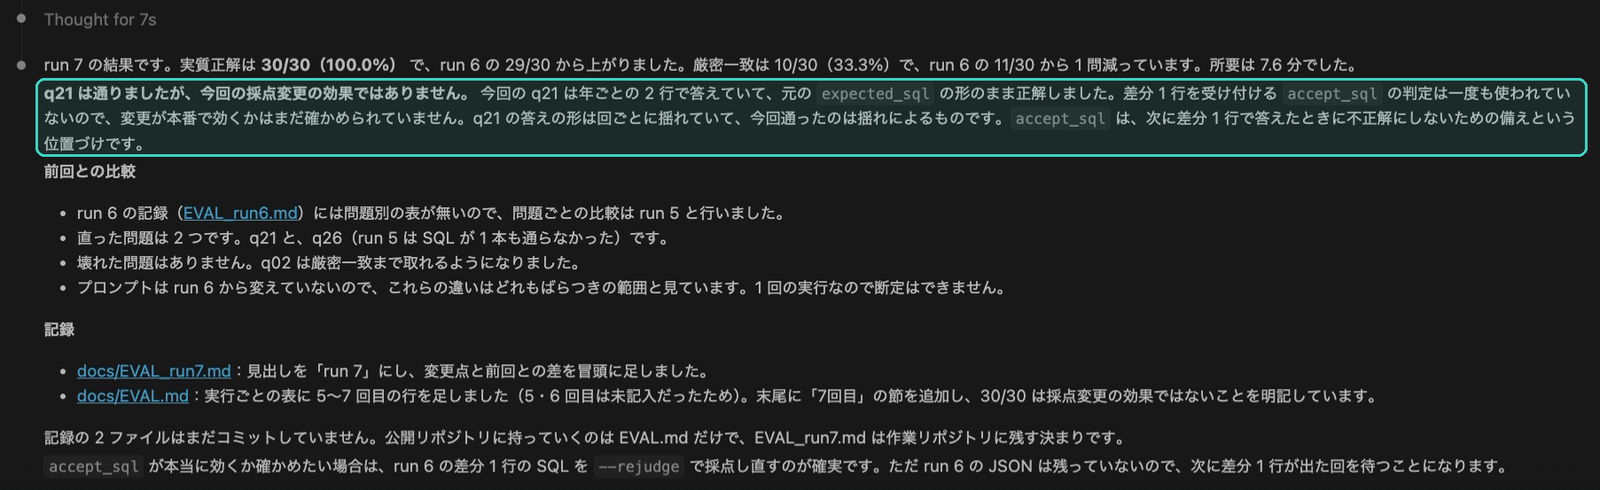
run 7。 人が /eval で再評価しました。
| 実質正解 | 厳密一致 | 所要 | |
|---|---|---|---|
| run 6 | 29/30 | 11/30 | 8.0分 |
| run 7 | 30/30 | 10/30 | 7.6分 |
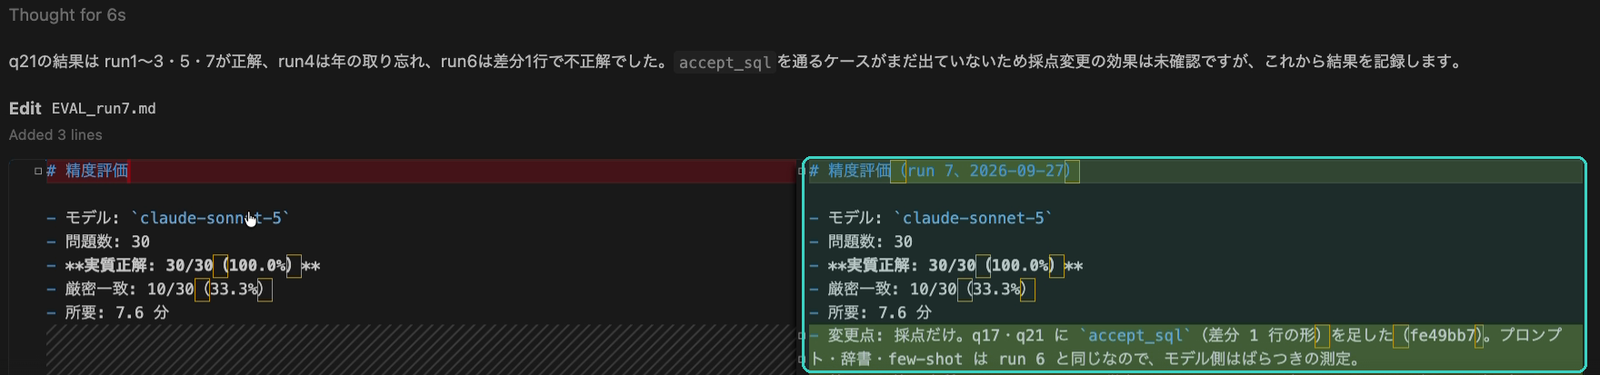
実質正解は初めて30/30になりました。ただし、エージェントの報告はこう始まっていました。q21 は通ったが、今回の採点変更の効果ではない。 run 7 の q21 は年ごとの形(4列)で答えていて、元の正解 SQL の形のまま通っていました。足した accept_sql は一度も使われていません。今回通ったのは答えの形の揺れによるもので、プロンプトは run 6 から変えていないので、違いはばらつきの範囲、1回の実行では断定しない、と書いています。
accept_sql は、次に差分1行で答えた回に正しく採点するための備えです。効いたかどうかは、その回が来るまで分かりません。
4-6. ばらつきを断定しない
Sonnet 5 以降は、temperature を指定できません(送ると 400 エラーになります)。同じ質問でも、生成される SQL が回ごとに変わることがあります。
そのため、1問が直った・壊れたという結果だけで、修正の効果を断定しません。同じ条件で複数回まわしていないなら「ばらつきの可能性がある」と書き残します。run 7 の30/30は、この約束が実際に働いた例です。数字が上がったときほど、何が効いたのかを確かめます。
5. 評価と改善の skill 化
5-1. 文書だけのとき
skill が無いとき、評価と修正は人の記憶に頼っていました。
- 評価は、人が
run_eval.pyを叩き、結果の見出し・変更点・前回との差をdocs/EVAL.mdに書き足していた - 落ちた質問の直し方は、EVAL.md の反省文に散らばっていた。次に落ちたとき、人が読み返して判断していた
この2つを、/eval と /guard-glossary-update の2本の skill にしました。
5-2. /eval:人だけが起動する
/eval は、30問を流して前回の run と比べ、記録を残すまでの手順です。
| 手順 | 内容 |
|---|---|
| 1. 何を測るか | 前回から変わったプロンプト・辞書・設問を、先に書き出す。変更が無ければ「ばらつきの測定」と書く |
| 2. run 番号 | 既存の記録の最大番号に1を足す。一部の問題だけ流すときは番号を付けない |
| 3. 実行 | 時間と課金がかかることを一言添えてから流す |
| 4. 前回と比べる | 直った ID・壊れた ID・落ちたままの ID を並べ、壊れた問題の原因を分類する |
| 5. 記録 | docs/EVAL_run<N>.md と docs/EVAL.md の履歴に追記する |
守ることとして、次の3つを書いています。skill の中でプロンプトや辞書を直さない(直すかどうかは結果を読んだ人が決める)、正解率は2本立てで語る、ばらつきを断定しない。
/eval は、frontmatter に disable-model-invocation: true を書き、人だけが起動できる skill にしました。30問を流すと Anthropic API の課金が出て、8〜9分かかるからです。
5-3. /guard-glossary-update:再評価の手前で止まる
/guard-glossary-update は、落ちた質問を起点に、直す場所を決めて最小の差分を入れる手順です。こちらは人も Claude も起動できます。
- 生成された SQL を読み、3章の7分類に当てる
- 正しい答えを、BigQuery の MCP で実データから出す。辞書に書く値は、実行して見たものだけ。MCP が使えないセッションでは値を書かずに止まる
- 差分を1か所だけ入れる
- yaml の構文と
pytestを通す - 再評価を人に依頼して止まる
SKILL.md の末尾には、4章の実例(q04・q26・q18、Opus 5 でも直らなかったこと)を「踏んだ実例」として入れています。次に落ちたとき、人が EVAL.md の反省文を読み返す代わりに、エージェントがこの実例を読みます。
実際の動き(q21)は 4-5 のとおりです。分類、同型の発見、実データでの確認、差分、テストまでを進め、再評価の手前で止まりました。
5-4. 課金の境目が、起動者の境目
2本の skill は、課金の出る操作の手前で分かれています。
| 操作 | 課金 | 誰が起動するか |
|---|---|---|
| 分類、実データの確認、差分、テスト | BigQuery の読み取りのみ(MCP の上限つき) | 人と Claude(/guard-glossary-update) |
| 30問の再評価 | Anthropic API | 人だけ(/eval) |
修正する skill は、再評価が必要になったところで止まり、人に「全30問で再評価をお願いします。見るのは q21 が直ったかと、同じ分類の他の問題が壊れていないか」と依頼します。人は依頼を読んで /eval を起動するかを決めます。
5-5. skill は1回実行してから信用する
2本の SKILL.md は、会話の履歴を持たないサブエージェントに読ませて、書いたとおりに動くかを確かめました。
/eval --limit 2:2問とも正解、0.4分。部分実行なのでdocs/EVAL.mdには触らなかった/guard-glossary-update q04:分類は「集計誤り」、直す場所はglossary.yamlのterms。MCP の無いセッションだったので、値を書かずに確認用の SQL を示して止まった
このとき、SKILL.md と実際の仕様の食い違いが見つかりました。--limit の部分実行は記録用のファイルを更新しない、run 4 以前は個別の記録ファイルが無い、などです。エージェントがコードを読んで書いた手順でも、実行しないと引数の仕様までは合いません。Part2・3 と同じく、skill は1回動かしてから信用します。
6. 記録と運用
6-1. DECISIONS.md
設計の判断は docs/DECISIONS.md に、日付を付けて「何を・なぜ」の形で残しています。確かめた公式ドキュメントの URL も一緒に書きます。評価で決めたこと(既定のモデルを Sonnet 5 にした根拠、辞書の書き換え)も、ここに入ります。
EVAL.md が「何が起きたか」、DECISIONS.md が「なぜそうしたか」の記録です。長い作業の指示書では、エージェントに最初に DECISIONS.md を読ませています(Part3)。
6-2. 構造化ログ
アプリは、1つの質問を処理し終えるたびに question_done というイベントをログに出します。その中の sql_rerun を見ると、「折れ線にして」のような形式だけの指示で SQL を再実行していないかを確かめられます(Part3 の few-shot の効果)。
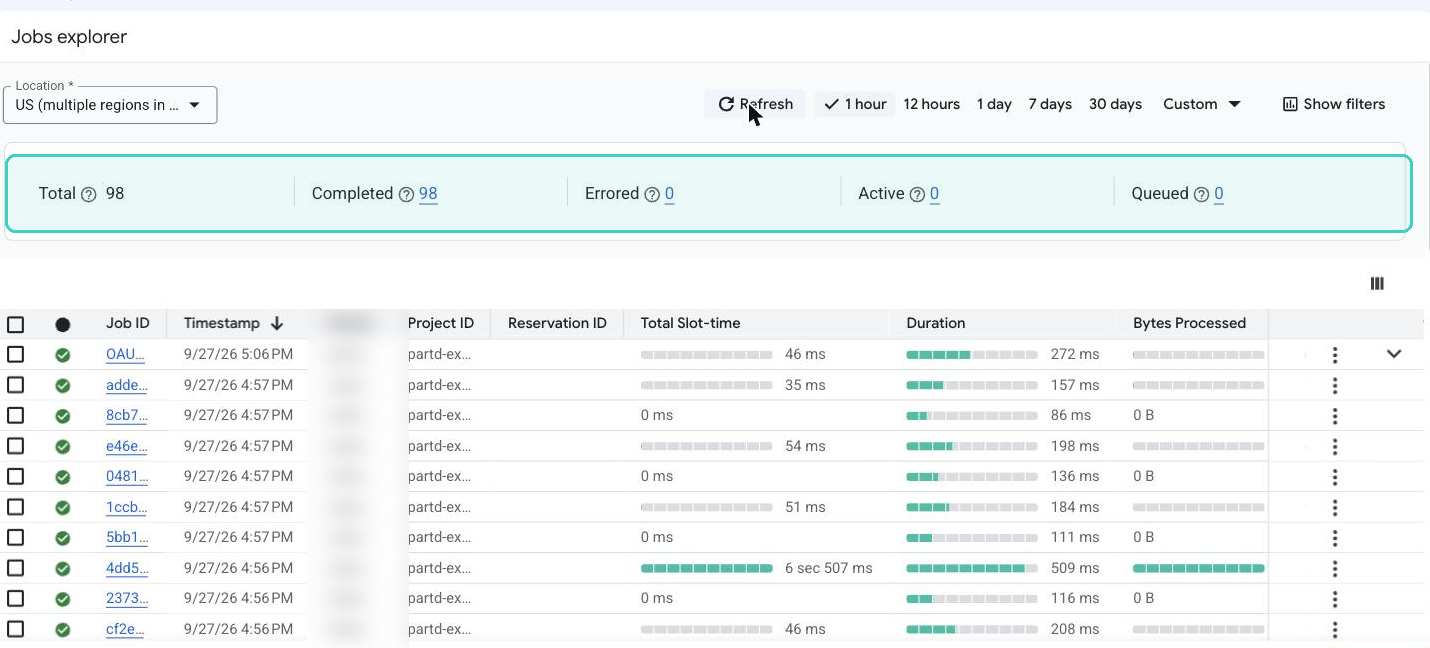
評価は用意した30問しか測れません。ログは、評価に入っていない実際の質問で、決めたとおりに動いたかを後から確かめる手段です。BigQuery 側では、ジョブ履歴で同じ時間帯のクエリが失敗していないかを確かめられます。
6-3. 表の有効期限
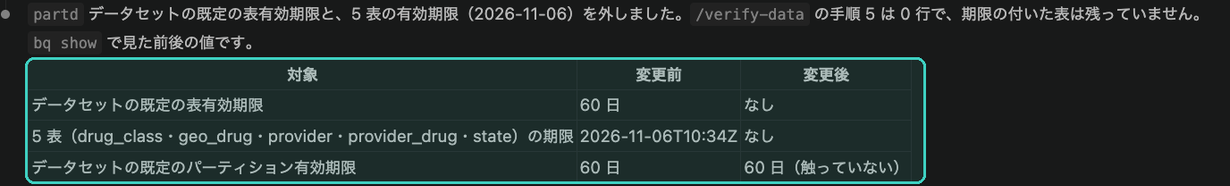
データの確認の skill(/verify-data)を動かしたとき、BigQuery の5つの表すべてに 2026-11-06 の有効期限が付いていることが分かりました。データセットの既定で、投入日から60日後に表が消える設定です。放置すると、アプリは11月に黙って壊れます。
/verify-data には、有効期限を確かめる手順を足しました。期限を外す操作(bq update)は、Part1 の settings で ask にしてあるので、人が実行します。
Part4 の公開前に、データセットの既定(60日)と5表の期限を bq update で外しました。bq のコマンドはどれも ask で止まるので、1本ずつ人が中身を確かめて承認してから実行しています。そのあと /verify-data の手順で、期限の付いた表が0件であることを確かめました。
同じ確認で、ドキュメントの総行数が足し算を間違えていたことも見つかりました(84,819,407 → 正しくは 85,167,407)。どちらも、評価の30問では見つからない種類の誤りです。
6-4. Cloud Run へのデプロイ
アプリは Cloud Run に置けます。一般公開はせず、権限を付けたアカウントだけが開ける形です。デプロイの手順も /deploy として skill にしてあり、本番への反映(--run)は settings の ask で必ず人の確認に止まります。
手順と、デプロイで踏んだ失敗(ヘルスチェックは通るのに質問だけが落ちた、など)は、番外編で詳しく説明します。
7. 第1作のハーネス
7-1. 今回のハーネス
| 道具 | このリポジトリでの実体 | 文書だけのとき人がやっていたこと |
|---|---|---|
| 評価セット | eval/questions.yaml(30問・3レベル、正解 SQL は実行して確認) |
何問か手で質問して、答えを目で確かめる |
| 判定 | eval/run_eval.py(結果の一致、実質正解と厳密一致) |
SQL を読んで、合っているかを判断する |
| skill | /eval(人だけ)、/guard-glossary-update |
run_eval.py を叩いて EVAL.md に書き足す。反省文を読み返して直し方を決める |
| 記録 | docs/EVAL.md、docs/DECISIONS.md、question_done ログ |
何を変えて何が起きたかを覚えておく |
| 権限と停止条件 | /eval は人だけ、表の有効期限を外すのは ask |
課金の出る操作と、壊れる設定を覚えておく |
7-2. 第1作の総覧
Part0 から Part4 までで組んだハーネスを、1つの表にまとめます。
| 要素 | 実体 | 回 |
|---|---|---|
| プロジェクト文書 | CLAUDE.md、設計書、データ辞書、DECISIONS.md、HARNESS.md |
Part2 |
| 権限と停止条件 | .claude/settings.json の allow / ask / deny |
Part1 |
| MCP | BigQuery(MCP Toolbox、読み取り専用・1クエリ 2 GiB 上限・専用のサービスアカウント) | Part1 |
| skill | cms-csv-to-bigquery、verify-data、display-check、eval、guard-glossary-update、deploy(ほかに作業リポジトリだけの sync-public) |
Part2〜4 |
| hook | ガードの自動テスト、ruff・tsc、課金ゲート |
Part3 |
| 評価 | 精度評価30問、ガードの単体テスト50ケース | Part3・4 |
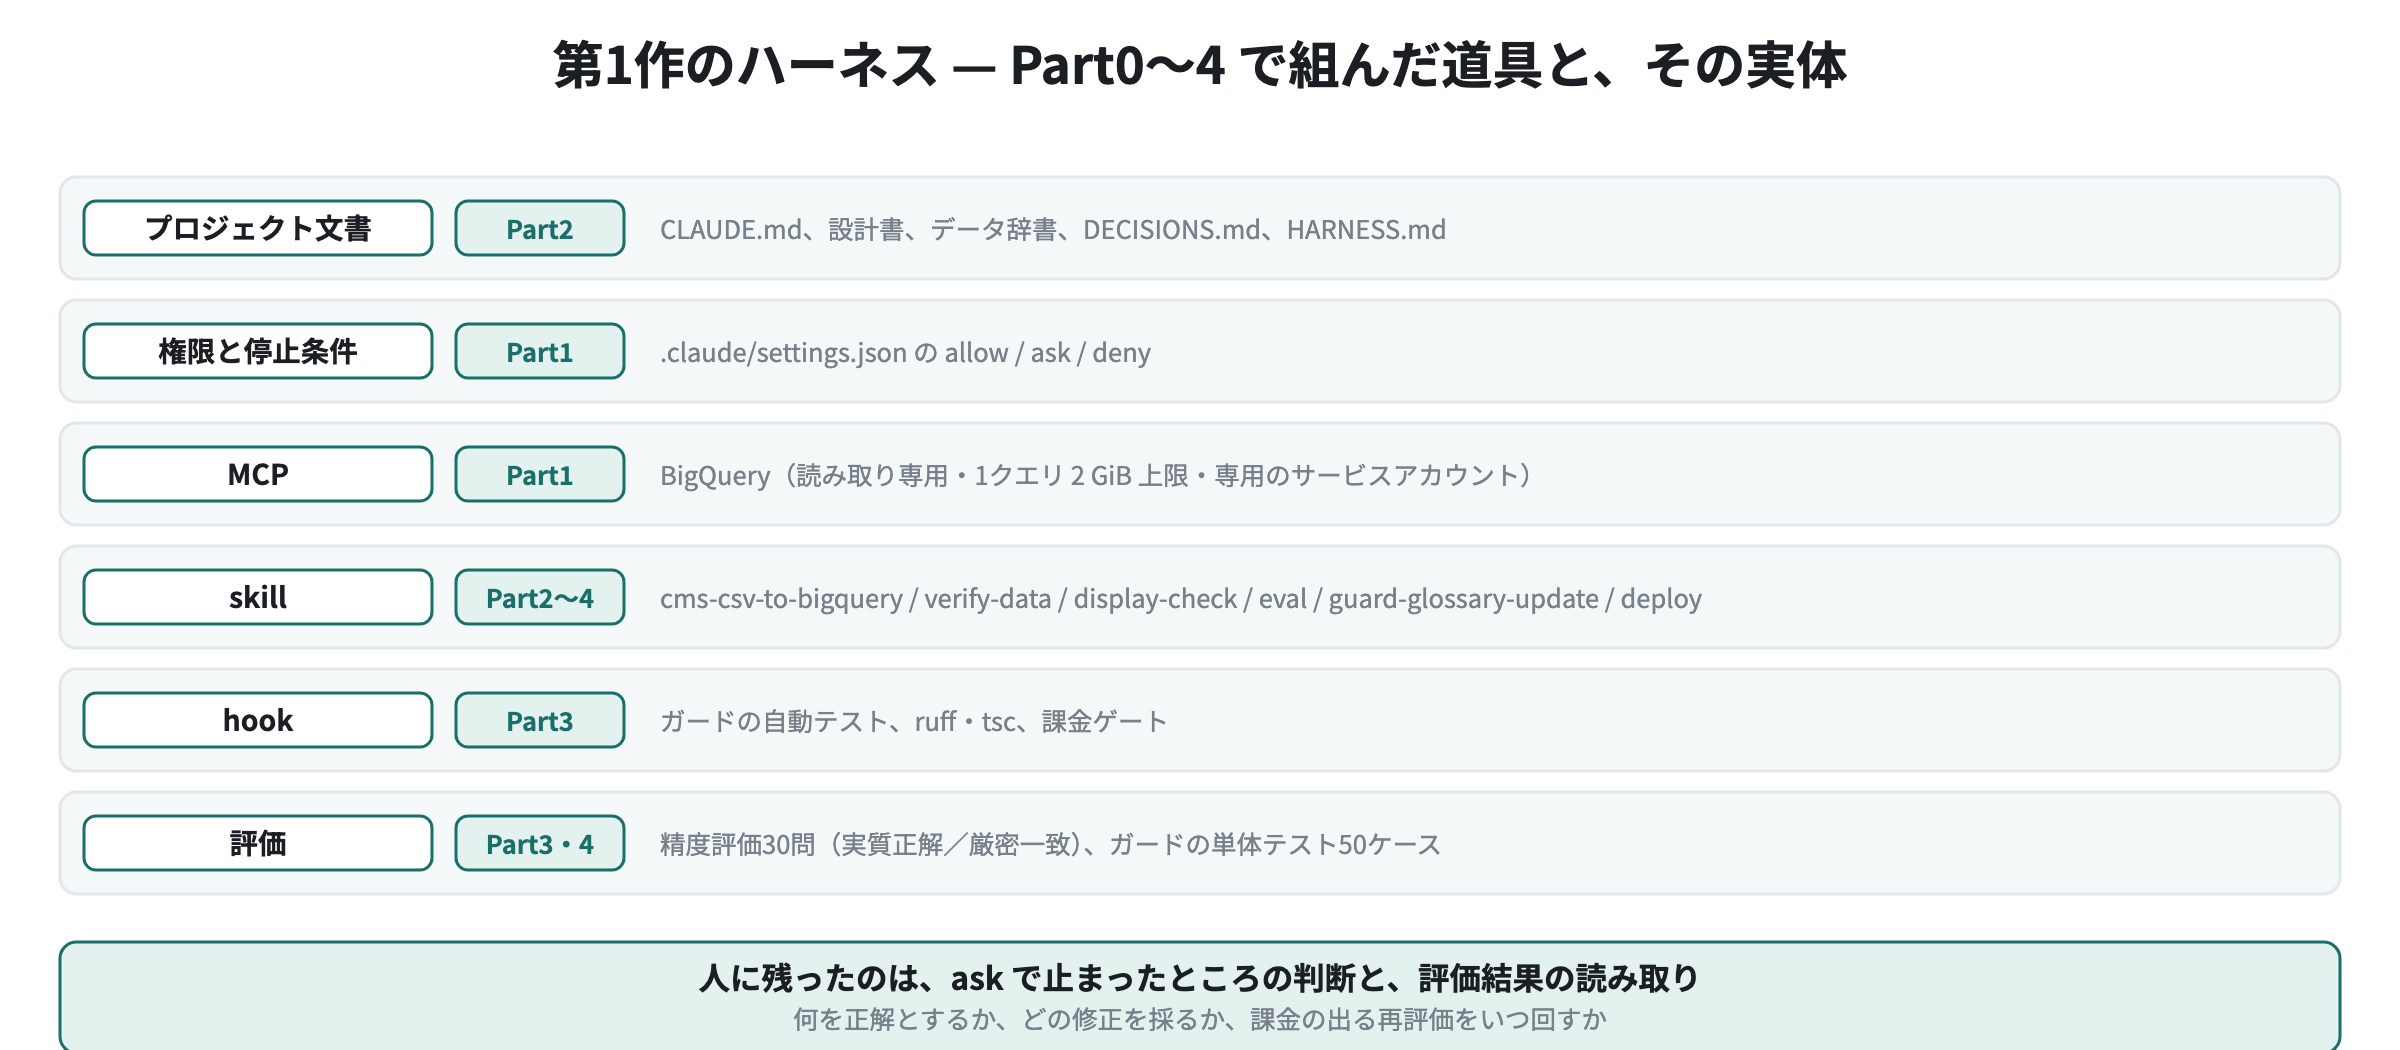
人に残ったのは、ask で止まったところの判断と、評価結果の読み取りです。何を正解とするか、どの修正を採るか、課金の出る再評価をいつ回すかは、最後まで人が決めました。
7-3. 第2作へ持ち越すもの
第2作では、題材を変えて同じ型を使います。
| 持ち越すもの | 使い方 |
|---|---|
eval と guard-glossary-update |
「評価 → 失敗の分類 → 直す場所 → 再評価は人」の型はそのまま。題材に固有の値(列名、分類の実例)を外して汎用にする |
| 権限の設計 | 課金・外部影響のある操作を ask、読むだけのものを allow、鍵と破壊的な操作を deny |
| hook の構成 | 編集後の検査と、課金の前のゲート |
CSV を BigQuery に入れる cms-csv-to-bigquery は、第2作では使いません。第2作はデータベースへの問い合わせではなく、文献を読んで判定する業務が題材だからです。
8. まとめ
- 評価セットは先に、人が作る。 何を正解とするかは、アプリが答えるべきことを決める判断で、正解の SQL は実行して確かめる
- 判定は結果で、指標は2本。 実質正解 29/30 と厳密一致 11/30 を並べて見る
- 失敗は分類してから直す。 分類が直す場所を決める。差分は1か所、同じ型は全部見る。モデルを上げても、指示の側の誤りは直らない
- 課金の境目で止める。 直す skill は再評価の手前で止まり、再評価の skill は人だけが起動する
評価は、この連載で「事前に検証可能にしておく」ことを、いちばん直接に形にしたものです。30問の正解があったから、辞書の誤りが見つかり、修正で何が壊れたかが分かり、エージェントに直させる範囲を決められました。
任せられる範囲は、事前にどれだけ検証可能にしておいたかで決まります。
次のステップ
第1作はこの回で終わりです。第2作では、系統的文献レビューのスクリーニングを題材にします。論文の抄録を読んで採否を判定する業務を、エージェントに分担させます。主役は、段ごとに役割を分けたサブエージェントと、独立した2体の判定を裁定する仕組みです。第1作の評価と修正の型は、そのまま持ち越します。
出典
- Anthropic, Claude Code Docs(skills / settings)
- Anthropic, Claude API Docs(Models, Messages)
- CMS, Medicare Part D Prescribers Data Dictionary (data.cms.gov)
コードは GitHub で公開しています: github.com/HerzLeben/medicare-partd-text-to-sql