Claude Code × Medical Application
【Claude Code】系統的文献レビュー × AI サブエージェント Part4:考察と再現の手順
1. はじめに
連載の最終回です。Part1〜3 で、原著 TrialMind の3つの作業(検索・スクリーニング・データ抽出)を Claude Code で組み直し、1つずつ原著と並べました。Part4 では、それを束ねて本試行の問いに答え、読者が自分のリポジトリで同じ流れを動かせるようにします。
1-1. この回の目的
Part0 で立てた問いは「原著の手法を Claude Code で組み直し、同じ指標で測ると、原著と同じ水準になるか」でした。この回では次の3つを書きます。
| 中身 | |
|---|---|
| 考察 | 3つの作業を原著と並べて、言えること・言えないこと。人の判断を外して測ったことで見えた、判断の入れどころ |
| 組み方の棚卸し | 連載で使った subagent・skill・hook・MCP と、エージェントが手順どおりに動かなかったこと |
| 再現の手順 | 評価の skill /eval を人だけが起動する理由、サブスクリプションで回す設定、リポジトリを clone して同じ流れを動かす手順 |
この回の「再現」は、読者がリポジトリで同じ流れを動かすことの意味でだけ使います。Part0 で書いたとおり、本試行は原著の追試ではなく、「原著を再現した」とは書きません。
1-2. 3つの作業の総括
| 作業 | 指標 | 原著 | 本試行(人の判断なし) | 回 |
|---|---|---|---|---|
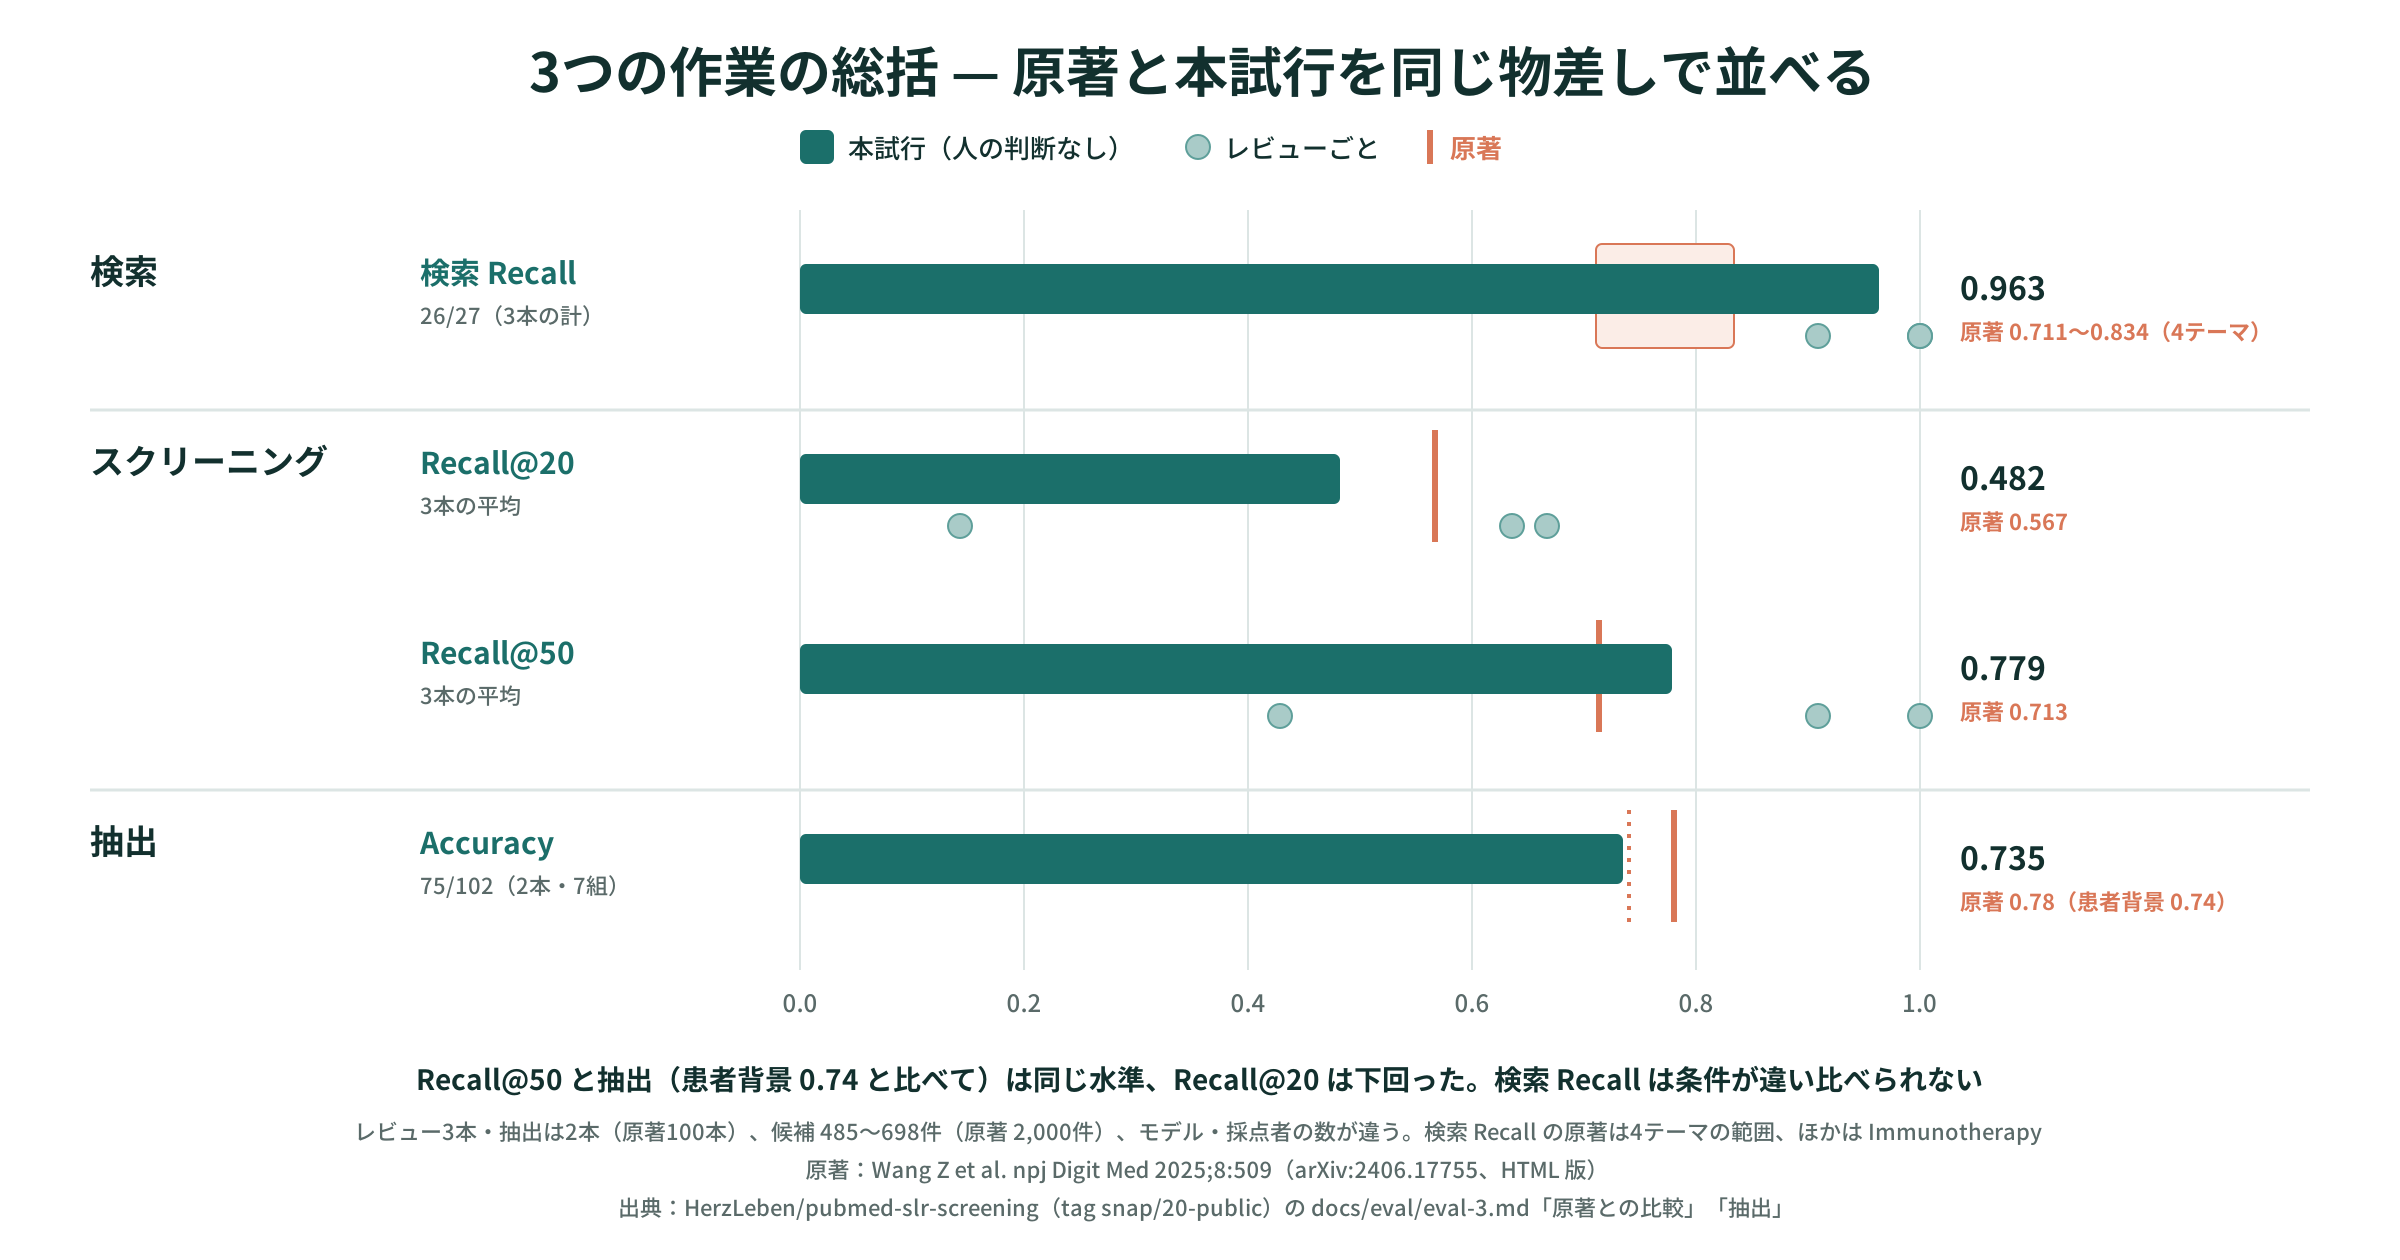
| 検索 | 検索 Recall | 0.711〜0.834 | 0.963(26/27) | Part1 |
| スクリーニング | Recall@20 | 0.567 | 0.482(3本の平均。合算 14/27) | Part2 |
| スクリーニング | Recall@50 | 0.713 | 0.779(3本の平均。合算 22/27) | Part2 |
| 抽出 | Accuracy | 0.78(患者背景 0.74) | 0.735(75/102。2本・7組) | Part3 |
原著の値は arXiv HTML 版で、検索 Recall は4つのテーマの範囲、ほかは Immunotherapy の値です。Recall@50 と抽出(患者背景の 0.74 と比べて)は原著と同じ水準で、Recall@20 は下回りました。検索 Recall は数字では上回りましたが、原著は候補を何件まで絞ったかを書いておらず、比べられる値ではありません(Part1)。
2. 原著と並べて言えること・言えないこと
作業ごとの言えること・言えないことは、各回の5章に書きました。3つを通すと、言えることは1つにまとまります。原著の3つの作業は、Claude Code の subagent・skill・hook で組み直せて、同じ物差しで測ると近い水準の値が出た。 原著の手法が、別のモデルと別の道具立てでも、少なくとも3本(抽出は2本)のレビューでは同じように働いた、ということです。
言えないことも、3つの作業に共通しています。
- 原著と同じ性能だ、とは言えない。レビューは3本、抽出は2本(原著は100本)、モデルは現行の Claude Sonnet(原著は GPT-4 と Claude 3 Sonnet)、抽出の採点者は1人(原著は3人)
- SR の業務に使える、とは言えない。検索は PubMed だけ、全文は PMC だけで、抽出の項目に結果(アウトカム)は無い。Part0 の位置づけどおり、これは教材と手法の検証の道具です
- 1回の結果である。PubMed の relevance 順は呼び出しによって変わり、同じ式でも取れる順番が変わりました(Part1)。同じ手順を回しても、同じ数字になるとは限りません
3. 人の判断の入れどころ
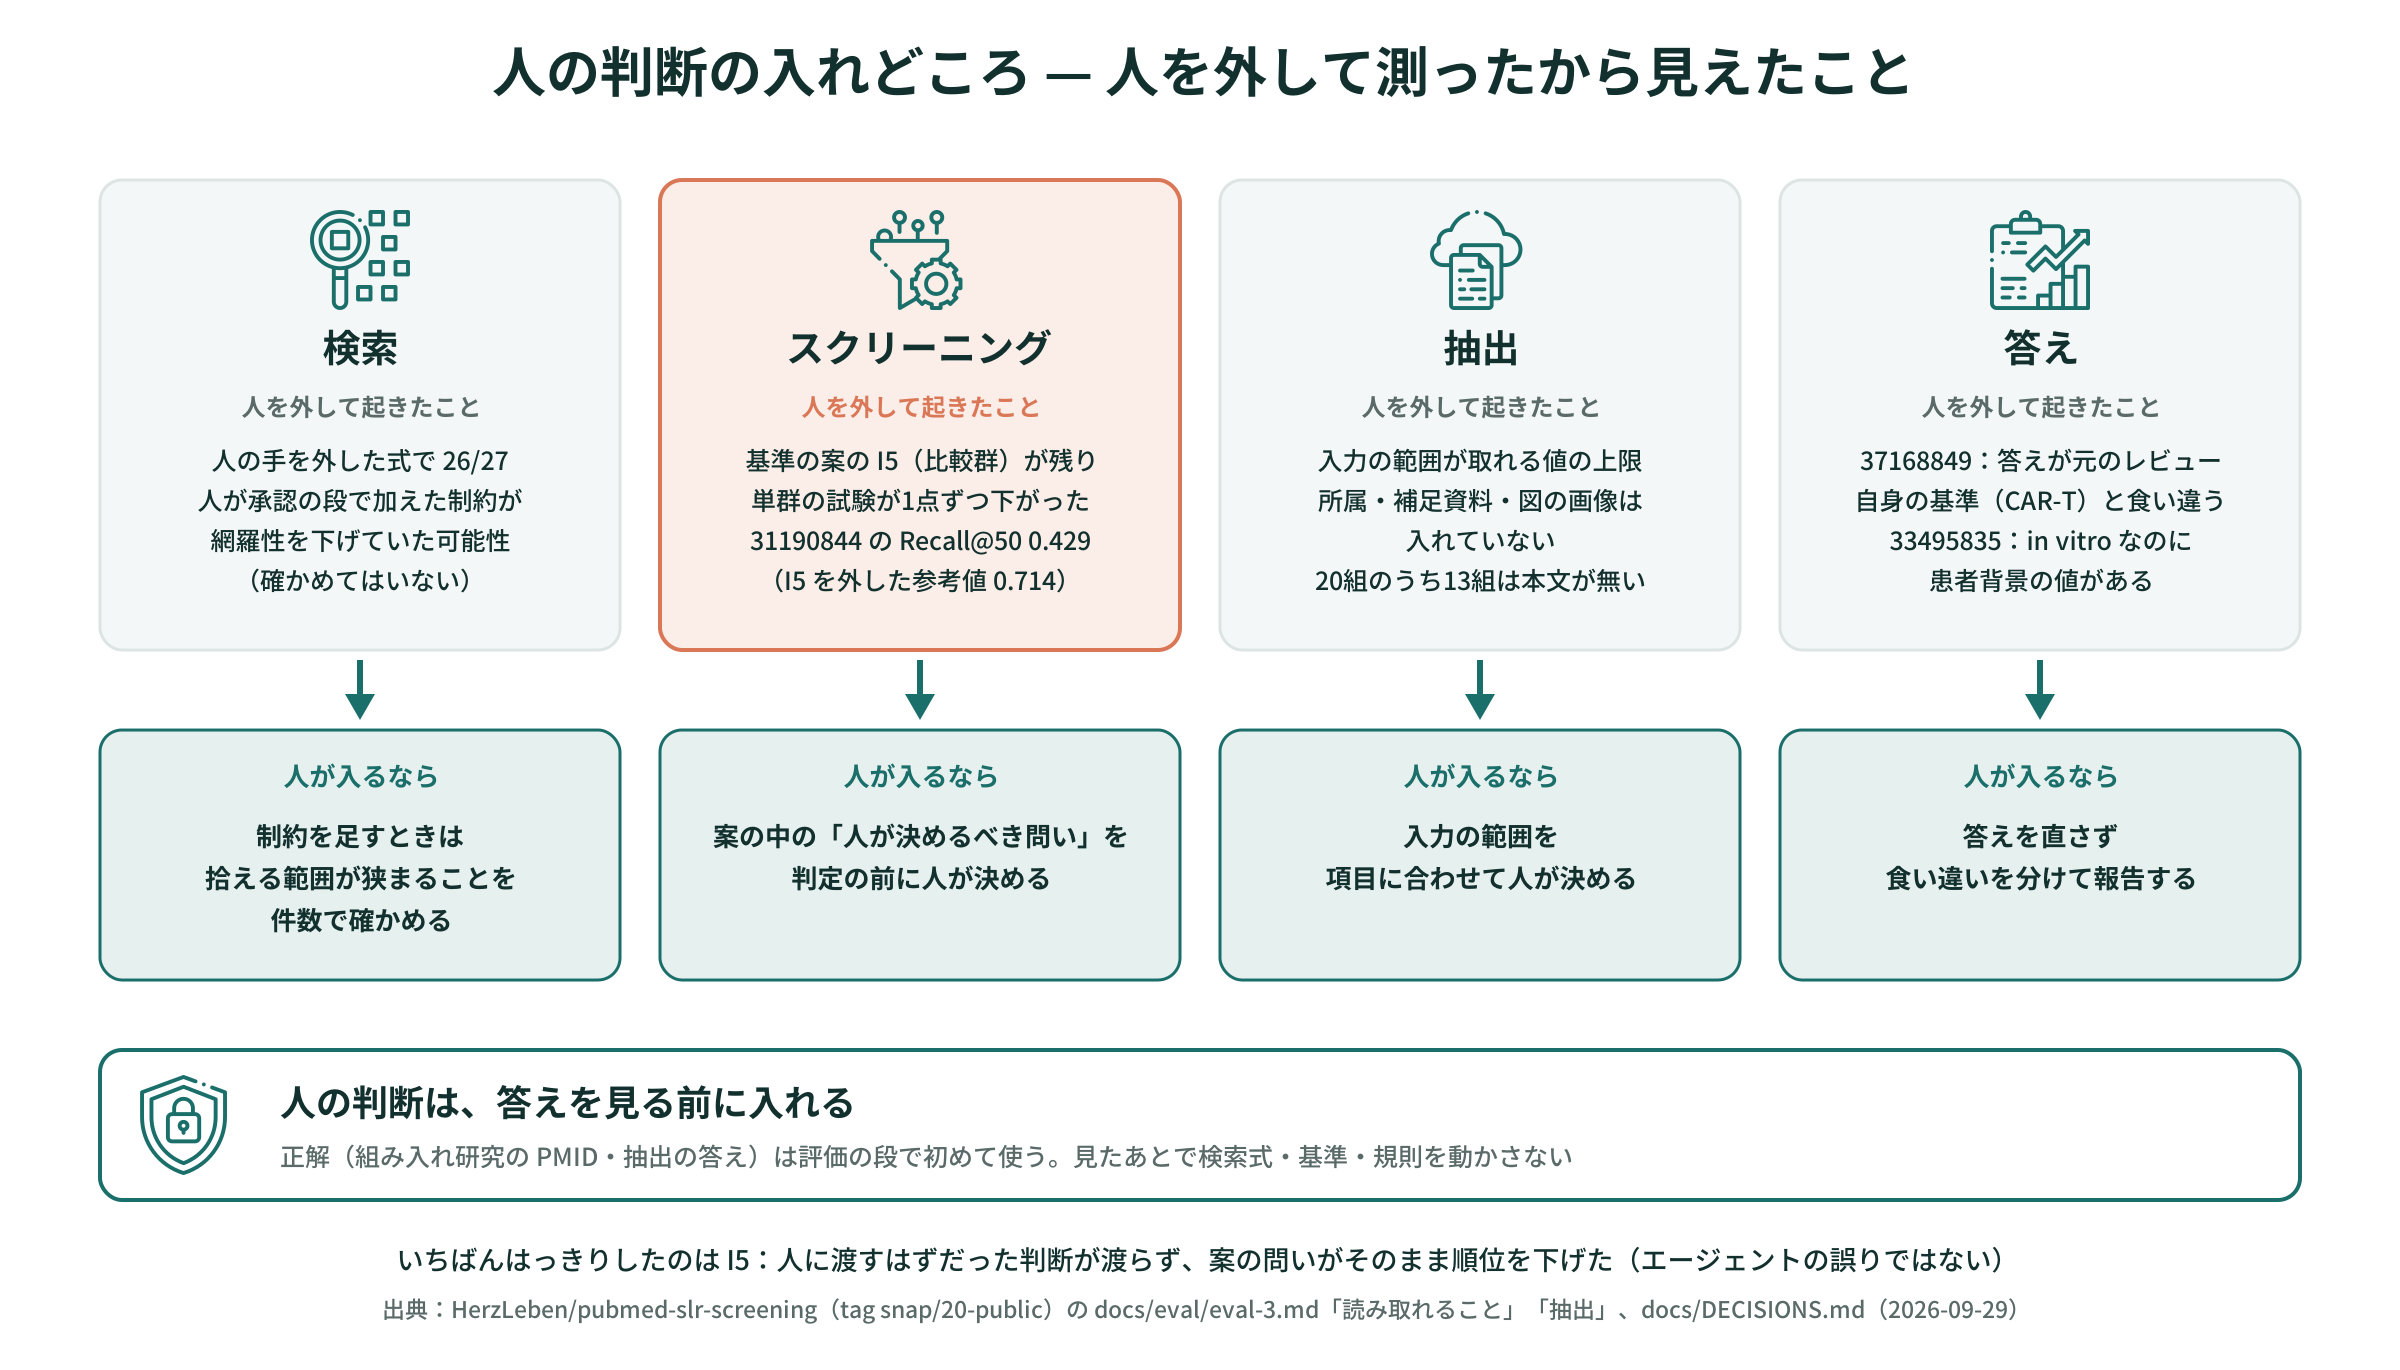
本試行は、原著と比べるために人の判断を外した流れで測りました。外したからこそ、人の判断がどこで効くのかが見えました。
| 段 | 人を外して起きたこと | 人が入るなら |
|---|---|---|
| 検索 | 人の手を外した式で 26/27。リポジトリの記録には、人が承認の段で式に加えた制約(ブロックの形や語の指定)が網羅性を下げていた可能性も書かれている(確かめてはいない) | 制約を足すときは、その分だけ拾える範囲が狭まることを件数で確かめる |
| スクリーニング | 基準の案の I5(比較群)が残り、単群の試験が1点ずつ下がった。31190844 の Recall@50 は 0.429(I5 を外した参考値は 0.714) | 案の中の「人が決めるべき問い」を、判定の前に人が決める |
| 抽出 | 何を入力に入れるか(所属・補足資料・図の画像)が、取れる値の上限を決めた | 入力の範囲を、項目に合わせて人が決める |
| 答え | 37168849 では答えが元のレビュー自身の基準(CAR-T)と食い違い、33495835 は in vitro なのに患者背景の値があった | 答えを直さず、食い違いを分けて報告する |
いちばんはっきりしたのは、スクリーニングの I5 です。基準の案を書いた skill は、I5 を「採否は人が決める」問いとして残していました。人がいれば外していた問いが、人を外した流れではそのまま順位を下げました。エージェントの誤りではなく、人に渡すはずだった判断が渡らなかったのです。
逆に、人が入ってはいけない所もあります。答えを見たあとで検索式・基準・規則を動かすことです。本試行では、答えを見たあとに直すと評価が意味を失うので、どの段もそのまま記録しました。人の判断は答えを見る前に入れる、が連載を通した決まりです。
4. この連載の組み方
4-1. 使ったもの
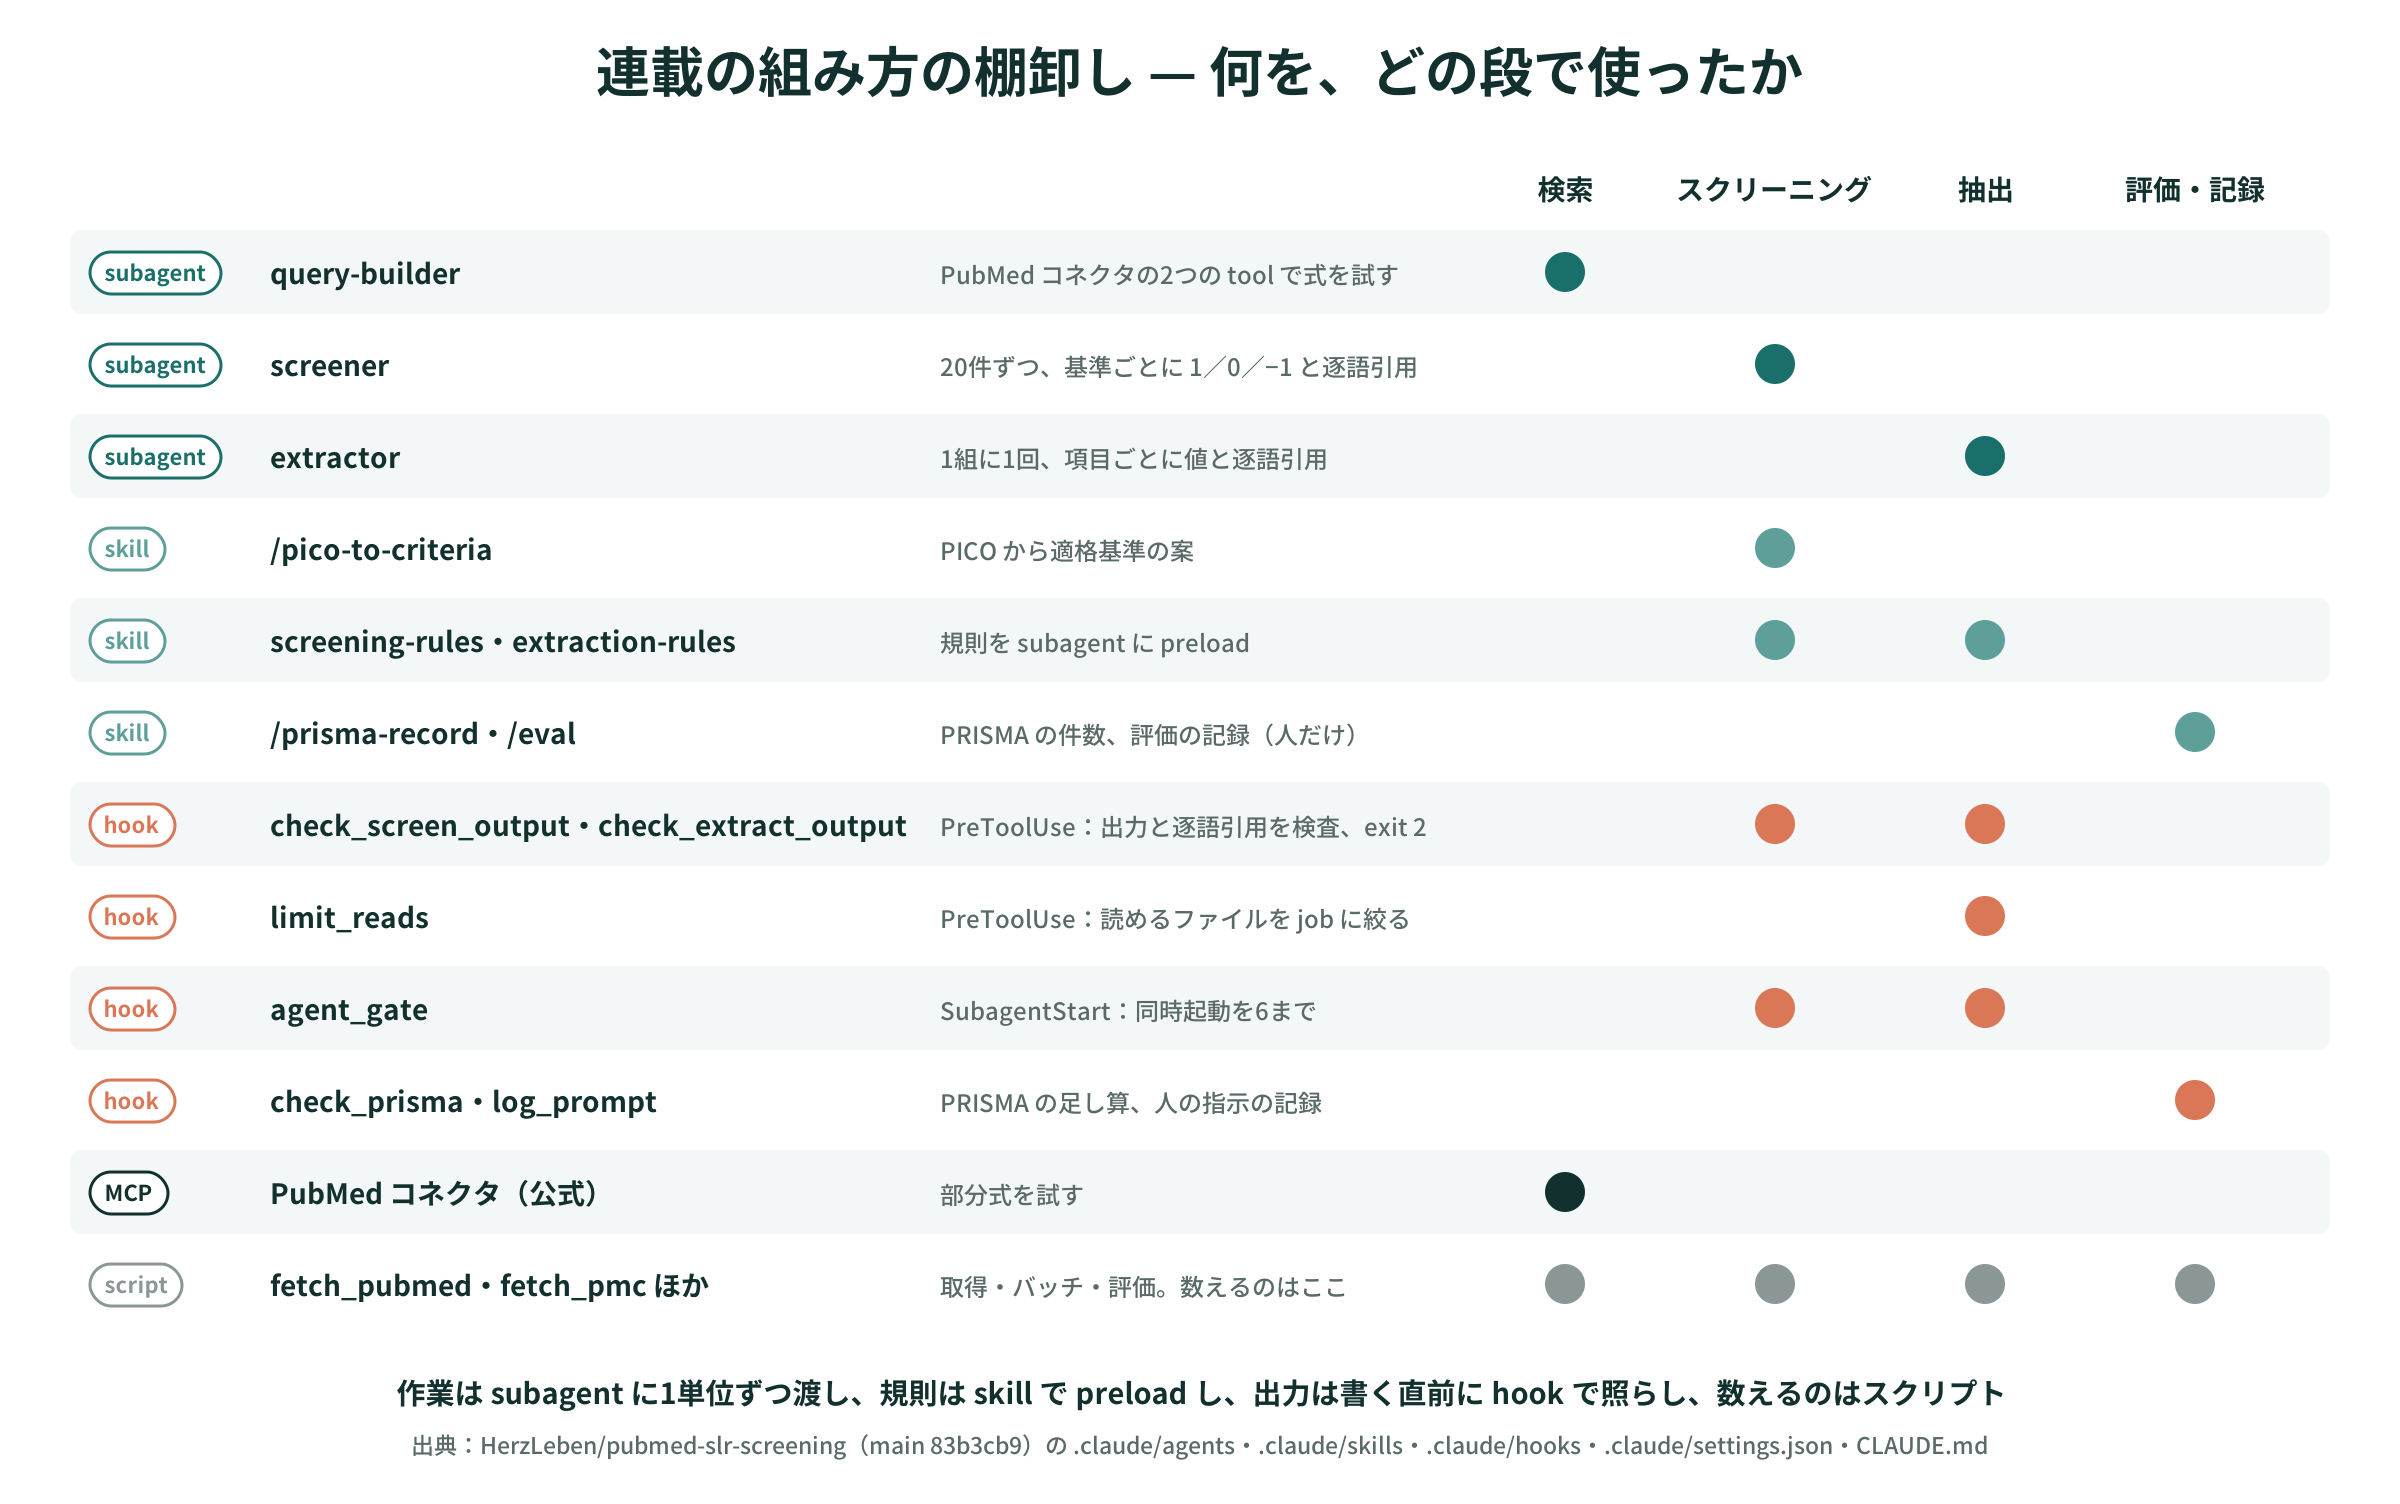
| 種類 | 名前 | 段 | 役目 |
|---|---|---|---|
| subagent | query-builder |
検索 | PubMed コネクタの2つの tool だけで検索式を試す |
| subagent | screener |
スクリーニング | 20件ずつ、基準ごとに 1/0/−1 と逐語引用 |
| subagent | extractor |
抽出 | 1組に1回、項目ごとに値と逐語引用 |
| skill | /pico-to-criteria、screening-rules・extraction-rules、/prisma-record・/eval |
全体 | 基準の案、規則の preload、PRISMA の件数、評価の記録 |
| hook | check_screen_output.py・check_extract_output.py・limit_reads.py |
スクリーニング・抽出 | 出力と逐語引用の検査、読めるファイルの制限(PreToolUse) |
| hook | agent_gate.py・check_prisma.py・log_prompt.py |
全体 | 同時起動の上限、PRISMA の足し算、人の指示の記録 |
| MCP | PubMed コネクタ(公式) | 検索 | 部分式を試す。一括取得はスクリプト |
形は3つの作業で共通です。作業は subagent に1単位ずつ渡し、規則は skill で preload し、出力は書く直前に hook で照らし、数えるのはスクリプト。エージェントに任せたのは「読んで書く」所だけで、数字はすべてスクリプトの出力から写しました。
4-2. 手順どおりに進まなかったこと
| 回 | 起きたこと | どう扱ったか |
|---|---|---|
| Part1 | query-builder は「予備検索の抄録から語を拾う」と定義にあるのに、抄録を読まずに式を作った |
記録を一字も変えずに残し、言えないことに書いた |
| Part2 | /eval は人だけが起動する決まりだが、eval-3 の評価は人の指示を受けた別のセッションがスクリプトを直接実行した |
結果・基準・検索式は変えていないことを記録した |
| Part3 | 途中で足した agent 定義が読み込まれず、試走が止まった。extractor の報告と出力の数が食い違った | 代用せず再起動した。報告ではなく出力を正とした |
| 全体(eval-3 より前の試行) | 本体が動いている subagent の数を数え違え、7体目を起動しかけた | Claude Code 組み込みの上限が止めた |
| 公開の準備 | 履歴の書き換え(git filter-repo)は auto mode の安全チェックで止まった |
人がターミナルで打った |
定義に書いたことと実際の動きは別です。気づけたのは、出力をファイルに残し、hook とスクリプトで照らし、想定と違ったことをその場で docs/HARNESS.md に1行ずつ書いていたからでした。
5. /eval を人だけが起動する理由
5-1. 設定
評価の skill は .claude/skills/eval/SKILL.md にあり、frontmatter で disable-model-invocation: true を指定しています。こうすると、Claude が自分の判断でこの skill を呼ぶことはできず、人が /eval と打ったときだけ動きます。
name: eval
disable-model-invocation: true
argument-hint: <eval の名前(例:eval-4)> [--run eval-3] [--results <dir>]
手順は5つです:0 前提を確かめる(同じ名前の記録が無いか、検査の警告が 0 件か)→ 1 何を測るかを先に書く → 2 スクリプトの出力から写す(手で数えない)→ 3 前回・原著と比べる → 4 取りこぼしを分類する → 5 記録して止まる。commit と tag は人の指示を待ちます。
5-2. 理由
評価は、正解(組み入れ研究の PMID と抽出の答え)を初めて使う段です。SKILL.md にも、正解はこの段で初めて使うこと、判定や抽出の値を正解に合わせて直さないことを書きました。
エージェントが自分の判断で評価を回せると、途中で正解を見て、検索式や基準を直す機会が生まれます。答えを見るタイミングを人が握れば、答えを見る前の手順と見たあとの記録が分かれます。Part0 の「評価の全件実行は人だけが起動する」を、設定で固めたものです。
ただし、4-2 の表のとおり、eval-3 の評価そのものはこの skill を通っていません。人の指示を受けた別のセッションが、同じスクリプトを直接実行しました。設定で止められるのは「Claude が自分から呼ぶこと」だけで、人の指示で同じスクリプトを打つことまでは止まりません。最後の歯止めは、記録に残すことでした。
5-3. clone しただけでは評価できない
まっさらな clone で、/eval の 0章が前提の確認に使うコマンドを打つと、どちらも次の1行を出して止まります。
results/eval-3/ が無い。results/ は commit されない。CLAUDE.md の「データの流れ」の順に作る判定・候補・抽出の採点は results/ に書かれ、commit していません。評価は、自分で流れを回して results/ を作ってから打つものです。なお、/eval そのものを人が打って動きを確かめた記録は、まだありません。
6. サブスクリプションで回す設定
6-1. API キーを置かない
このリポジトリは、Claude Code を Pro か Max のサブスクリプションで動かす前提です。README の「必要なもの」に、次の1行を太字で入れています。
ANTHROPIC_API_KEYは設定しない(設定すると API の従量課金になる)
公式ドキュメントによると、環境変数 ANTHROPIC_API_KEY があると、Claude Code はサブスクリプションより先にそのキーを使います。対話モードでは最初に一度、使うかを聞かれ、その答えが記憶されます。-p の非対話モードでは聞かれずに使われます。subagent を数十〜百回起動する流れで一度うっかり承認すると、そのまま従量課金で回ることになります。どちらで動いているかは /status で確かめられます。指示書でも「設定されていたら止まる」を止まる条件に入れ、Part2 と Part3 の全件の前に「未設定」を確かめて記録しました(値は見ずに、有無だけ)。
6-2. 同時起動の上限を二重に掛ける
サブスクリプションには使用量の上限があります。一度に多くの subagent を起動すると、上限に早く届き、途中で止まります。.claude/settings.json では、同時起動を6までにしています。
"env": {
  "CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS": "6",
  "CLAUDE_CODE_MAX_SUBAGENT_SPAWN_DEPTH": "1"
}
これに加えて、SubagentStart の hook agent_gate.py が、動いている subagent を印のファイルで数え、6体動いていれば7体目の起動を exit 2 で止めます。上限を Claude Code の設定とプロジェクトの hook の二重に掛けたのは、hook のほうが「CLAUDE.md の上限は6」と理由つきで止められること、組み込みの上限が数えない場合(終わった subagent を再開するとき)も hook は数えることの2つが理由です。実際、本体が数を数え違えて7体目を起動しかけたときは、組み込みの上限が先に止めました(4-2)。SPAWN_DEPTH=1 は、subagent がさらに subagent を起動しないようにする設定です。
6-3. 量の目安
記録に残っている量は次のとおりです(subagent 側のトークン数。本体の分は含みません)。
| 段 | 1回あたり | 回数 |
|---|---|---|
| スクリーニング(screener、20件) | 試走で約93秒・約3.6万トークン | 3本で95バッチ |
| 抽出(extractor、1組) | 16.7〜30.3秒・1.5〜3.1万トークン | 7組で約17.7万トークン |
subagent に分けても、総量は件数に比例して増えます。自分で回すときは、1バッチの試走で量を見てから全件に進んでください。
7. リポジトリで同じ流れを動かす手順
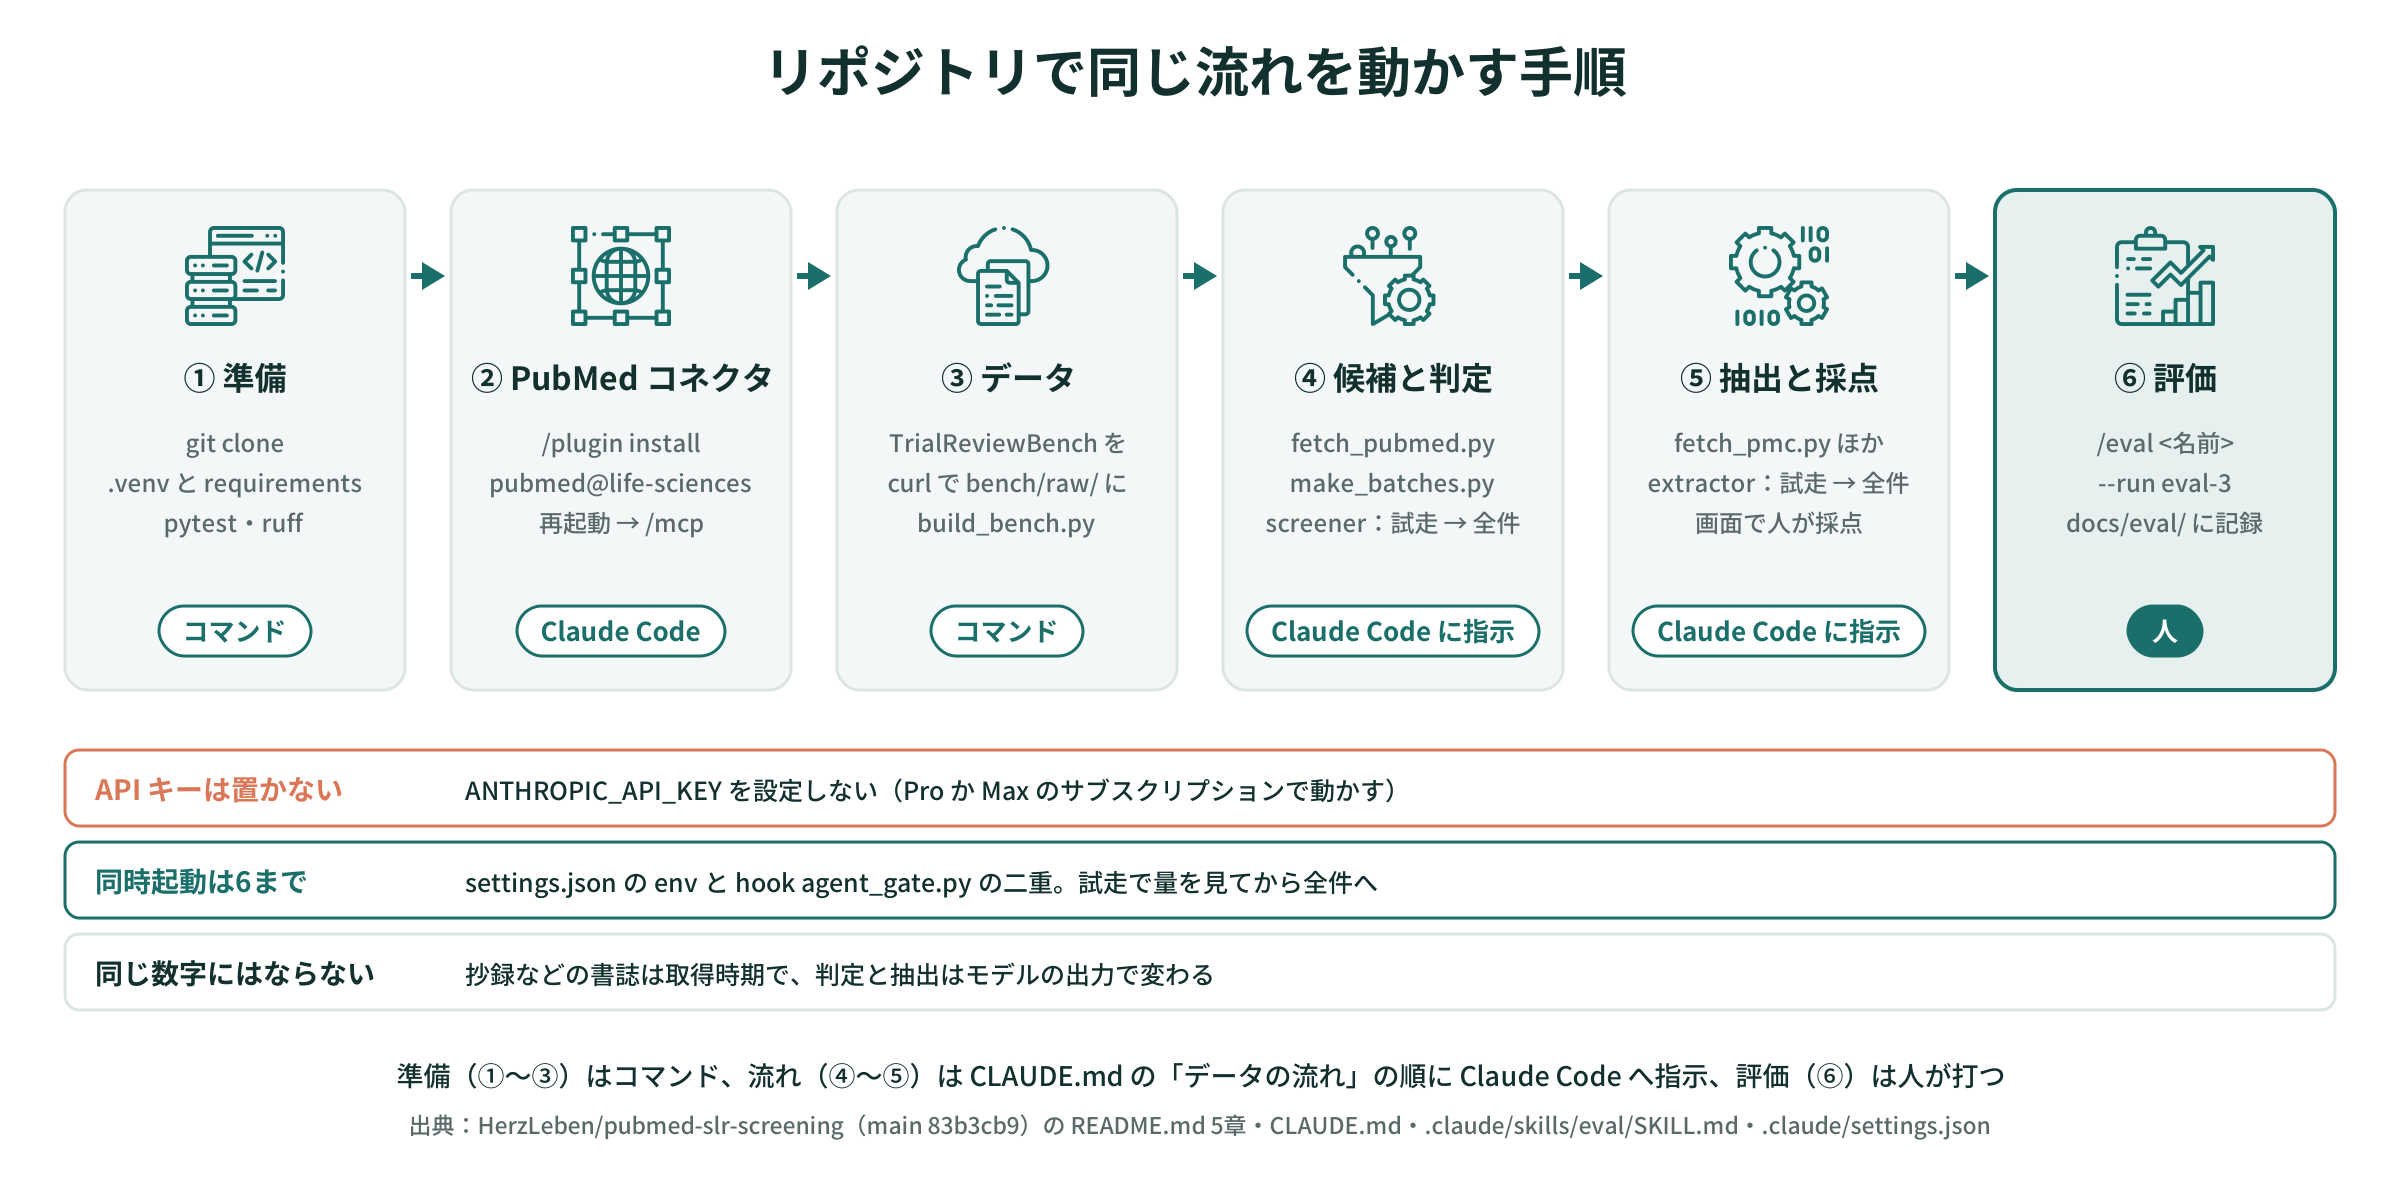
7-1. 準備
必要なものは、Claude Code(Pro か Max)、Python 3、公式の PubMed コネクタです。NCBI の API key と Node.js は任意です。
git clone https://github.com/HerzLeben/pubmed-slr-screening.git
cd pubmed-slr-screening
python3 -m venv .venv
.venv/bin/pip install -r requirements.txt -r requirements-dev.txt
.venv/bin/python -m pytest -q
.venv/bin/ruff check .
テストはネットワークを使いません。PubMed コネクタは Claude Code の中で入れます。
/plugin marketplace add anthropics/life-sciences
/plugin install pubmed@life-sciences
入れたら Claude Code を再起動し、/mcp で接続を確かめます。連載中、VS Code の拡張のパネルではコネクタの tool が見えず、ターミナルの対話セッションでは見えたことがありました。見えないときは、ターミナルの claude で試してください。
7-2. データ
評価データの TrialReviewBench は、リポジトリに入れていません。README の curl 3本で bench/raw/ に取り、build_bench.py と build_extraction.py で整形します(整形済みのファイルはリポジトリにもあり、この2行はそれを作り直すものです)。
7-3. 流れを動かす
ここから先は、コマンドではなく Claude Code への指示で進めます。CLAUDE.md の「データの流れ」に、段ごとにどのスクリプトや subagent が何を読み書きするかを書いてあるので、その順に指示します。
| 段 | Claude Code に頼むこと | 書かれる場所 |
|---|---|---|
| 候補 | reviews/<rid>/eval-3/search.json から全ヒットを取る(fetch_pubmed.py --from-search ... --all-hits --out-dir results/eval-3。37168849 は --add-pmid 28864289 も) |
results/eval-3/<rid>/ |
| スクリーニング | make_batches.py --review-pmid <rid> --run eval-3 でバッチを作り、screener を1バッチで試走 → 全件 |
results/eval-3/screen/a/ |
| 抽出 | fetch_pmc.py --from-extraction 33746596 37168849 → fulltext_to_text.py → make_extraction_jobs.py → extractor を1組で試走 → 全件 |
results/fulltext/・results/extraction/ |
| 採点 | build_report.py --run eval-3 で画面を作り、人が採点して保存 |
results/extraction/human/ |
| 評価 | 人が /eval <名前> --run eval-3 を打つ |
docs/eval/<名前>.md |
検索式と基準の案は reviews/<rid>/eval-3/ に commit してあるので、上の表はそれを使って検索から先を動かす道です。検索式も自分で作り直すなら、query-builder に PICO を渡す所から始めます。抄録・全文・判定の結果は results/ に書かれ、commit されません。
7-4. 同じ数字にはならない
同じ手順を回しても、Part1〜3 と同じ数字になるとは限りません。
- 抄録などの書誌は、取得した時期で変わりうる(候補の並びは commit した search.json で固定。検索式から作り直すと並びも変わる)
- 判定と抽出はモデルの出力で、回すたびに揺れる
- 抽出の採点は人がする
公開の準備の時点で、まっさらな clone で準備(venv → requirements → pytest → ruff)と bench/ の作り直しが通ることは確かめました。ただ、Claude Code で検索から抽出までを通しで回し直した記録はありません。数字の違いが出たら、それ自体が手法を確かめる材料になります。
8. 教材と検証の道具としての使い方
位置づけは Part0 から変わらず、SR の手法を学ぶ教材と、論文の手法を自分で確かめる道具です。業務の道具の配布ではありません。使い方の例です(どれも連載では試していません)。
- 基準の案と人が直した版を比べる:
git diff snap/03-criteria-draft snap/04-criteria-approved -- reviews/で、人が承認の時点で何を直したか、I5 のような問いがどこにあったかを読む - 別のレビューに差し替える:TrialReviewBench の100本から別の PMID を
build_bench.pyに渡す。抽出の答えがあるかは先に確かめる - モデルを変える:agent 定義の
modelを変え、同じ候補で Recall@k がどう動くかを見る - 記録を読む:
docs/HARNESS.mdとdocs/prompts/log.mdは、エージェントに手順を任せたときどこで詰まるかの実例になる
9. まとめ
本試行の問いへの答えは、原著の3つの作業を Claude Code で組み直すと、3本(抽出は2本)のレビューで、原著と近い水準の値が出た、です。Recall@50 0.779 と抽出の Accuracy 0.735(原著の患者背景 0.74)は原著と同じ水準、Recall@20 0.482 は下回りました。検索 Recall 0.963 は条件が違い、比べられる値ではありません。ただし、レビューの数・候補の数・モデル・採点者の数が違い、原著と同じ性能だとも、業務に使えるとも言えません。
人の判断を外して測ったことで、人の判断の入れどころが見えました。基準の案に残った問い、入力の範囲、答えの食い違いです。そして人の判断は、答えを見る前に入れる。評価の skill /eval を人だけが起動するのは、そのためです。
組み方としては、作業を subagent に1単位ずつ渡し、規則を skill で preload し、出力を hook で照らし、数えるのはスクリプトに任せました。定義に書いても、エージェントがそのとおりに動くとは限りません。だから記録を残し、照らす仕組みを先に作っておく。任せられる範囲は、事前にどれだけ検証可能にしておいたかで決まります。
次のステップ
この連載はここで終わりです。コードは GitHub(MIT)に、結果は見本の画面にあります。Part0 から読み直すときは、各回の「言えないこと」を並べて読むと、本試行の範囲がいちばんよく分かります。
出典
- Wang Z, Cao L, Danek B, Jin Q, Lu Z, Sun J. Accelerating clinical evidence synthesis with large language models. npj Digit Med 2025;8:509, doi:10.1038/s41746-025-01840-7(arXiv:2406.17755)
- TrialReviewBench(Hugging Face: zifeng-ai/TrialReviewBench、Apache-2.0)
- Anthropic, Claude Code Docs(subagents / skills / hooks / settings)
コードは GitHub で公開しています: github.com/HerzLeben/pubmed-slr-screening