Claude Code × Medical Application
【Claude Code】系統的文献レビュー × AI サブエージェント Part3:データ抽出と全文の渡し方
1. はじめに
Part3 は SR の3つ目の工程、データ抽出です。
1-1. この段の目的
データ抽出の目的は、組み入れた研究の全文を読み、患者数・年齢・標的抗原などを決まった項目の表に書き写すことです。SR の論文の Table 1(研究特性の表)がこれにあたります。一次スクリーニングが「どれを読むか」を決める作業だったのに対し、こちらは「読むと決めた論文から値を写す」作業で、読む論文も指標も違います(【業務説明】系統的文献レビュー)。
| 中身 | 測り方 | |
|---|---|---|
| 問い | 答えの表の列名だけを項目として渡し、PMC の全文から人の手なしで値を書き出したとき、どこまで答えと合うか | Accuracy=正解の項目 ÷ 全項目。原著(Immunotherapy)は 0.78。種類別では研究デザイン 0.95、患者背景 0.74 |
| 次の段への入力 | 本来はメタ解析などの統合 | 本試行では統合はしない(臨床の結論にあたるため)。Part4 で原著との比較をまとめる |
本試行の項目は元のレビューの Table 1 の列で、ほとんどが患者背景、一部が研究デザインです。原著の 0.78 は結果(アウトカム)の項目も含む値なので、近い比較相手は患者背景の 0.74 です(デザインの列も混ざるので、厳密に同じ物差しではありません)。
1-2. 原著との対比
| 原著 TrialMind | 本試行 | |
|---|---|---|
| 対象 | 組み入れた研究 | 答えのある2本(33746596 多発性骨髄腫、37168849 急性骨髄性白血病)の組み入れ研究のうち、PMC で本文が取れた7組 |
| 入力 | 全文の PDF か XML | PMC の XML から作ったテキスト(本文・すべての表・図の説明。補足資料と著者の所属は入れない) |
| 項目 | 答えの表の列名をそのまま | 同じ(説明は足さない) |
| 抽出 | 項目ごとに値と出典 | subagent extractor が1組1回、項目ごとに値と逐語引用 |
| 採点 | 3人が原文の表と照合 | 完全一致だけ規則で正解、残りは人(1人)が画面で採点 |
| 分母 | 1,334(デザイン 696、患者背景 353、結果 285) | 102(デザインと患者背景) |
1-3. 手順と結果の要約
| 手順 | 中身 | 結果 |
|---|---|---|
| ① 全文をテキストにする | fetch_pmc.py が PMC の XML を取り、fulltext_to_text.py が本文と表をテキストにする |
答えの20組のうち本文が取れたのは7組(論文は6本)。表10枚のうち <body> の中にあったのは4枚 |
| ② job を作る | make_extraction_jobs.py が、組ごとに全文のパスと項目名を1つのファイルにする |
7組・102項目。答えの値は渡さない |
| ③ extractor が書き出す | 1組につき1回起動し、値と逐語引用を書く。書く直前に hook が引用を照らす | 7組すべて書けた。差し戻しは1回、「記載なし」は17項目 |
| ④ 採点する | 完全一致は規則で正解、残り96項目は人が採点 | Accuracy 0.735(75/102、95% CI 0.642–0.811)。原著の患者背景 0.74 と同じ水準 |
2. 手順
2-1. ① 全文をテキストにする
原著の限界の節には「PubMed Central の公開された資料に限る」とあります。本試行もそれにならい、全文は PMC だけから取りました。スクリプト fetch_pmc.py が PMID から PMC の記録をたどり、XML を取って、本文(<body>)があるかを記録します。
テキストにするときに分かったのが、表の置き場所です。PMC の XML では、表の多くが <body> の外(<floats-group> など)に置かれていました。6本の表10枚のうち、<body> の中は4枚だけです。本文だけを渡すと、患者背景の表がまるごと落ちます。
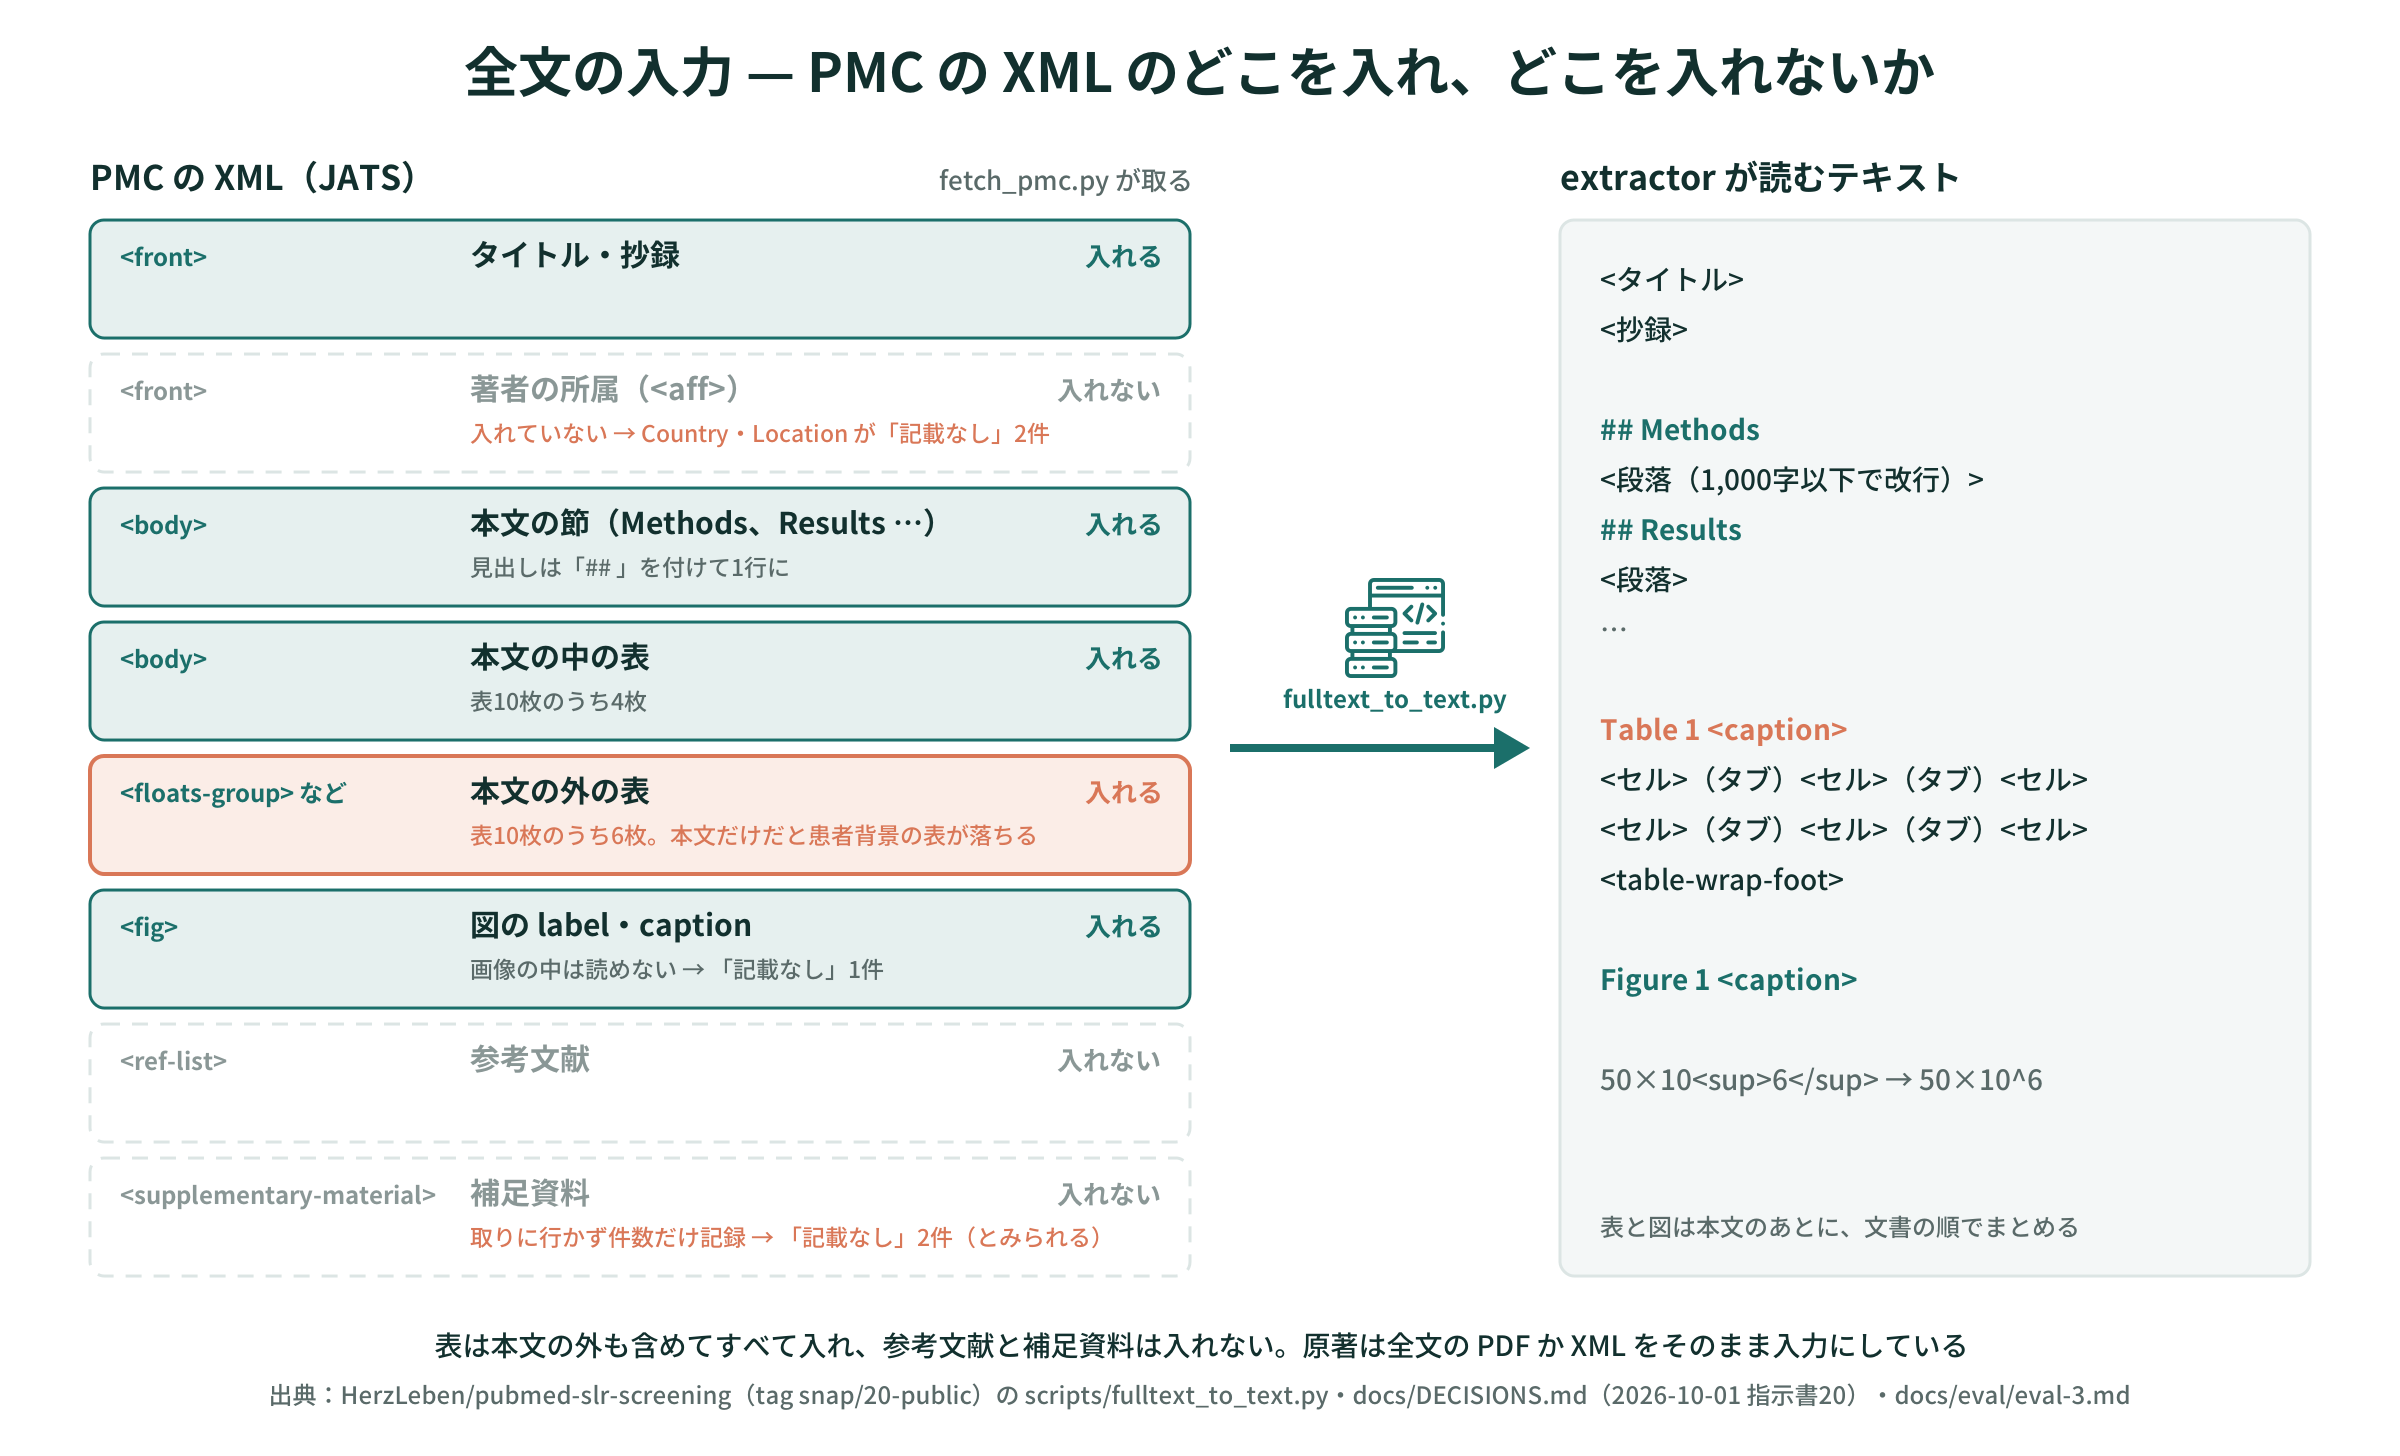
fulltext_to_text.py は、タイトル・抄録・本文の各節に加えて、すべての表(場所を問わない。1行を1行、セルはタブ区切り)と図の label・caption を入れます。参考文献と補足資料は入れません。細かい所では、50×10<sup>6</sup> を 50×10^6 と書き(そのままだと用量が「106」に読める)、長い段落は文の切れ目で 1,000字以下の行に分けました(2,000字を超える段落が5本ありました)。Read の tool で長い行が切れると、その先が extractor に届かないためです。
2-2. ② job を作る
スクリプト make_extraction_jobs.py が、組(レビュー × 研究)ごとに job ファイルを書きます。中身は、全文のテキストのパス、項目名の並び、書き込み先です。項目名は答えの表の列名そのもので、たとえば次のような文字列です。
Median age (range)、Lines of Prior treatment(33746596、14項目)Prior HCT、Manufacturing time in days、Costimulatory Domain(37168849、15項目)
原著も “Each table’s column names served as input field descriptions” と書き、列名に説明を足していません。スクリプトは答えのファイルから PMID の列だけを読み、値は読みません。同じ論文 30396908 は両方のレビューに入っているので、項目の違う2つの job になります。
2-3. ③ extractor が書き出す
本体は、次の2行だけを書いて extractor を起動します(7組とも同じ形)。
抽出の job を1つ処理してください。

job:results/extraction/jobs/<review>/<pmid>.json
extractor は job と全文を読み、項目ごとに値(value)と、全文からの逐語引用(quotes)を書きます。見つからなければ値を「記載なし」、引用を空にします。
{"review_pmid": "<review>", "pmid": "<pmid>",
 "items": [
   {"name": "<項目名をそのまま>", "value": "<値>", "quotes": ["<全文の文字列>"]},
   {"name": "<項目名をそのまま>", "value": "記載なし", "quotes": []}]}
1組で試走したあと(16.7秒、2.1万トークン、差し戻し0)、残りの6組を並列で起動しました。1回あたり 16.9〜30.3秒、7組で約17.7万トークンです。
2-4. ④ 採点する
前後の空白と大文字・小文字だけをそろえて完全一致したもの(6項目)は、規則で正解にしました。「記載なし」を含む残りの96項目は、eval-3 のレポートの画面で人が1件ずつ採点しました。基準は採点の前に決め、画面の上に出しています。
- 意味が同じなら正解(表記・単位の書き方・語順は問わない)
- 答えより詳しいだけなら正解。答えの一部が欠けていれば不正解
- 答えが分類(地域など)で、抽出が元の値なら、そこから分類が一意に決まれば正解
- 「記載なし」は、答えも記載が無いことを表していれば正解、値があれば不正解
画面には、引用を全文の前後160字と一緒に出しました。原著の「出力は出典にリンクされ、人が確かめられる」にあたる部分です。
3. 結果
3-1. Accuracy
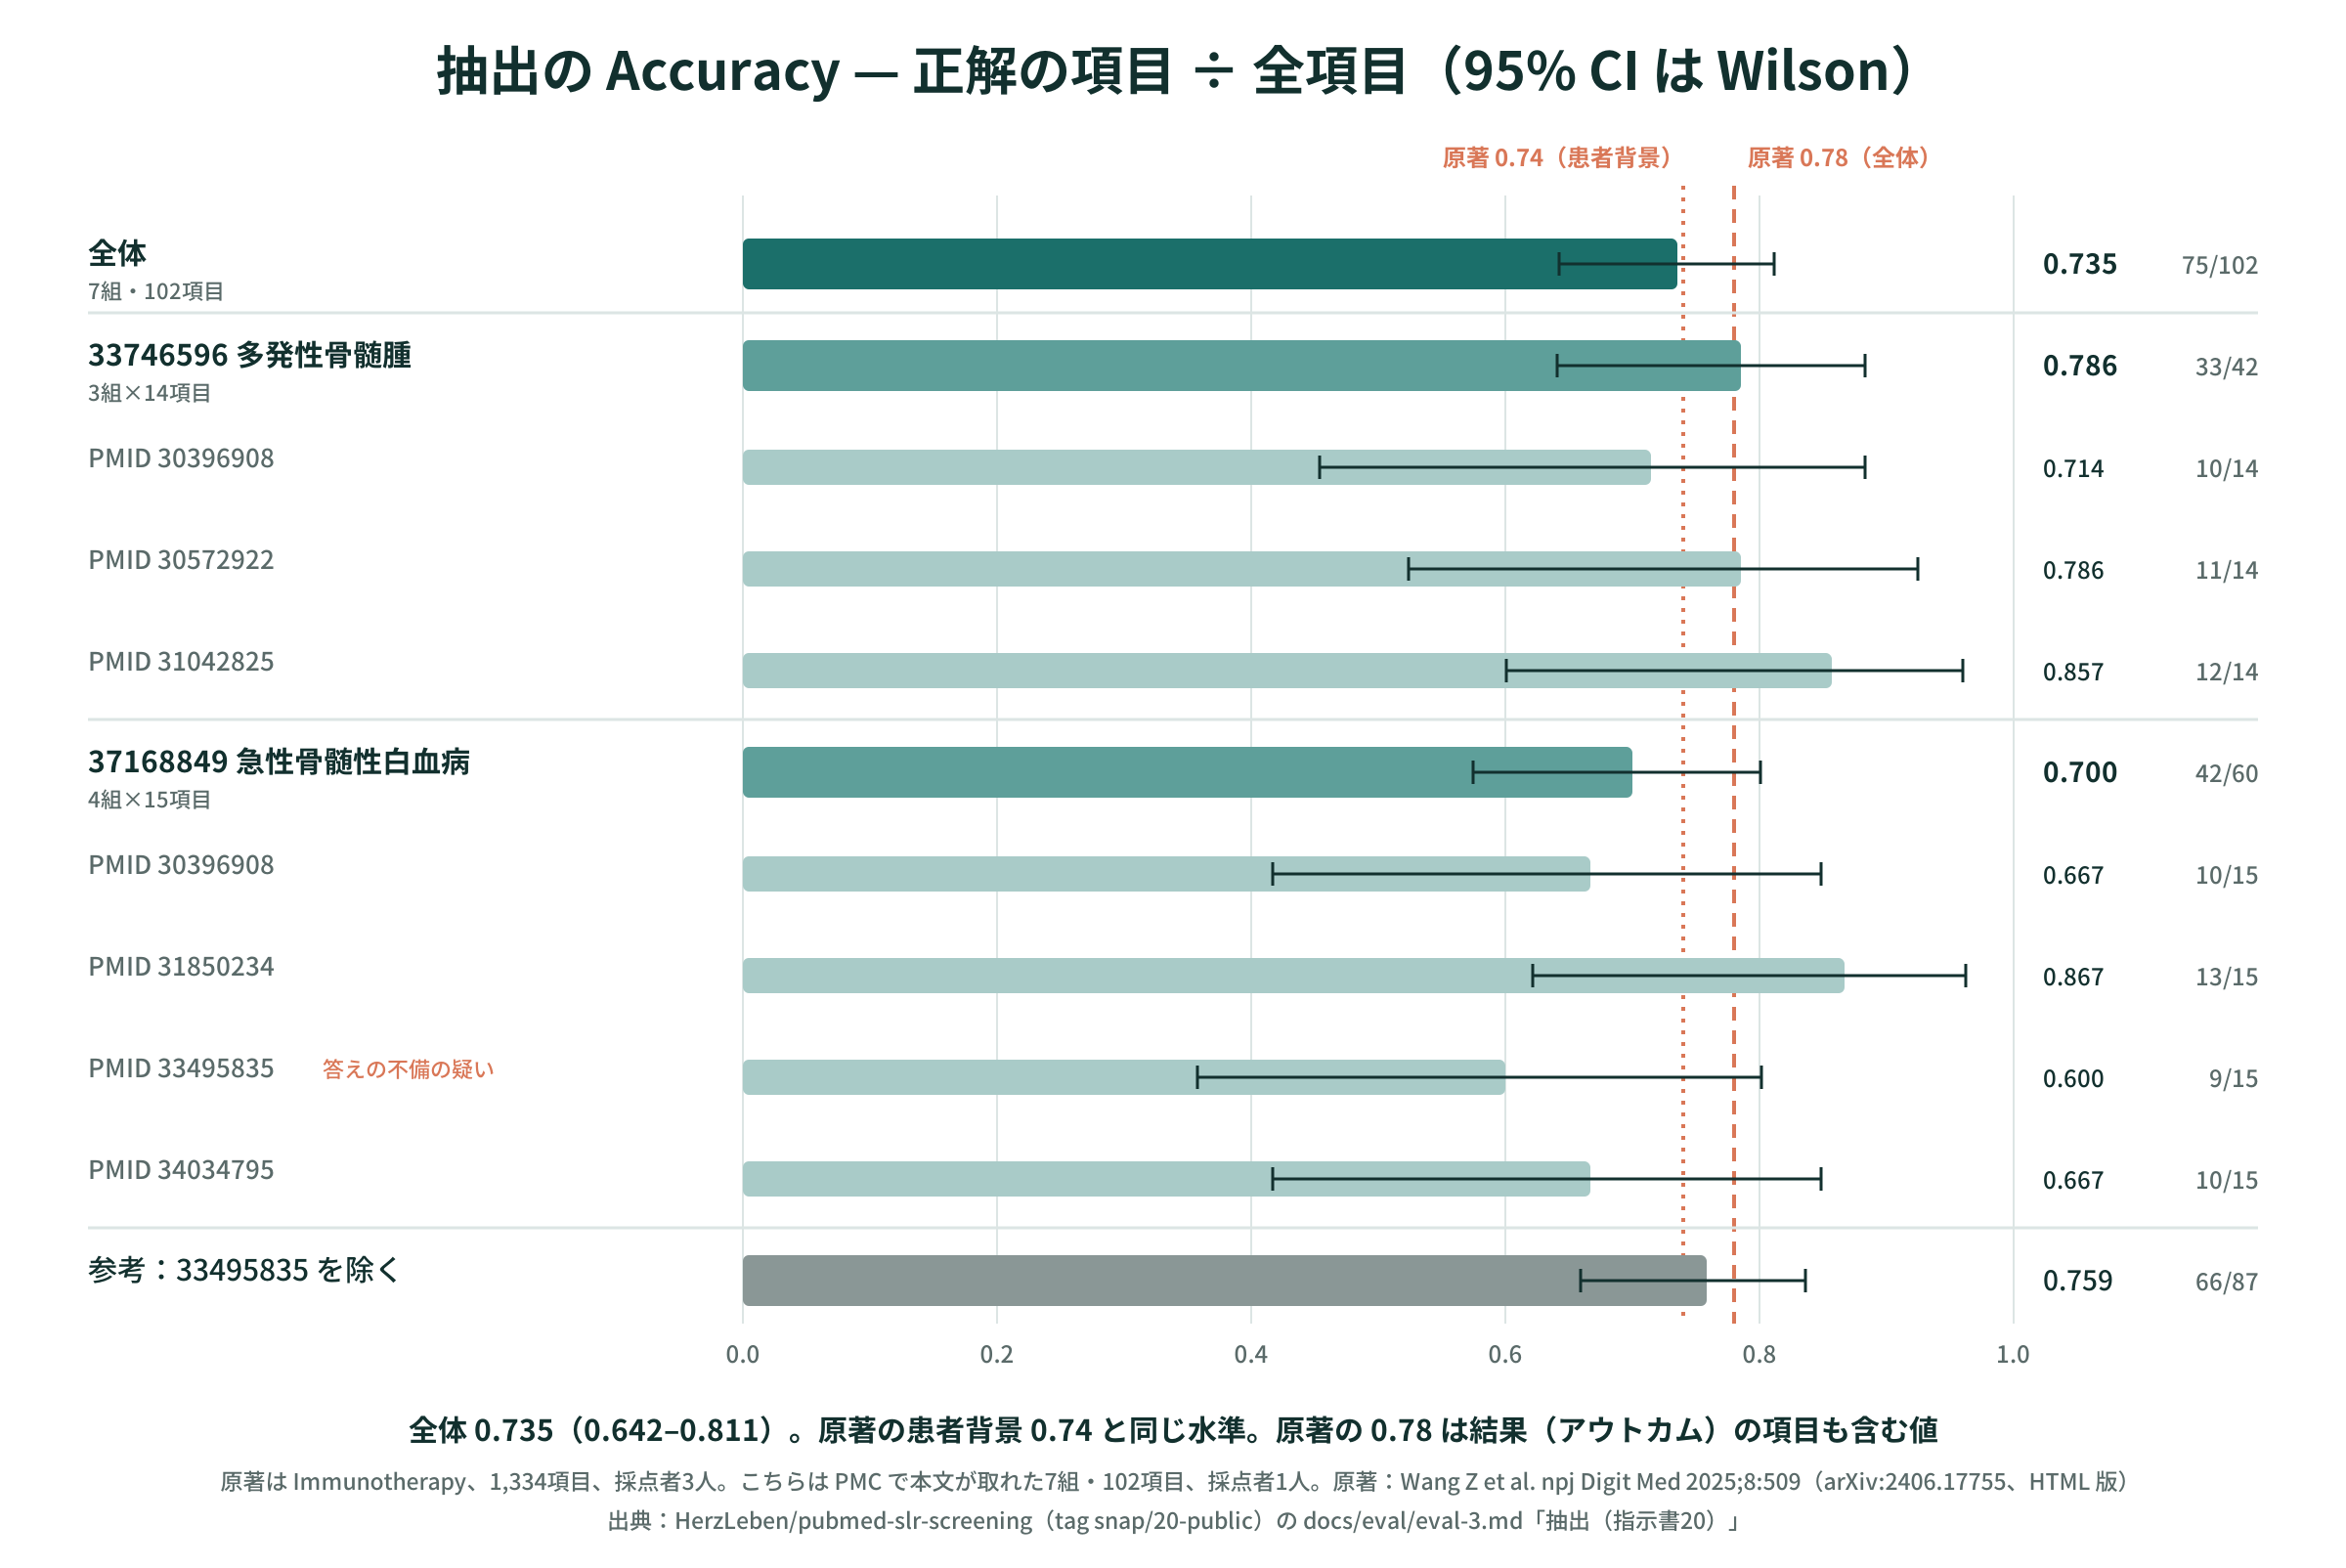
| 範囲 | 正解 / 項目 | Accuracy | 95% CI |
|---|---|---|---|
| 全体 | 75 / 102 | 0.735 | 0.642–0.811 |
| 33746596 多発性骨髄腫 | 33 / 42 | 0.786 | 0.641–0.883 |
| 37168849 急性骨髄性白血病 | 42 / 60 | 0.700 | 0.575–0.801 |
| 参考:37168849 × 33495835 を除く | 66 / 87 | 0.759 | 0.659–0.836 |
| 原著 Immunotherapy(全体) | 0.78 | 0.75–0.81 | |
| 原著 Immunotherapy(患者背景) | 0.74 | 0.67–0.80 |
95% CI は Wilson の区間です(原著は出し方を書いていません)。組ごとには 0.600〜0.867 でした。区間は原著と重なりますが、分母が102と小さく、幅は広めです。
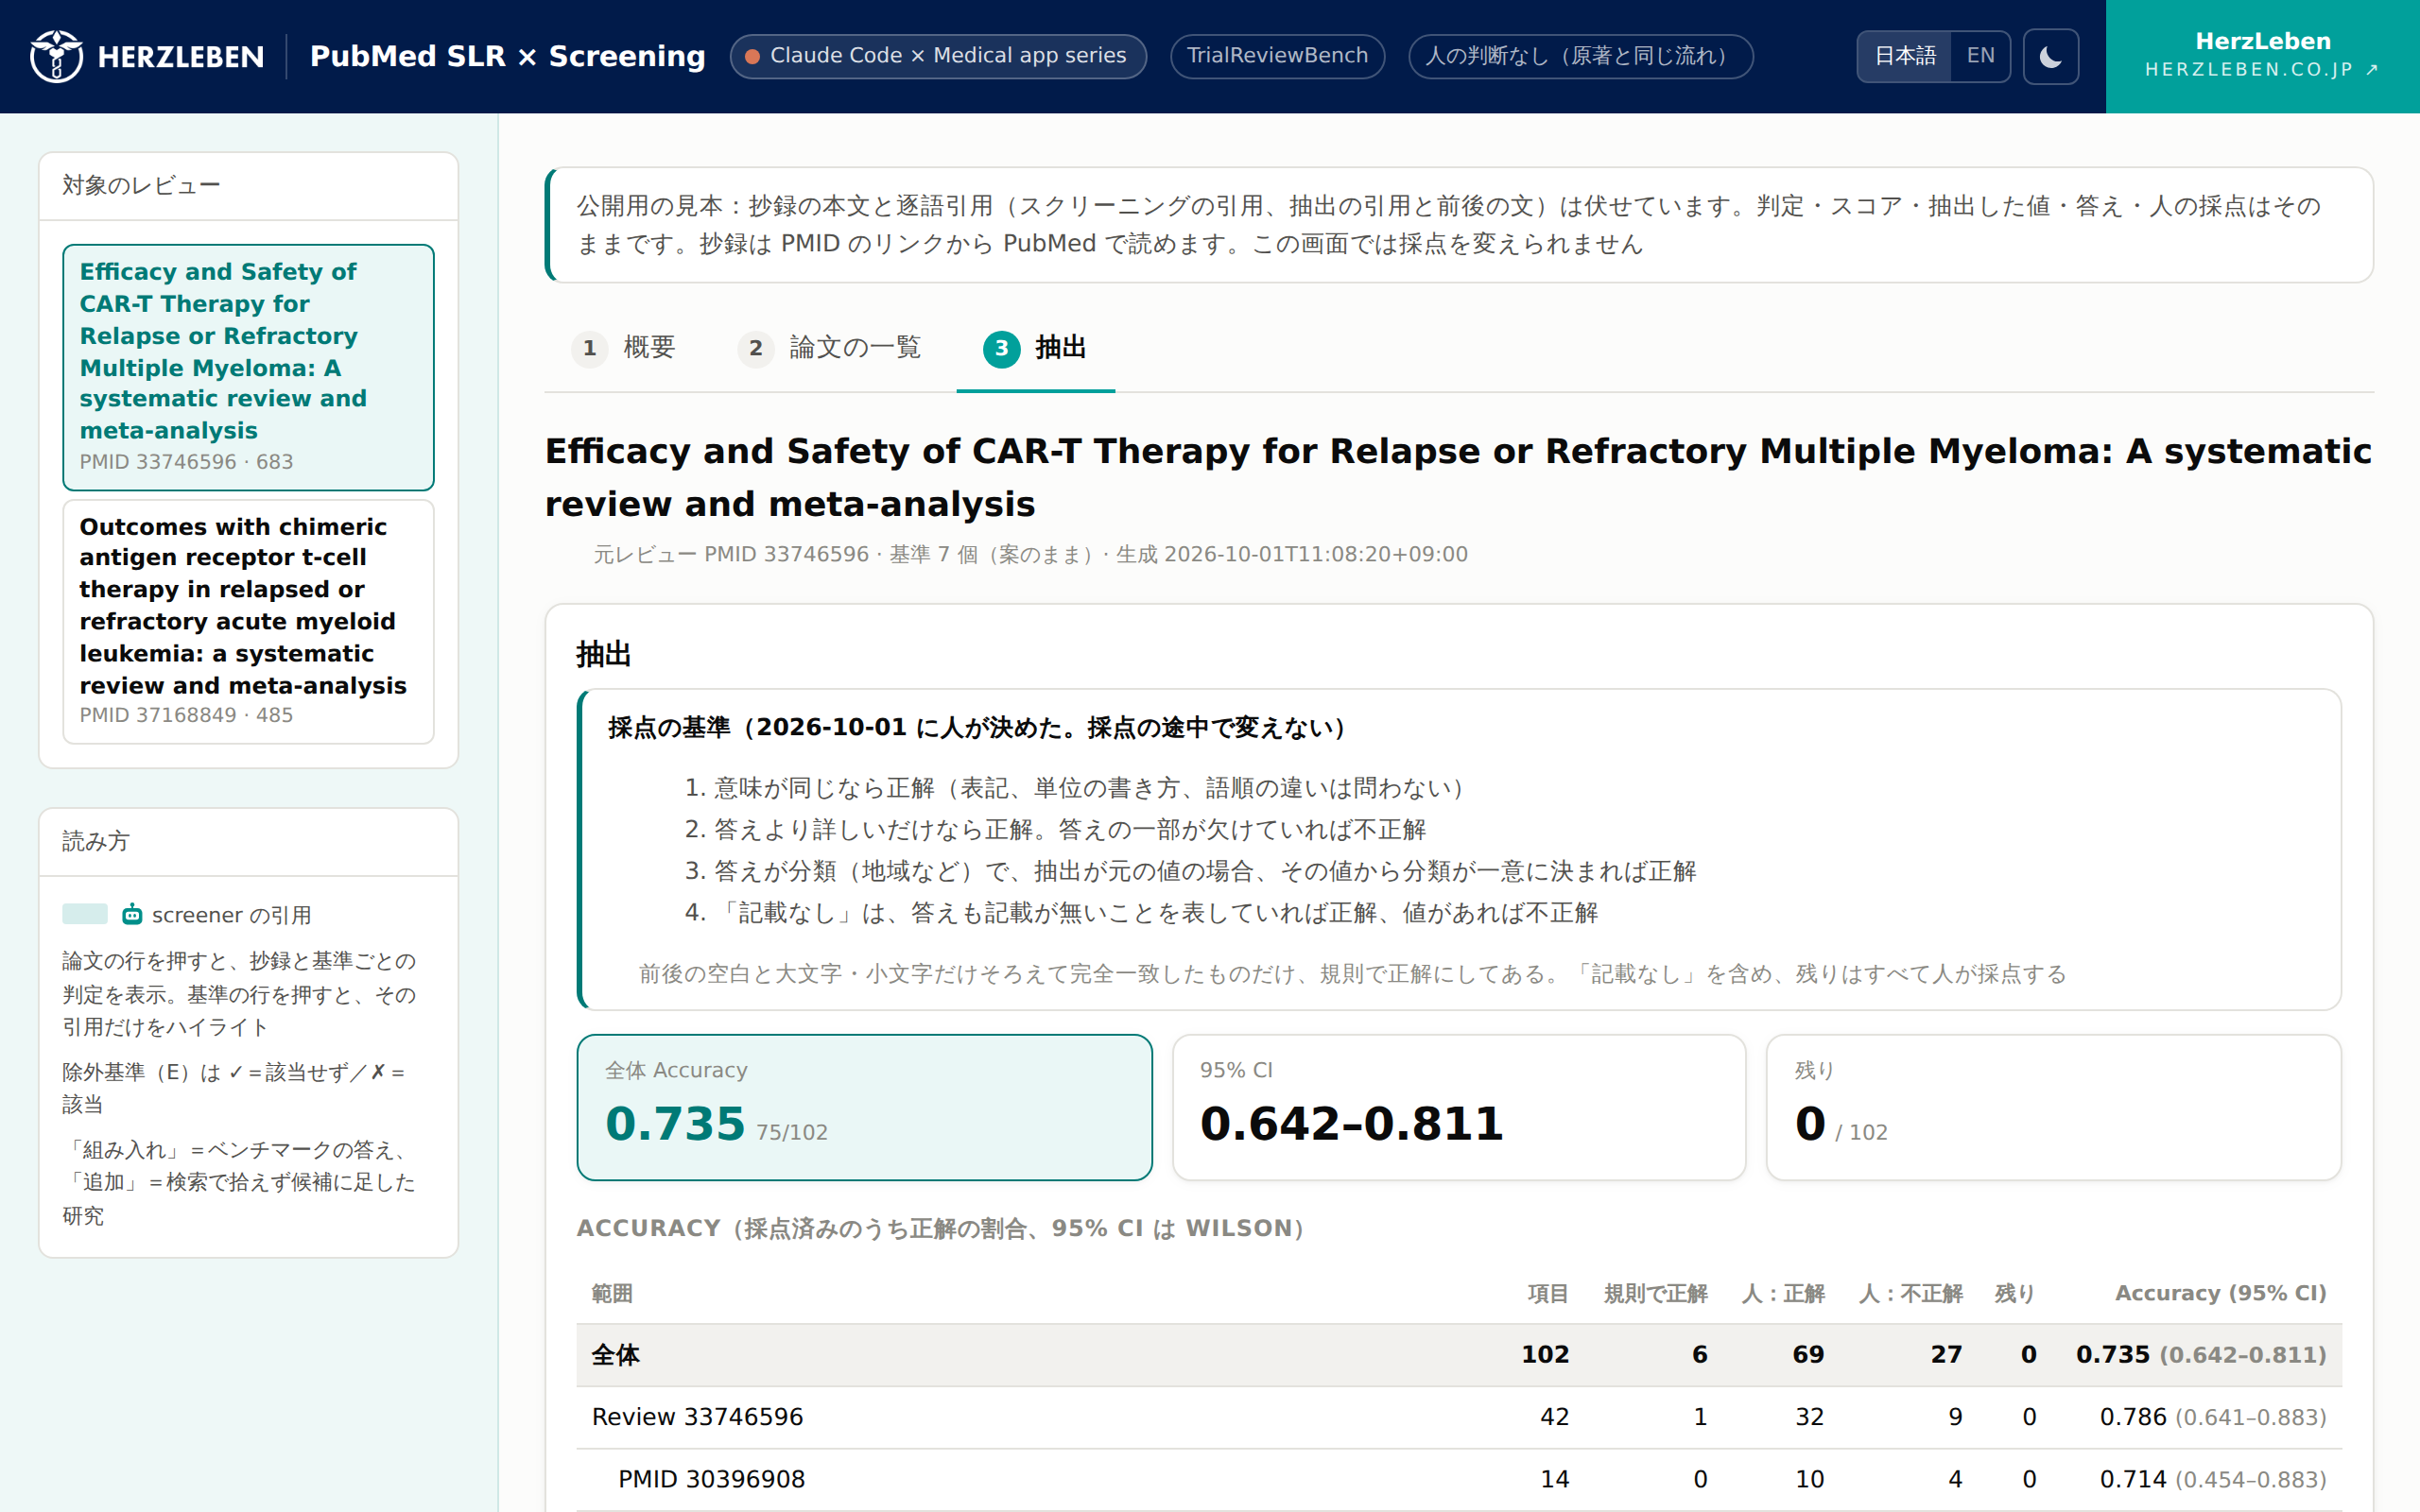
結果は見本の画面の「抽出」タブで見られます(引用と前後の文は伏せた公開版)。
3-2. 間違えた項目
不正解の27項目は、「記載なし」が11、値の食い違いが16でした。「記載なし」は全部で17ありましたが、そのうち6は答えも “not reported” などで、正解になっています。不正解の11の理由は次のとおりです。
| 理由 | 件数 | 例 |
|---|---|---|
| 計算が要る | 3 | 表が患者ごとの値だけ、または女性の数だけで、中央値や男性の数は計算が要る(規則で計算を禁じている) |
| 答えの「No」が本文に書かれていない | 3 | Prior HCT、Post CAR-T Allogenic-HCT |
| 補足資料にあるとみられる | 2 | 製造日数、移植の有無(確かめてはいない) |
| 著者の所属をテキストに入れていない | 2 | 国・地域(Country、Location) |
| 図の画像の中だけ | 1 | CAR の構造の模式図にある costimulatory domain |
補足資料と図の画像は原著も入力にしておらず、原著の限界の節にも「付録にある値は取れなかった」とあります。著者の所属は PDF なら入っているので、こちらの入力の作り方による差です。
3-3. 取れなかったもの
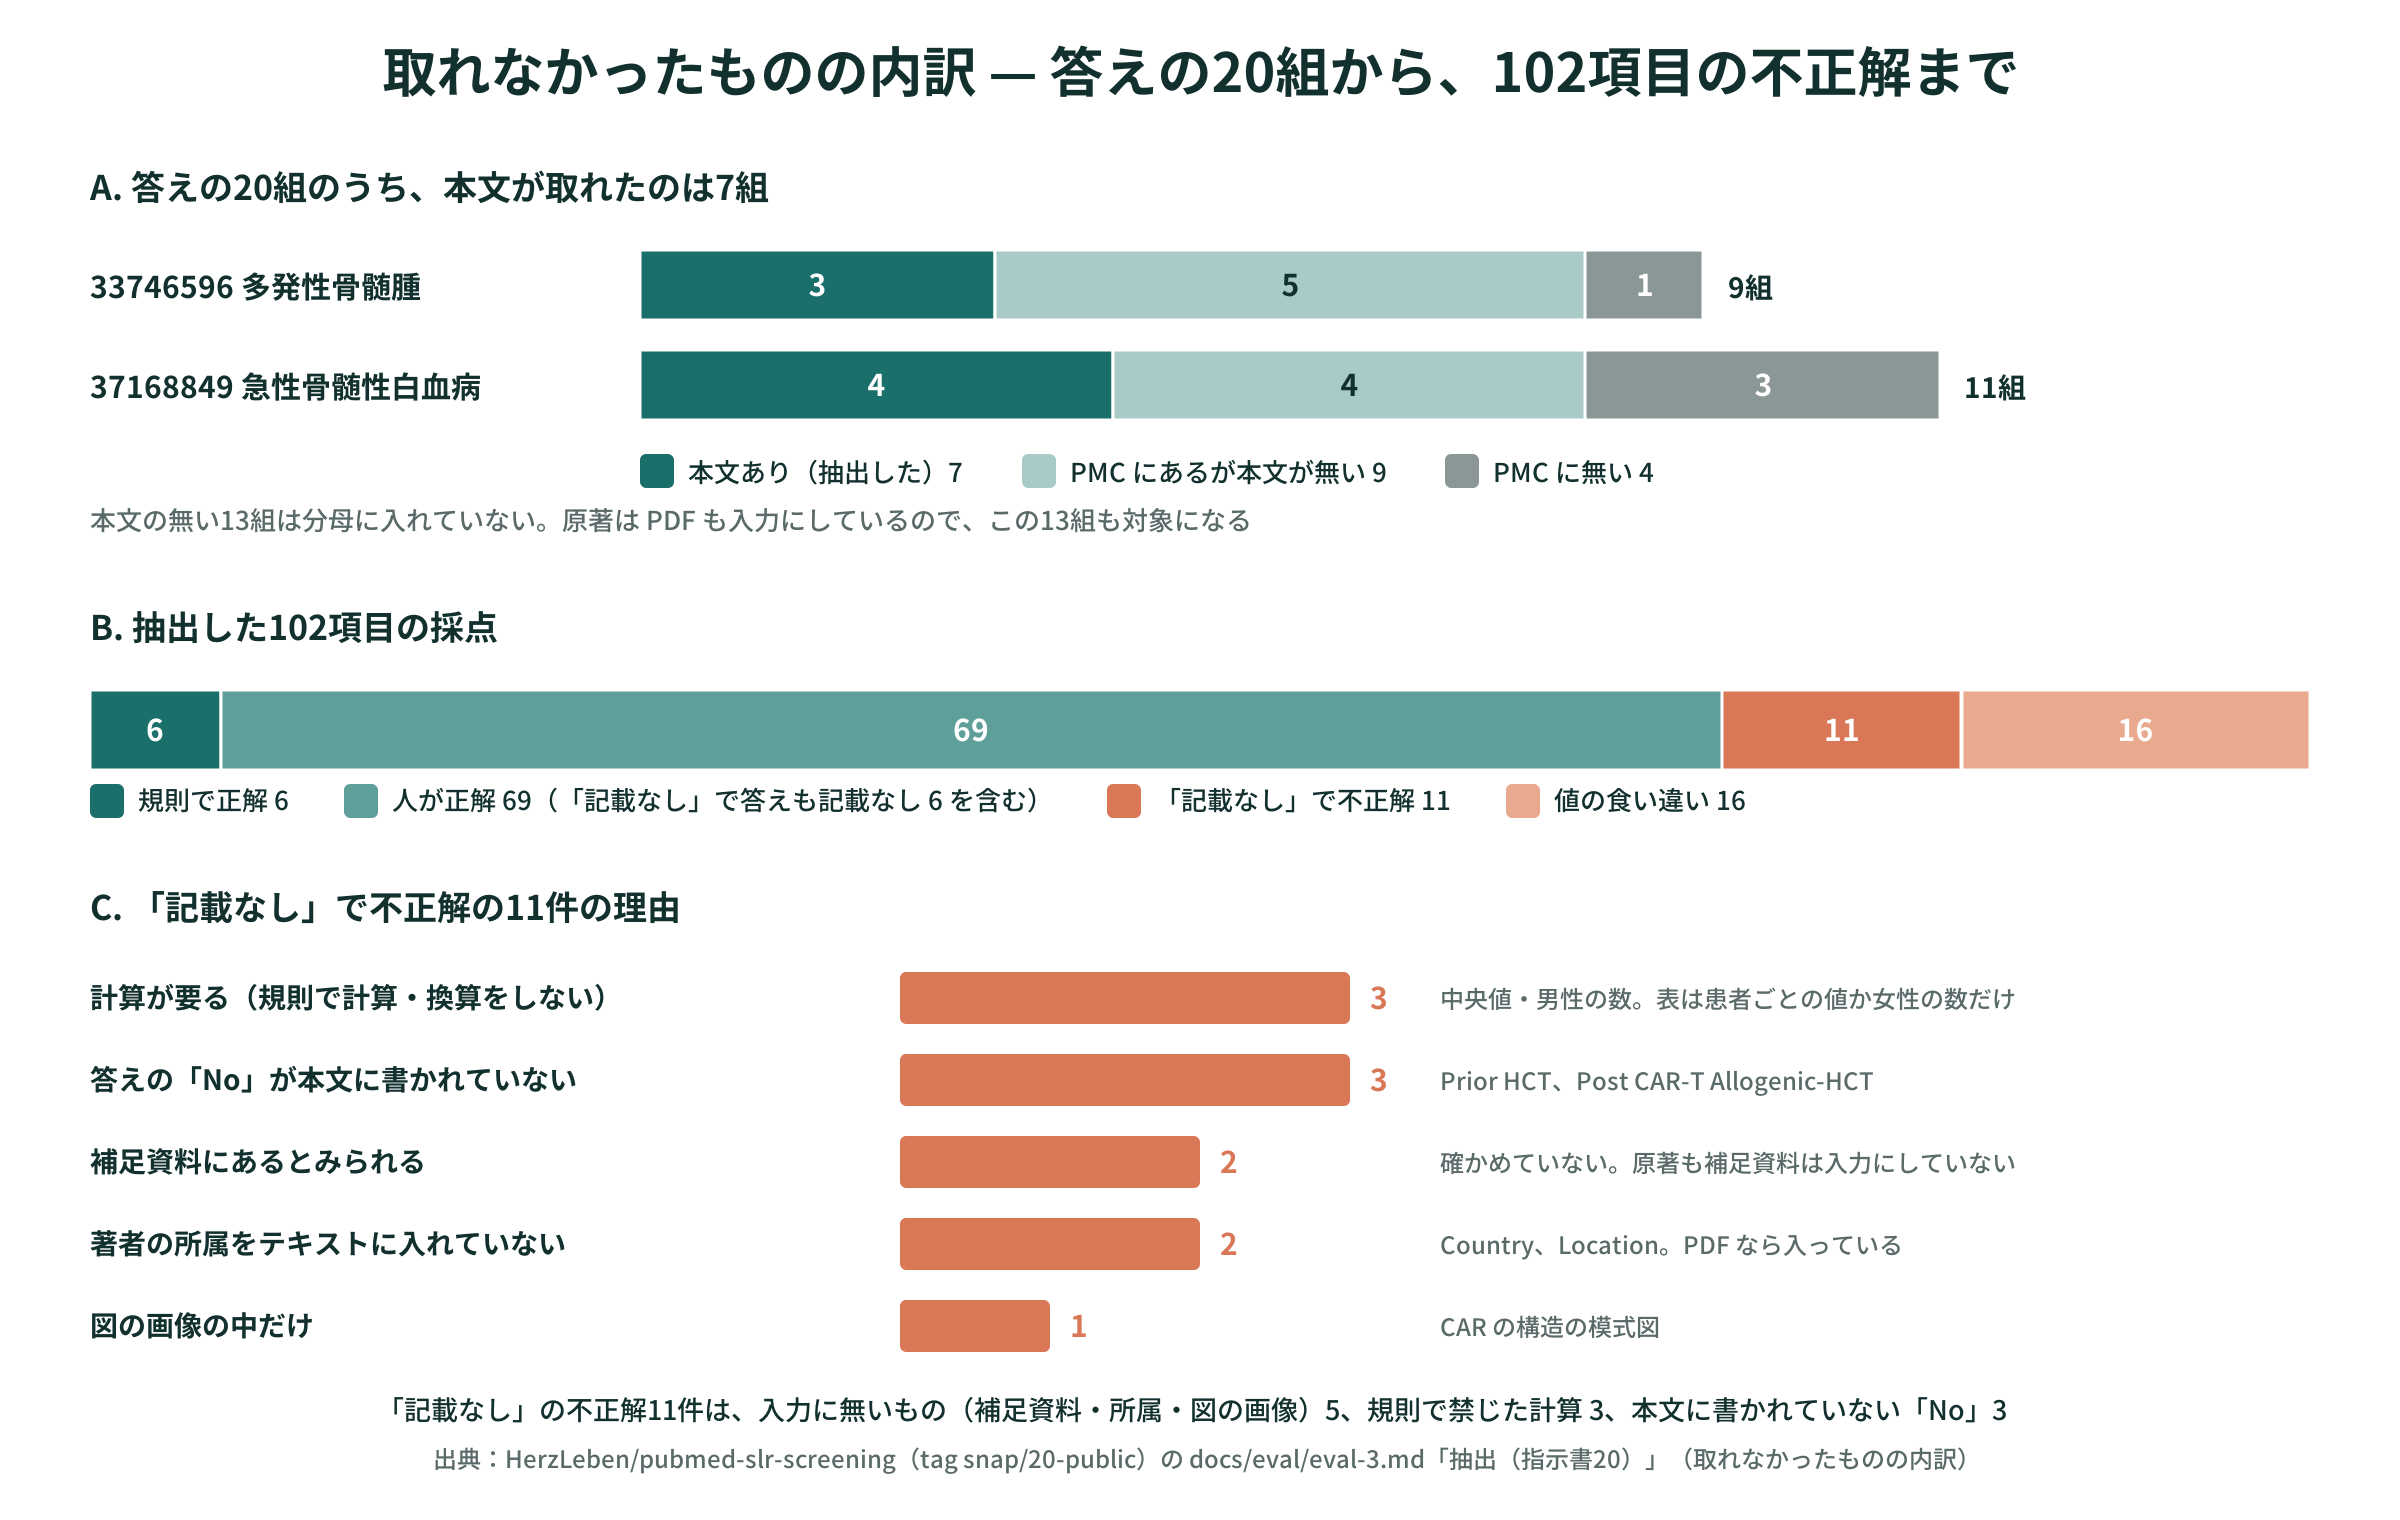
そもそも、答えの20組のうち本文が取れたのは7組です。
| 33746596 | 37168849 | 計 | |
|---|---|---|---|
| 答えの組 | 9 | 11 | 20 |
| 本文あり(抽出した) | 3 | 4 | 7 |
| PMC にあるが本文が無い | 5 | 4 | 9 |
| PMC に無い | 1 | 3 | 4 |
本文の無い13組は分母に入れていません。原著は PDF も入力にしているので、この13組も対象になります。Accuracy 0.735 は「PMC で本文が読める研究に限った値」です。
3-4. 答えの不備の疑い
37168849 × 33495835 は in vitro の研究で、CAR-T を投与した患者はいません。extractor もそう報告し、患者背景の項目を「記載なし」にしました。ところが答えには患者の年齢・性別があり、Costimulatory Domain の欄には薬剤名が入っています。答えは直さずに採点し、この組(15項目、正解9)を除いた 0.759 を参考に並べました。
4. この作業の組み方
4-1. extractor の subagent
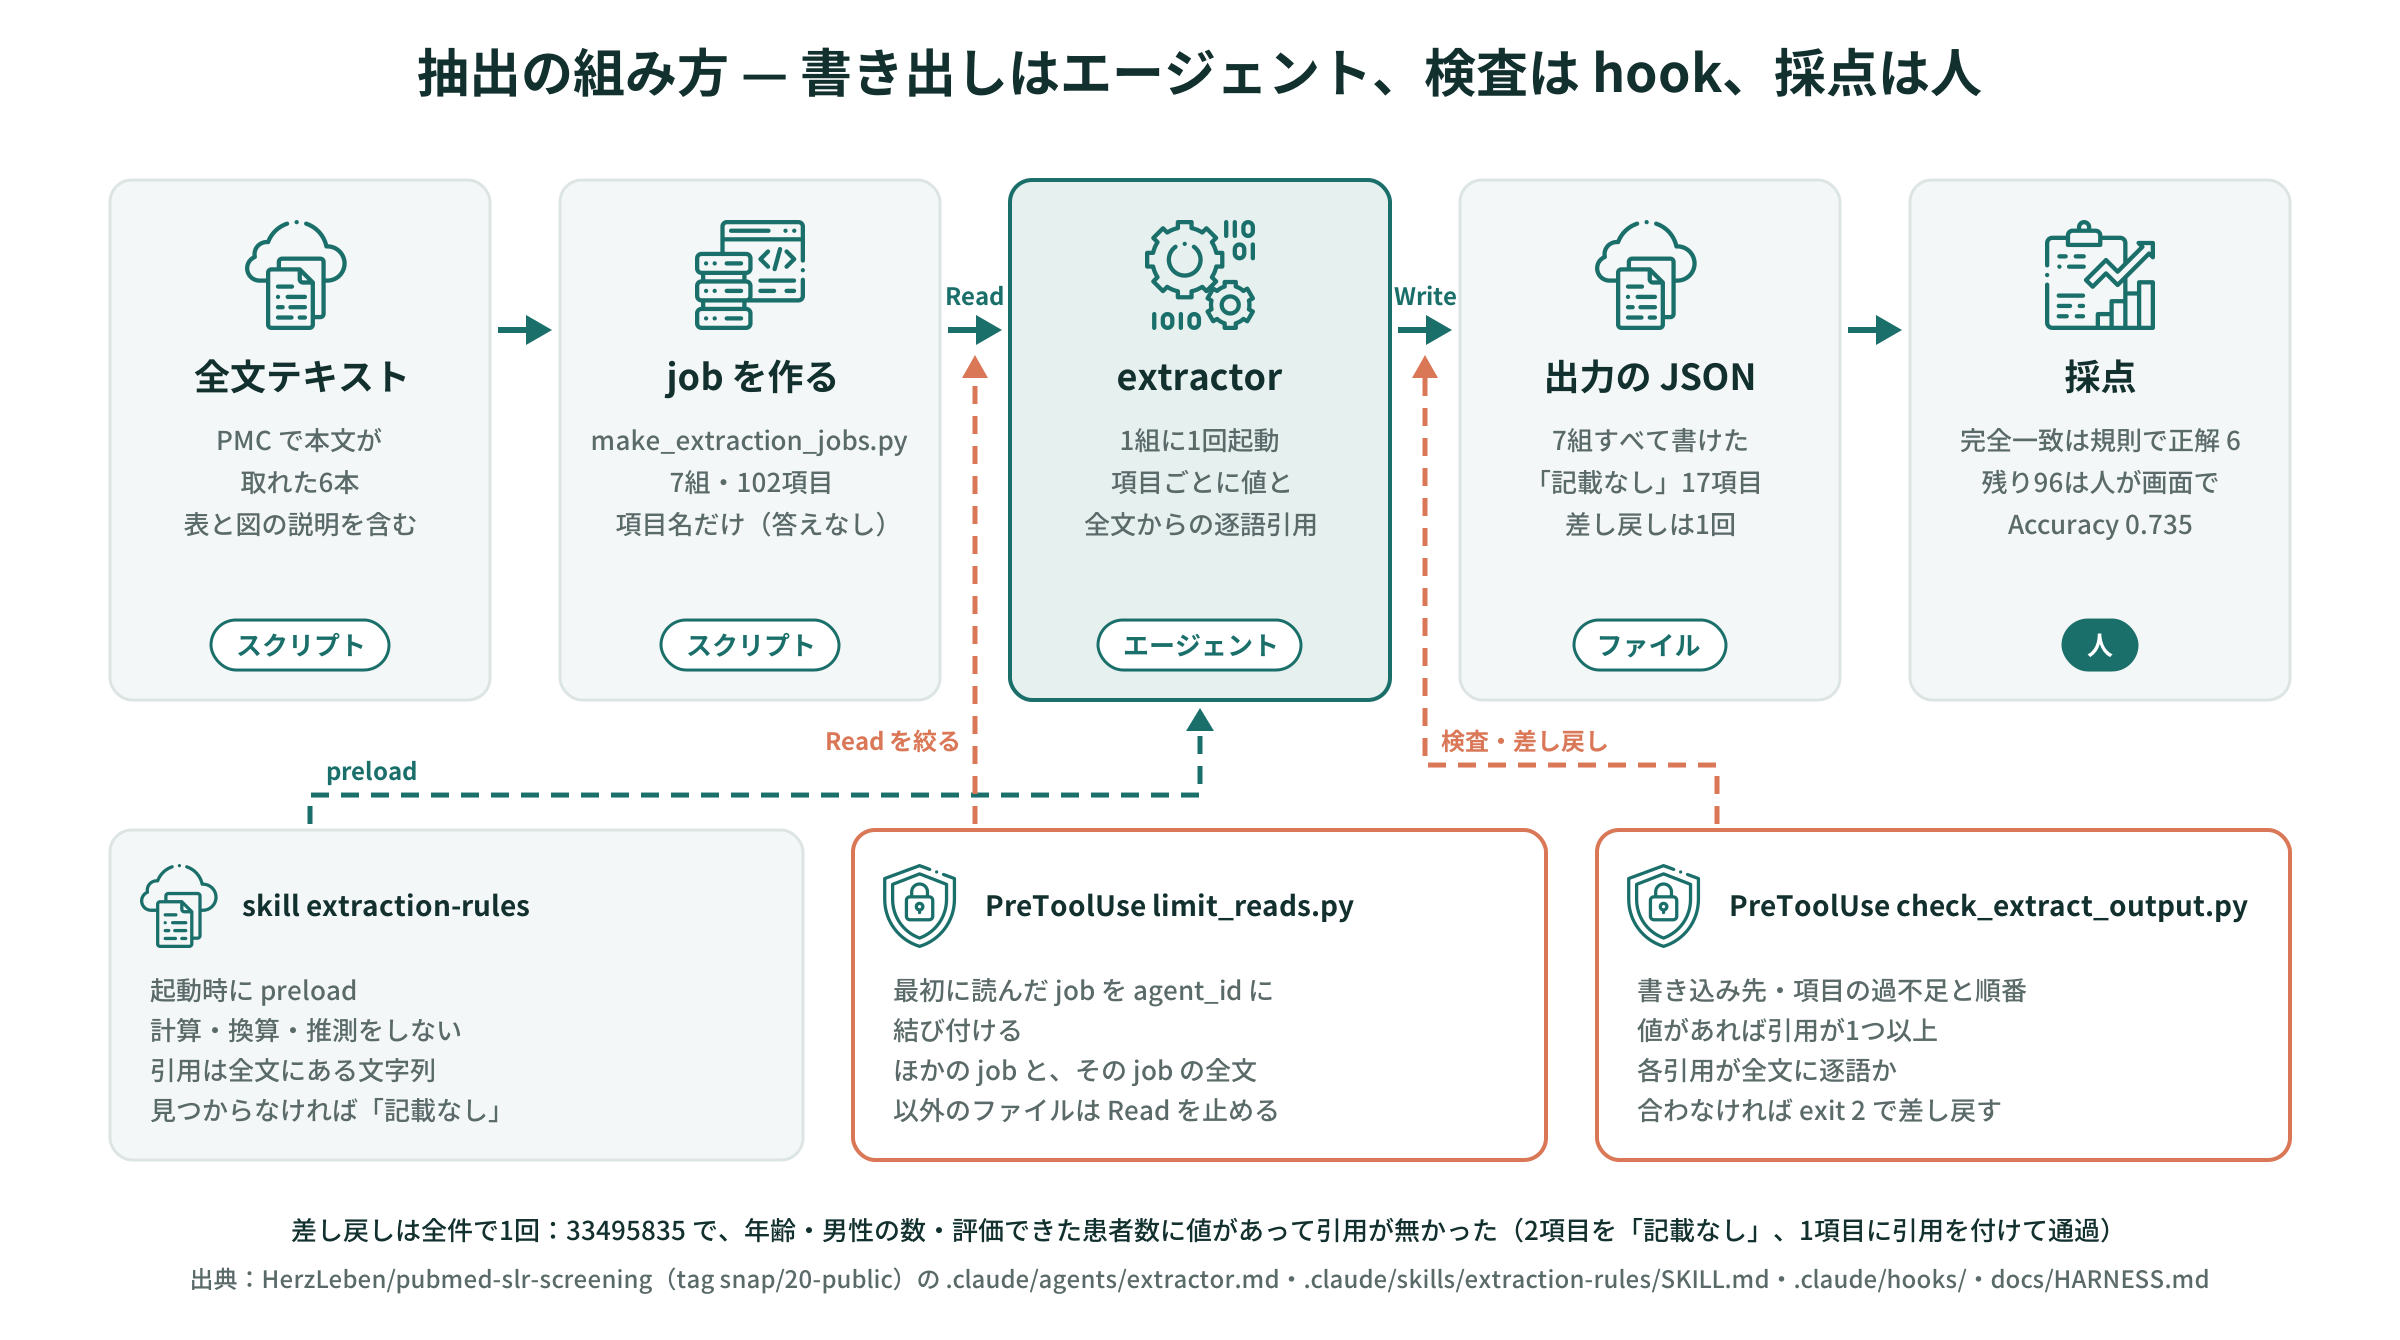
extractor の定義(.claude/agents/extractor.md)は、Part2 の screener と同じ書き方です。
name: extractor
description: SLR の研究特性の抽出役。1回の起動で1本の研究(1つの job)を扱い、(略)
tools: Read, Write
model: sonnet
omitClaudeMd: true
skills:
- extraction-rules- 1回の起動で1組:全文は長いので、研究ごとに新しい context で読ませる
- 道具は
ReadとWriteだけ、本体向けのCLAUDE.mdは読まない - やらないことを本文に書く:推測・計算・換算、項目名の言い換えや並べ替え、臨床的な解釈
4-2. 規則の skill と、答えを渡さない工夫
規則は skill extraction-rules にまとめて preload しました。中身は、項目の扱い、値の書き方(計算・換算をしない)、引用の決まり(全文にそのままある文字列。表ならセルの文字列)、「記載なし」の条件、出力の形です。出力の例は <値> のような記号だけにし、答えの値や書き方の例は skill にも agent 定義にも委任文にも書いていません。
skill には user-invocable: false だけを付けました。モデルも呼べなくする disable-model-invocation: true は、公式ドキュメントによると subagent への preload も止めてしまうためです。skill に答えが無いので、モデルが呼んでも漏れはありません。
4-3. 2つの hook
| hook | いつ | すること |
|---|---|---|
check_extract_output.py |
Write の直前(PreToolUse) | 書き込み先が job の output か、review_pmid・pmid がパスと合うか、項目が job と過不足なく同じ順か、値が空でないか、「記載なし」なら引用が空・それ以外は1つ以上か、各引用が全文に逐語であるか。合わなければ exit 2 で差し戻す(SubagentStop では見るだけ) |
limit_reads.py |
Read の直前(PreToolUse) | extractor が最初に読んだ job をその agent_id に結び付け、ほかの job と、その job の全文以外のファイルを読めなくする |
limit_reads.py に結び付けの仕掛けが要るのは、hook の入力に「どの job を渡された extractor か」が載っていないからです。agent の種類(agent_type)と ID は分かるので、最初の1回で決めることにしました。
差し戻しは全件で1回でした。33495835 で、年齢・男性の数・評価できた患者数に値を書いたのに引用が無かったものです。extractor は2項目を「記載なし」に直し、1項目に引用を付けて、2回目で通りました。引用の無い値は、ここで止まったことになります。
4-4. 全文を commit しない
リポジトリには全文を取ってテキストにするスクリプトだけを置き、XML・テキスト・抽出の出力は results/(.gitignore の下)に書きます。README にも「答えの CSV、抄録、全文はリポジトリに入れていない(スクリプトで取る)」と書きました。理由は抄録を commit しなかったのと同じで、論文の全文は著者や出版社の著作物だからです。PMC で読めても、再配布してよいかは論文ごとのライセンスによります。読者は fetch_pmc.py と fulltext_to_text.py を打てば、同じ手順で取り直せます。
4-5. 人が決めたこと
| 人が決めたこと | 理由 |
|---|---|
| 全文は PMC だけ。本文が無い組は抽出しない | 原著の限界と同じ条件にそろえる |
表は <body> の外のものも入れる |
原著は全文の PDF か XML をそのまま入れている |
| 項目は答えの列名のまま、説明を足さない | 原著と同じにする |
| 抽出の流れに人の判断を入れない(人は試走の確認と採点だけ) | 人が直した値の Accuracy は、抽出の評価にならない |
| 採点の基準は採点の前に決め、途中で変えない | 答えを見ながら基準を動かさないため |
| 答えの不備の疑いは直さず、除いた値を参考に並べる | 答えを直すと、比べる物差しが変わる |
| 機能の追加は抽出で最後にする | 著者の所属を入れていない所も、直さずに記録した |
5. 言えること・言えないこと
言えること
- PMC で本文が読める7組について、人の手なしで書き出した研究特性の Accuracy は 0.735(95% CI 0.642–0.811)で、原著の患者背景 0.74 と同じ水準だった
- 102項目の値は、「記載なし」を除いてすべて全文に逐語の引用を持っている(hook の検査を通った)
- 不正解のうち「記載なし」の11件は、計算・補足資料・所属・図の画像など、理由を(推定を含めて)すべて挙げられる
言えないこと
- 原著と同じ性能だ、とは言えない。分母は102と小さく、レビューは2本、採点者は1人。原著の 0.78 は結果の項目を含む値で、こちらには結果の項目が無い。モデルも違う(原著は GPT-4 と Claude 3 Sonnet、本試行は現行の Claude Sonnet)
- SR の抽出に使える、とは言えない。答えの20組のうち13組は本文が取れず、対象にもなっていない
- 引用があれば値が正しい、とは言えない。hook が確かめるのは、引用が全文に逐語であることだけ。値の食い違い16件は、引用がありながら答えと合わなかった
- extractor の報告を信じてよい、とも言えない。33495835 の extractor は終わりの報告で「記載なし」を「次の7項目」と書きながら6項目しか挙げず、出力も6項目だった(出力が正しい)。また同じ論文 30396908 で、33746596 の job では Country を「記載なし」にし、37168849 の job では施設名を Location に答えた。項目名が違うだけで、探し方が変わった
- 手順どおりに組めた、とも言い切れない。セッションの途中で足した agent 定義は読み込まれず、試走は「Agent type ‘extractor’ not found」で止まった。general-purpose で代わりに走らせると
omitClaudeMdと skill の preload が効かないので、代用せず、人が Claude Code を再起動した
6. まとめ
この段の目的は、組み入れた研究の全文から研究特性を表に書き写すことと、それを人の手なしでどこまでできるかを確かめることでした。PMC で本文が読める7組・102項目で、Accuracy は 0.735(原著の患者背景 0.74)です。
「記載なし」で間違えた11件は、入力に無いもの(補足資料・著者の所属・図の画像)が5、規則で禁じた計算が3、本文に書かれていない「No」が3でした。何を入力に入れるかが、そのまま取れる値の上限になります。そして答えの20組のうち13組は、PMC だけでは本文にたどり着けませんでした。
組み方としては、表を <body> の外からも集めて全文をテキストにし、研究ごとに subagent extractor を起動し、規則を skill で preload し、引用を PreToolUse の hook で検査し、読めるファイルを別の hook で job ごとに絞りました。
次のステップ
Part4 は考察と再現です。検索・スクリーニング・抽出の3つを原著と並べて、言えること・言えないことをまとめます。あわせて、評価の skill /eval を人だけが起動する理由、API キーを使わずサブスクリプションで回す設定、リポジトリを clone して同じ流れを再現する手順を示します。
出典
- Wang Z, Cao L, Danek B, Jin Q, Lu Z, Sun J. Accelerating clinical evidence synthesis with large language models. npj Digit Med 2025;8:509, doi:10.1038/s41746-025-01840-7(arXiv:2406.17755)
- TrialReviewBench(Hugging Face: zifeng-ai/TrialReviewBench、Apache-2.0)
- Anthropic, Claude Code Docs(subagents / skills / hooks)
- NCBI E-utilities(PubMed Central の efetch・elink)
コードは GitHub で公開しています: github.com/HerzLeben/pubmed-slr-screening