Claude Code × Medical Application
【Claude Code】系統的文献レビュー × AI サブエージェント Part2:スクリーニングと subagent・hook の分担
1. はじめに
Part2 は SR の2つ目の工程、一次スクリーニングです。
1-1. この段の目的
一次スクリーニングの目的は、検索で集めた候補のタイトルと抄録を読み、全文を読むべき論文を選ぶことです。業務の SR では2人が独立に全件を読みます。読む量がいちばん多い工程なので、自動化の研究もここに集中しています(【業務説明】スクリーニングの自動化)。
原著 TrialMind は、候補を「読む/読まない」に分ける代わりに、読むべき順に並べます。上位に組み入れ研究が集まれば、人は上から読めば済みます。
| 中身 | 測り方 | |
|---|---|---|
| 問い | 人の手を入れずに、LLM が書いた基準のまま判定して合計で並べたとき、組み入れ研究がどこまで上位に来るか | Recall@20・@50=組み入れ研究のうち、上位20件・50件に入った割合。原著(Immunotherapy)は 0.567・0.713 |
| 次の段への入力 | Part3 のデータ抽出にかける研究 | 本試行では、ベンチマークの答えの研究をそのまま使う(3章の順位は抽出の入力にしない) |
1-2. 原著との対比
| 原著 TrialMind | 本試行 | |
|---|---|---|
| 入力 | 候補 2,000件(組み入れ研究をすべて含む) | Part1 の候補 1,866件(683/698/485件。拾えなかった組み入れ研究1件を足した) |
| 適格基準 | LLM が PICO から作る | skill /pico-to-criteria の案(人は直さない) |
| 判定 | 候補ごと・基準ごとに 1/0/−1 | subagent screener が20件ずつ、基準ごとに 1/0/−1 と逐語引用を書く |
| 順位 | 判定の合計 | 判定の合計(同点は PubMed の relevance 順) |
| 人の関与 | — | なし |
| 指標 | Recall@20・@50 | Recall@20・@50(3本の平均と合算) |
1-3. 手順と結果の要約
| 手順 | 中身 | 結果 |
|---|---|---|
| ① 基準を案のまま使う | /pico-to-criteria が PICO から書いた包含・除外の問いを、一字も変えずに criteria.json にする |
1本あたり7〜8基準。31190844 は比較群の基準 I5 が残った |
| ② 候補をバッチに分ける | スクリプトが20件ずつのファイルにする | 95バッチ(35/35/25) |
| ③ screener が判定する | 1バッチにつき1回起動し、判定と引用を書く。書く直前に hook が引用を照らす | 1,866件すべて検査を通過。差し戻しは1回 |
| ④ 合計で並べ、答えと照らす | rules.py が判定の合計を出し、eval_screening.py が並べて答えの研究の順位を数える |
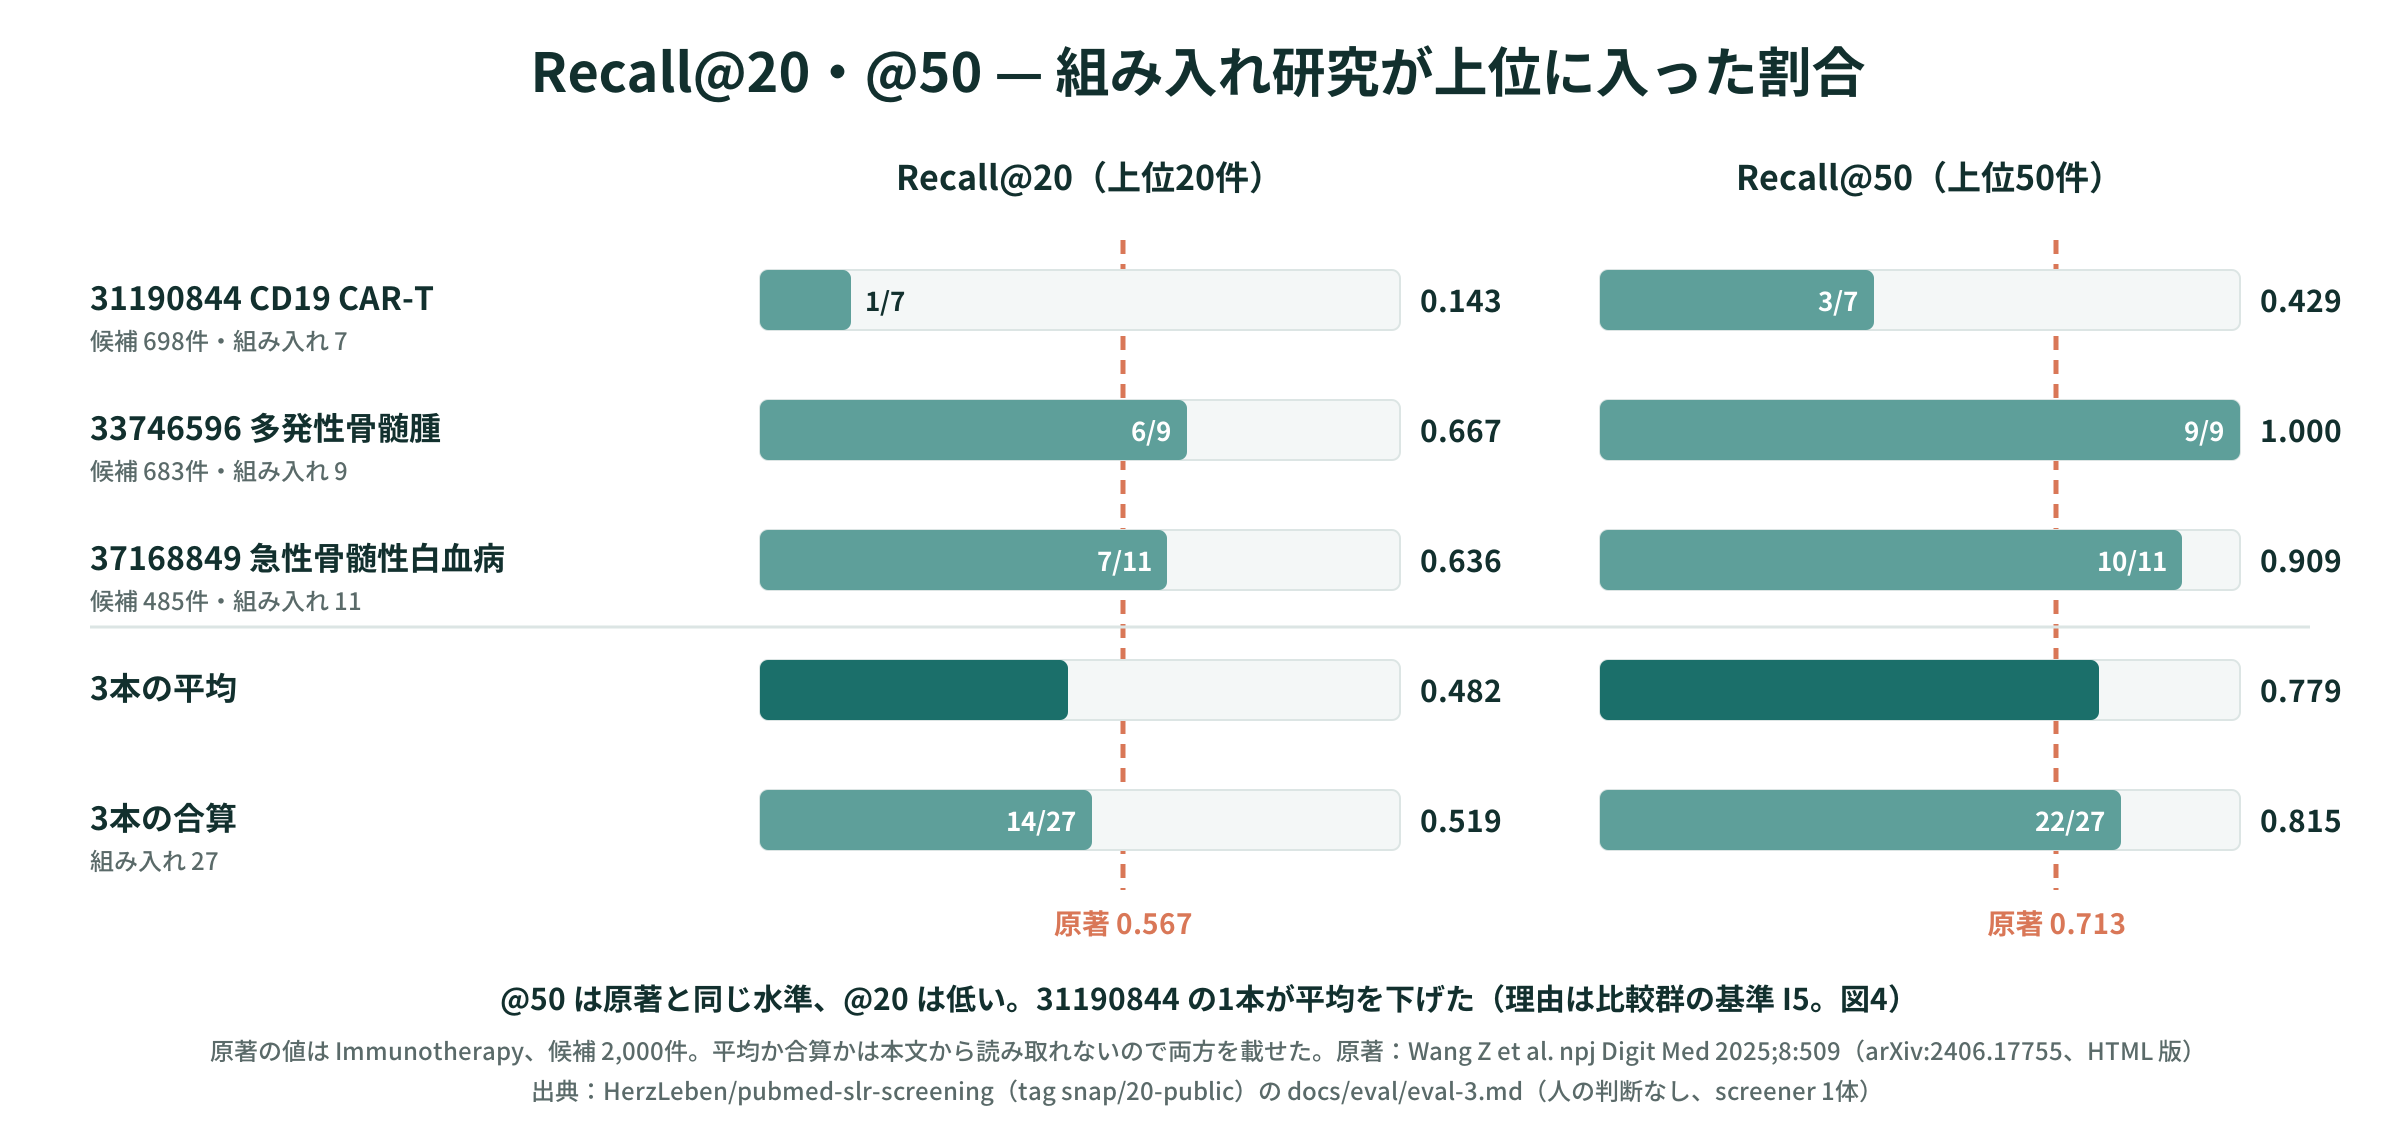
Recall@20 平均 0.482、Recall@50 平均 0.779。@50 は原著と同じ水準、@20 は低い |
2. 手順
2-1. ① 基準を案のまま使う
適格基準は、PICO を「タイトルと抄録で答えられる問い」に割ったものです。skill /pico-to-criteria は、1つの基準に条件を1つだけ入れ、包含(I)と除外(E)に分けて書きます。多発性骨髄腫のレビュー(PMID 33746596)の案は次の7つでした。
| ID | 問い(要約) |
|---|---|
| I1 | 対象は multiple myeloma の患者か |
| I2 | relapsed/refractory か |
| I3 | CAR-T therapy を受けたか |
| I4 | O に挙げた評価項目のどれかを報告しているか |
| E1 | review・editorial など、患者データを新たに報告しない出版か |
| E2 | in vitro や動物だけの前臨床研究か |
| E3 | 結果を含まない試験計画だけか |
案には「人に決めてほしい点」の節もありました。原著と比べる流れでは、その節を screener に渡さず、表の問いだけを使いました。案がすでに扱いを決めていた点(例:case report は E1 で除外しない)だけは、基準の注記(note)として残しています。いちばん影響が大きかったのは、CD19 CAR-T のレビュー(PMID 31190844)の **I5「標準治療または別の治療の比較群があるか」**です。PICO の C から来た基準で、案自身が「採否は人が決める」と書いていました。人が決めない流れなので、I5 は残りました。
2-2. ② バッチに分ける
スクリプト make_batches.py が、候補を20件ずつのファイルにします。ファイルには、基準・候補のタイトルと抄録・書き込み先のパスが入っています。screener には「読むのはこのファイル1つだけ」と指示しています(Read を hook で絞ってはいません)。一度判定したバッチは、中身が変わるならスクリプトが書き換えを止めます。
2-3. ③ screener が判定する
本体は、バッチファイルのパスだけを委任メッセージに書いて screener を起動します。screener は候補1件ごとに、全基準を 1(満たす)/0(タイトル・抄録からは分からない)/−1(満たさない)で判定し、±1 には根拠の逐語引用を付けます。E(除外)は向きが逆で、除外に当たらないなら 1 です。
{"pmid": "12345678",
 "criteria": [
   {"id": "I1", "verdict": 1, "quote": "patients with relapsed or refractory B-cell lymphoma"},
   {"id": "I2", "verdict": 0, "quote": null, "note": "標的抗原の記載なし"},
   {"id": "E1", "verdict": 1, "quote": "We conducted a phase 1 trial"}]}
書かれていないことは 0 にします。0 は組み入れる側に倒れるので、推測で ±1 にしないことが漏れを防ぎます。
2-4. ④ 合計で並べ、答えと照らす
スクリプト rules.py が、候補ごとに判定値を足してスコアにします。満点は基準の数(7または8)です。評価のスクリプト eval_screening.py がスコアの高い順に並べ、同点は PubMed の relevance 順にします。最後に、ベンチマークの答えの研究が上位20件・50件に入ったかを数えます。答えは、ここまでのどの段にも渡していません。
3. 結果
3-1. Recall@20・@50
| レビュー | 候補 | 組み入れ | Recall@20 | Recall@50 |
|---|---|---|---|---|
| 31190844 CD19 CAR-T | 698 | 7 | 0.143(1/7) | 0.429(3/7) |
| 33746596 多発性骨髄腫 | 683 | 9 | 0.667(6/9) | 1.000(9/9) |
| 37168849 急性骨髄性白血病 | 485 | 11 | 0.636(7/11) | 0.909(10/11) |
| 3本の平均 | 0.482 | 0.779 | ||
| 3本の合算 | 27 | 0.519(14/27) | 0.815(22/27) | |
| 原著(arXiv 版) | 2,000 | 0.567 | 0.713 |
原著の値が平均か合算かは本文から読み取れないので、両方を載せました。Recall@50 は原著と同じ水準、Recall@20 は低めです。3本しかないので、31190844 の1本が平均を大きく下げています。
3-2. 組み入れ研究の順位
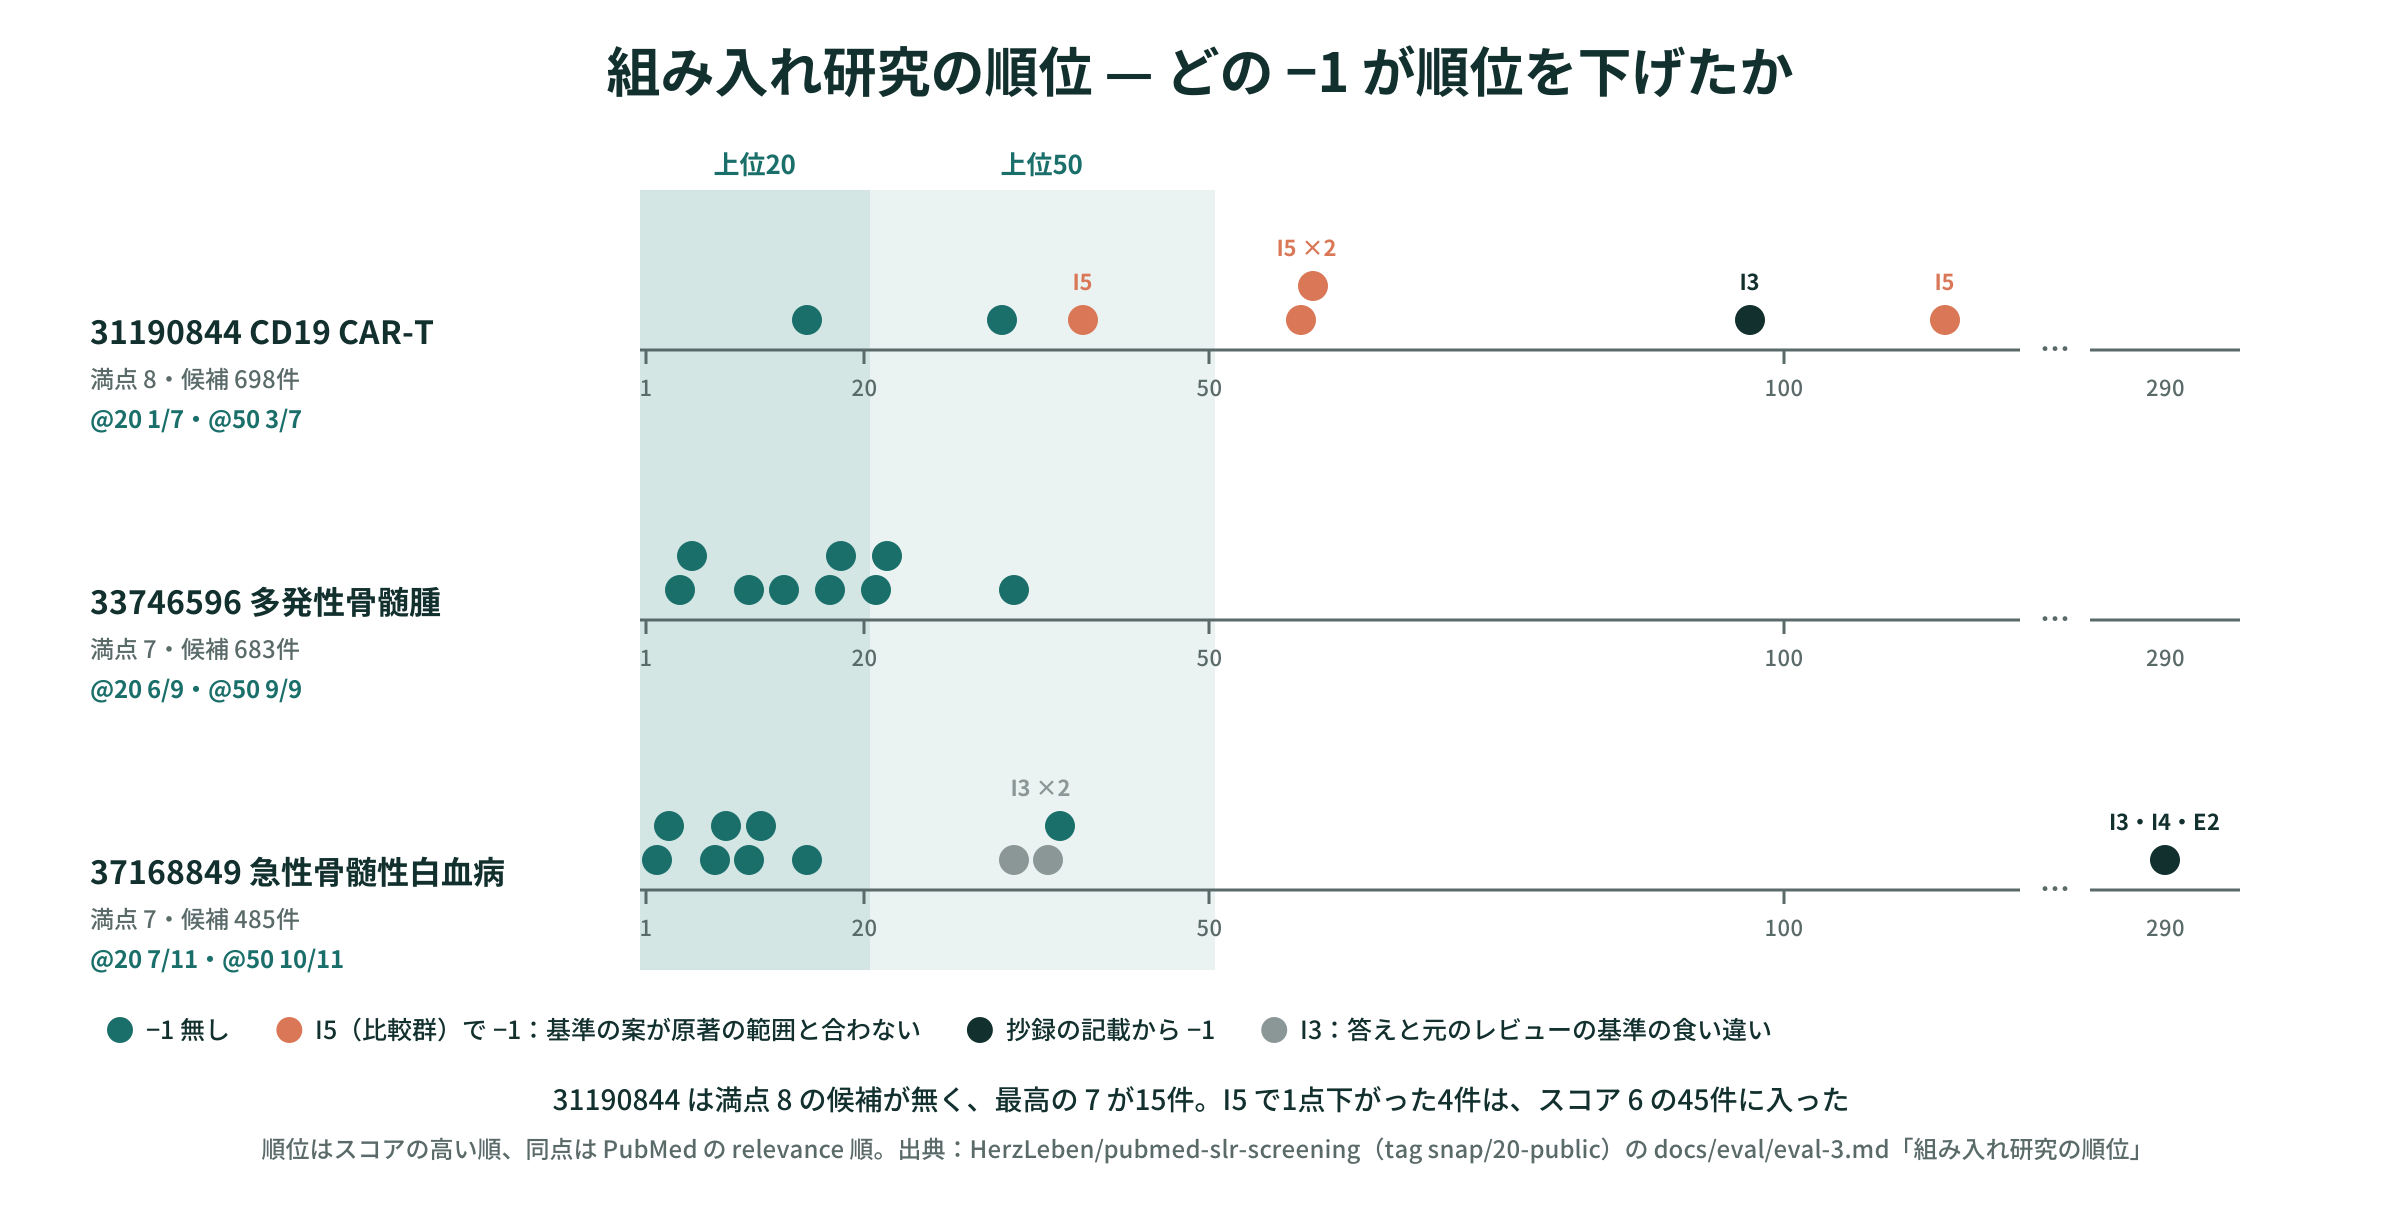
順位を下げたのは、どれも −1 の判定です。
| レビュー | 順位を下げた研究 | −1 の基準 | 理由 |
|---|---|---|---|
| 31190844 | 4件(39・58・59・114位) | I5(比較群) | 単群の試験が I5 で1点下がった。候補698件のうち110件が I5 = −1 |
| 31190844 | 1件(97位) | I3(自家) | 抄録の記載による |
| 37168849 | 2件(33・36位) | I3(CAR-T) | CAR-NK と、CAR を持たない NK 細胞。答えが元のレビューの基準(CAR-T)から外れている |
| 37168849 | 1件(290位) | I3・I4・E2 | 患者のデータが全文にしか無く、抄録では前臨床に見える |
- 31190844:満点の 8 に届く候補が無く、最高の 7 が15件でした。組み入れ7件のうち4件が I5 で 6 に下がり、スコア 6 の45件に埋もれました。同じ判定から I5 を外して足し直すと、Recall@50 は 0.429 → 0.714 です(参考。原著との比較には使いません)
- 33746596:−1 は1件もありません。@20 を外れた3件は、満点の21件の同点の並びと、スコア 6 の順で決まりました
- 37168849:33・36位の2件(36位は Part1 で拾えなかった 28864289)は、答えの側の食い違いです。290位の1件は、患者のデータが全文にしか無く、抄録だけでは前臨床の研究に見えました
4. この作業の組み方
4-1. 本体1つで判定したとき起きたこと
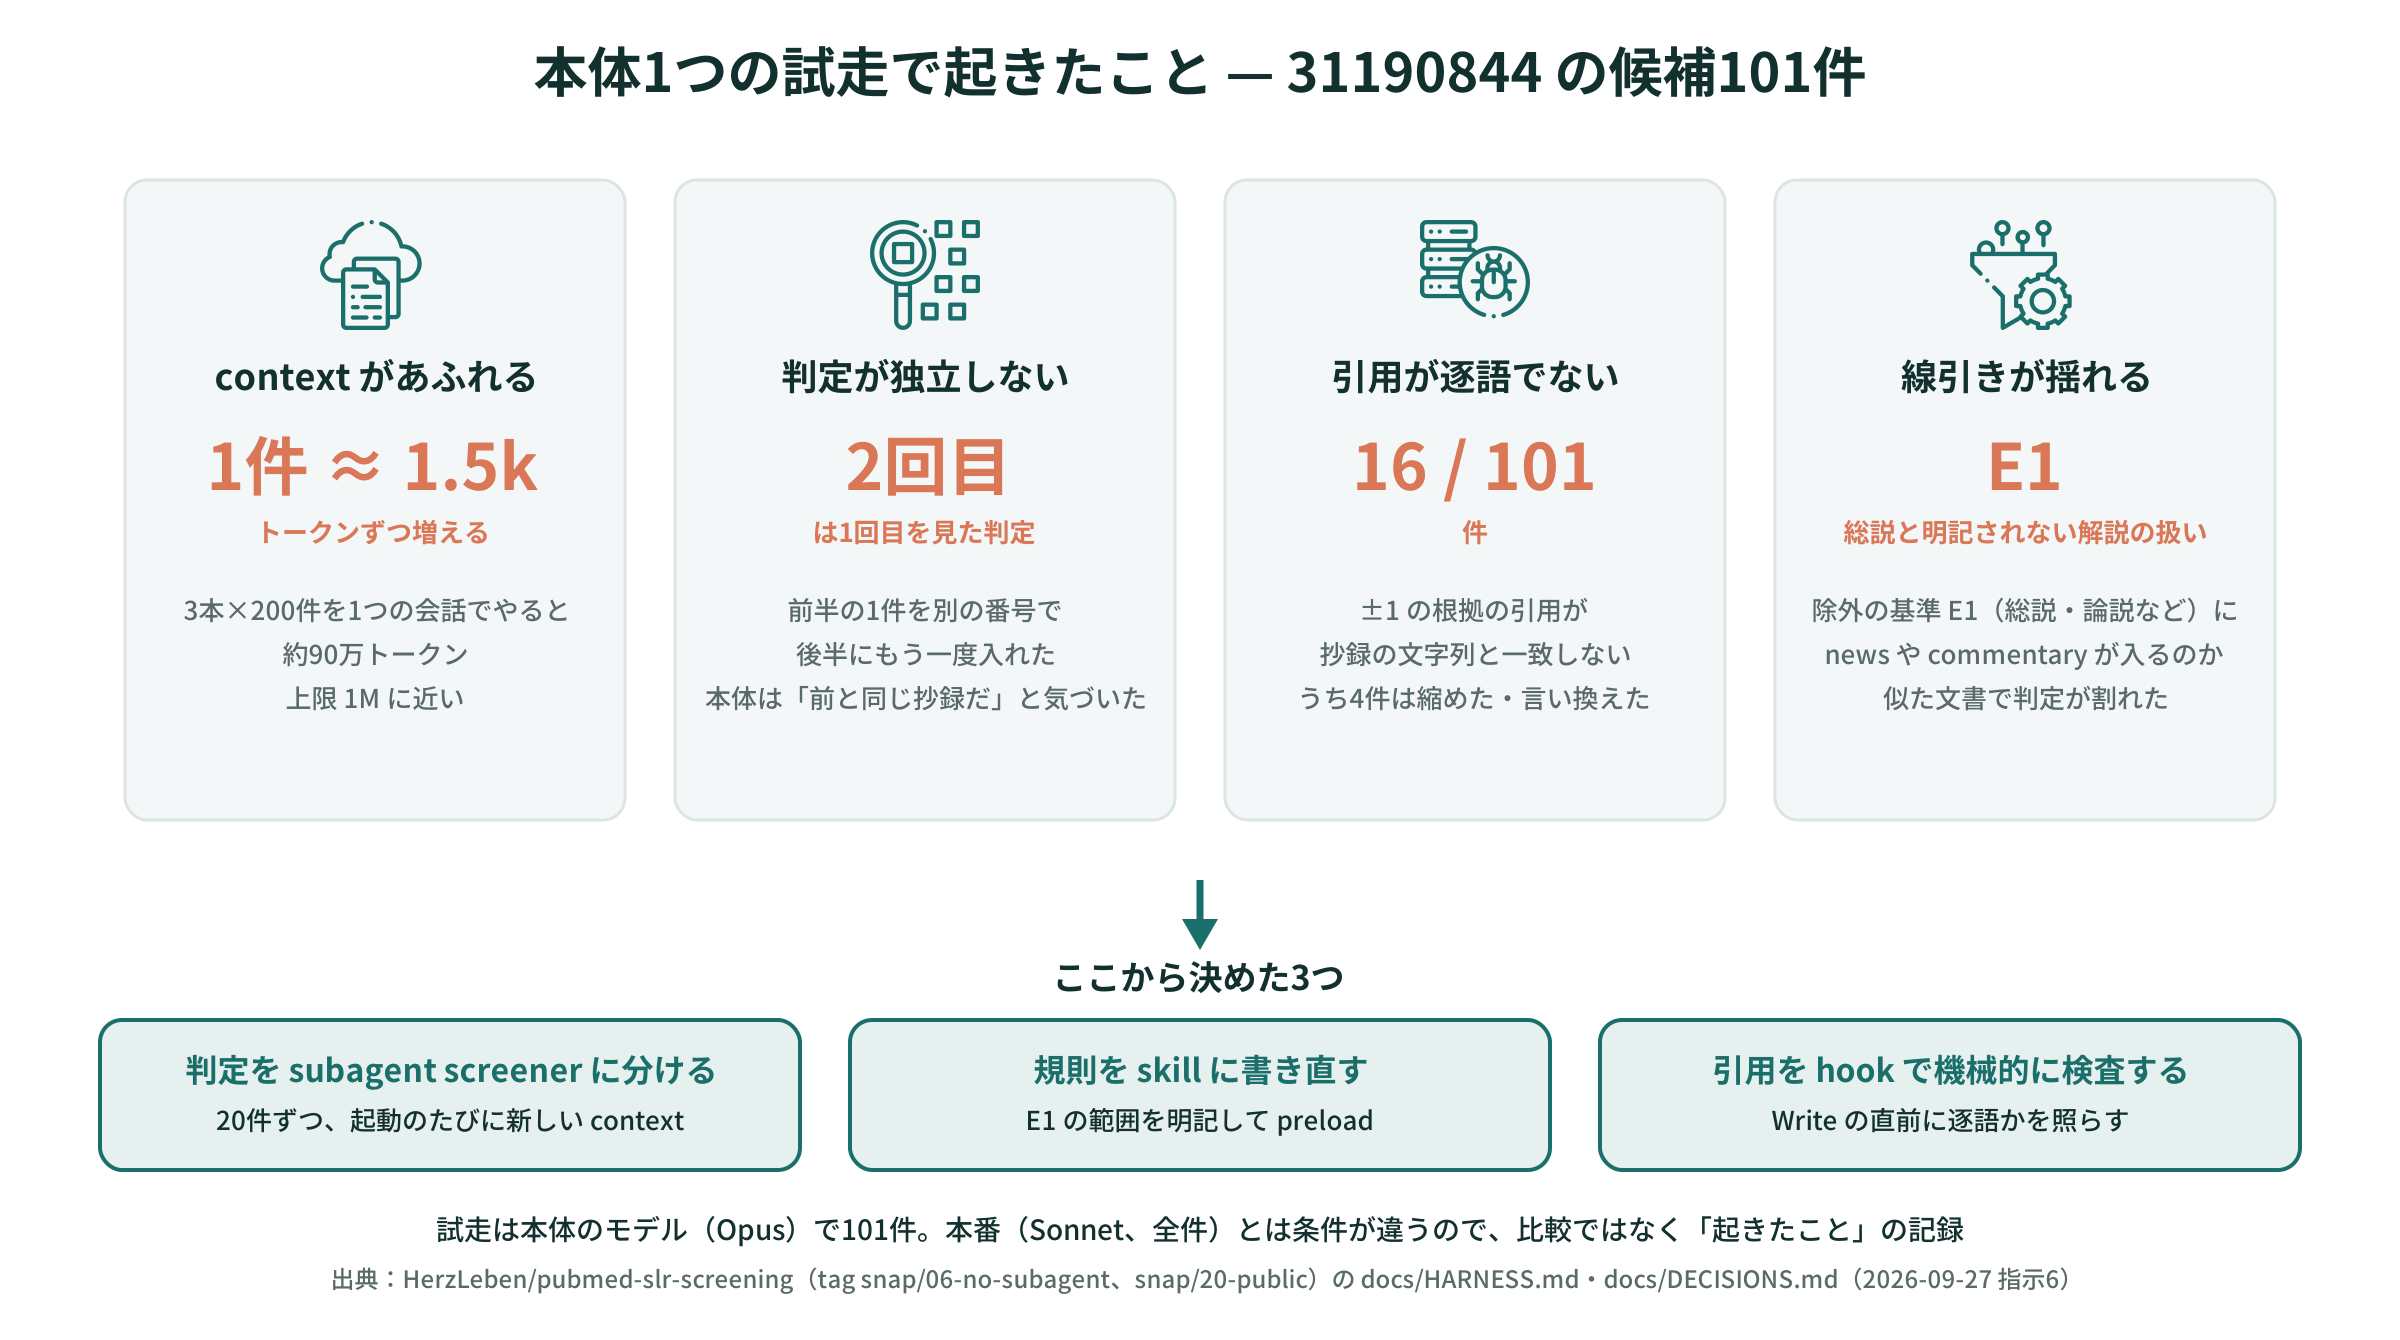
subagent を作る前に、本体(Claude Code のメインの会話)1つで 31190844 の候補101件を判定してみました(tag snap/06-no-subagent)。101件には、前半の1件を別の番号で後半にもう一度入れています。
| 起きたこと | 中身 |
|---|---|
| context があふれる | 1件の判定でおよそ 1.5k トークン増えた。3本×200件を1つの会話でやると約90万で、上限の 1M に近い |
| 判定が独立しない | 2回入れた研究に、本体は「前と同じ抄録だ」と気づいていた。2回目は1回目を見た判定になる |
| 引用が逐語でない | 101件中16件。うち4件は抄録の語を縮めた・言い換えたもの |
| 線引きが揺れる | 総説と明記されない解説を E1 でどう扱うかが、news と commentary で食い違った |
ここから、screener を分ける・規則を決め直す・引用を機械で検査する、の3つを決めました。E1 の範囲(「その文書自身の患者データを含まず、他の研究を紹介・論評するもの」)は、この試走の揺れを受けて規則に書き足したものです。
4-2. screener の subagent とバッチ
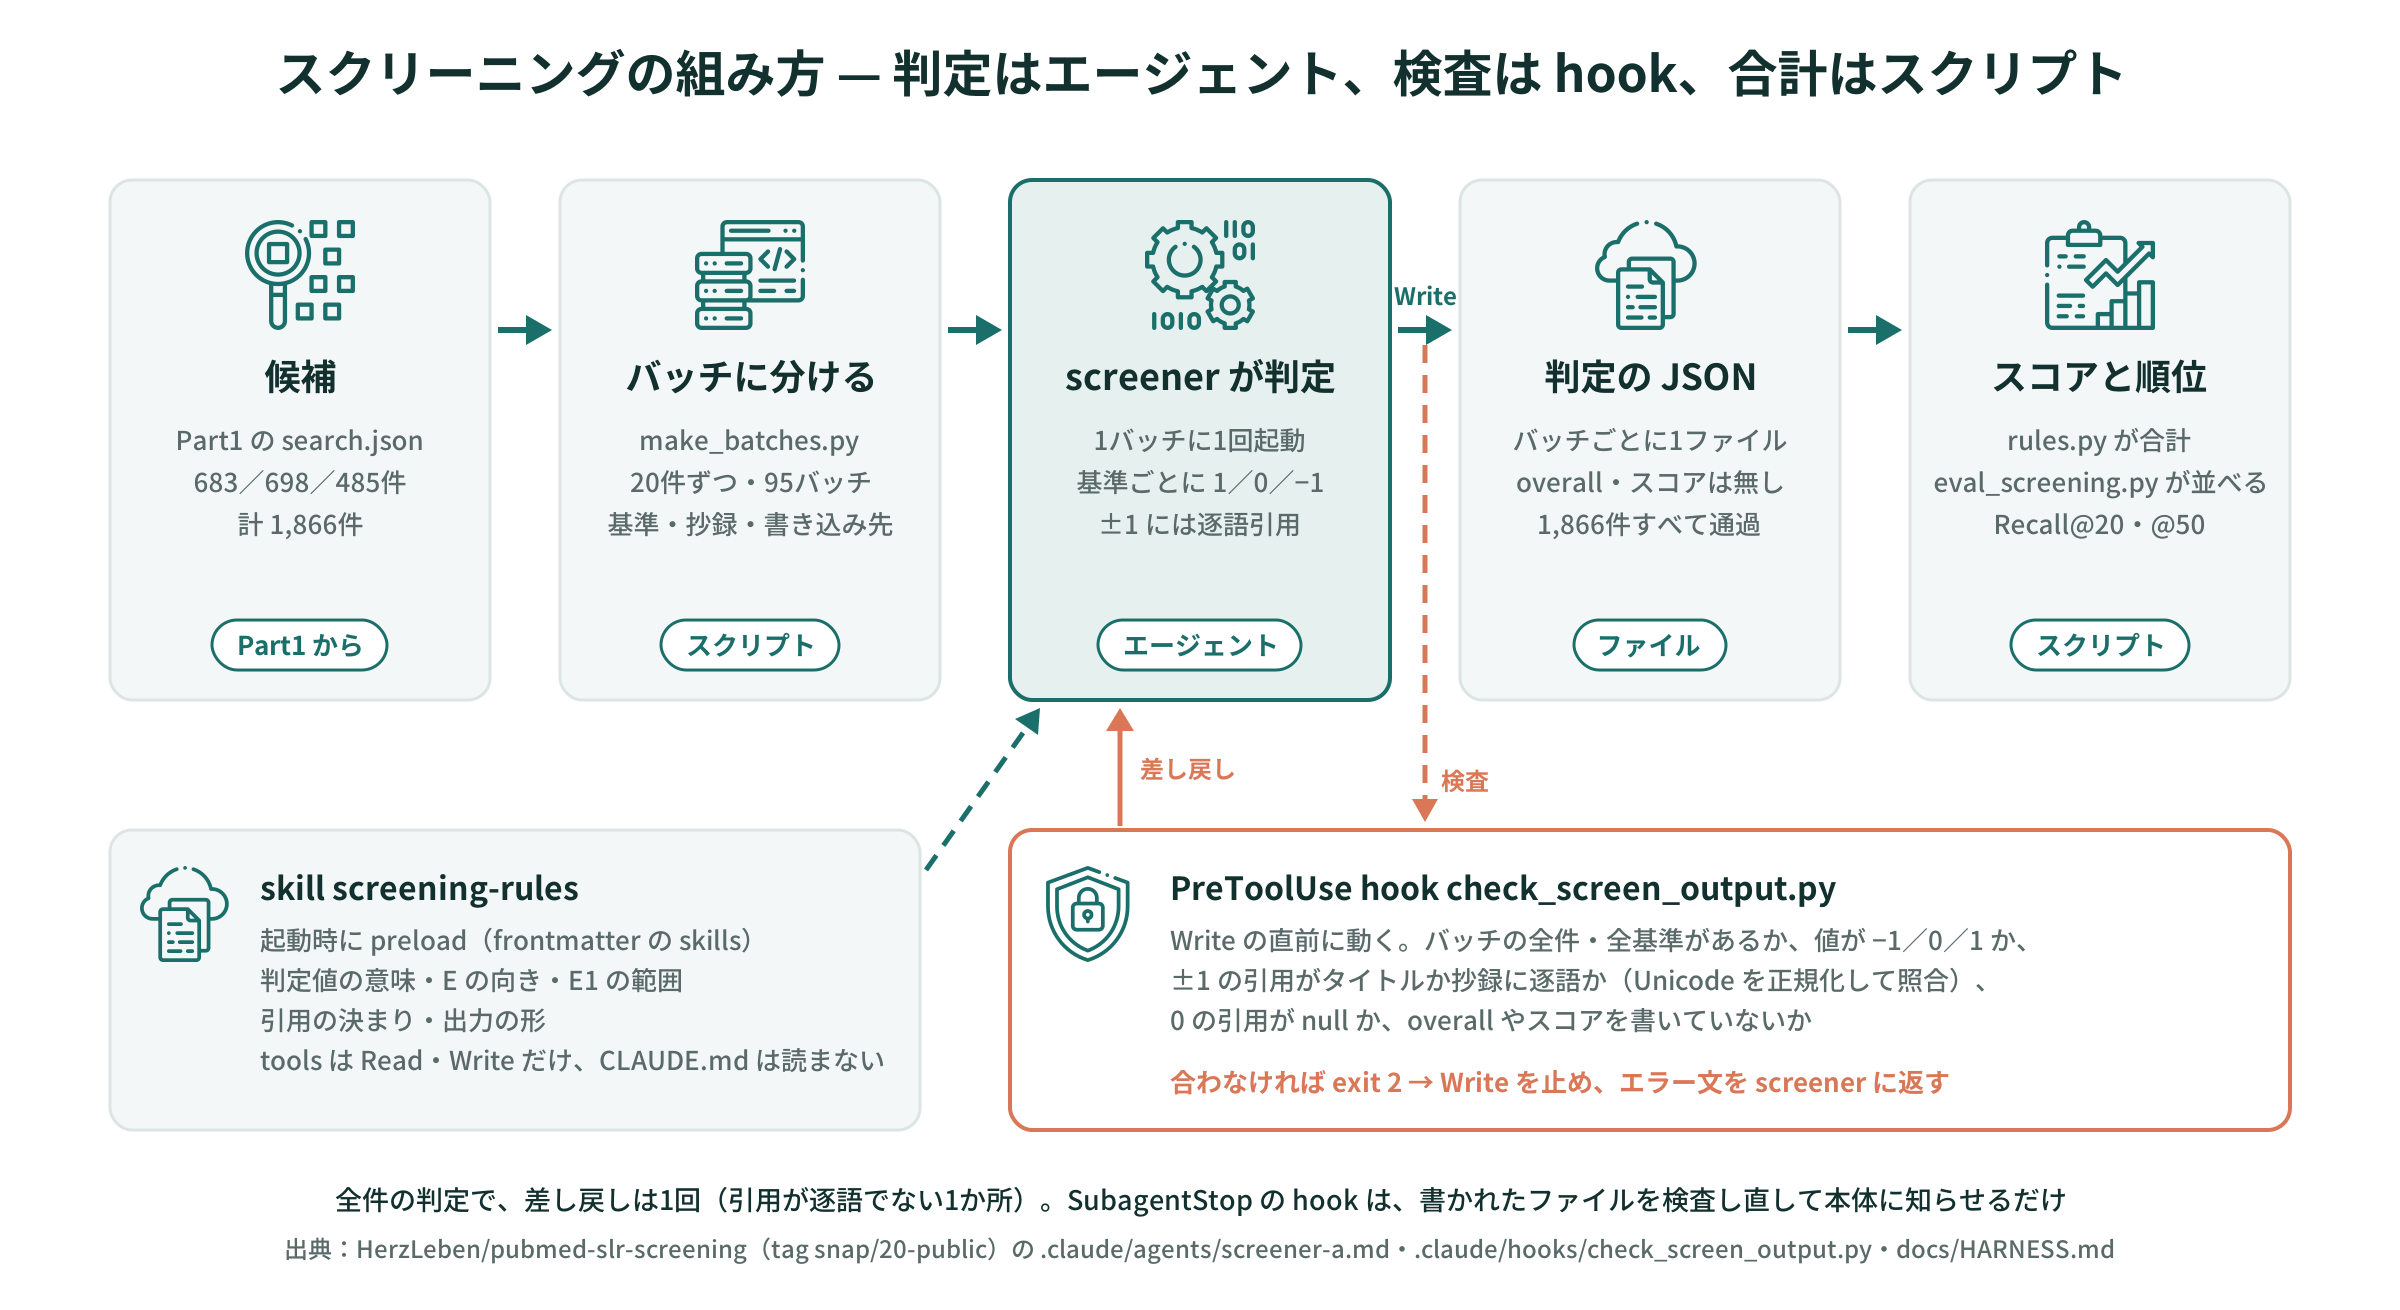
screener の定義(.claude/agents/screener-a.md)の先頭は次のとおりです。
name: screener-a
description: SLR のタイトル・抄録スクリーニングの判定役(略)。1回の起動で1バッチ(20件)を、
  基準ごとに 1/0/-1 と逐語引用で判定し、results/screen/a/ に JSON で書く。(略)
tools: Read, Write
model: sonnet
omitClaudeMd: true
skills:
- screening-rules- 1回の起動で20件:起動のたびに新しい context なので、前のバッチの判定が持ち越されない。試走の1回は約1.5分、約3.6万トークンだった
- 道具は
ReadとWriteだけ:検索も実行もできない omitClaudeMd: true:本体向けのCLAUDE.md(評価の手順や答えの置き場所が書いてある)を読まない- overall もスコアも書かない:合計はスクリプトが出す
95バッチは、バッチに分けて同時にいくつか走らせました。
4-3. 判定の規則を skill で preload する
判定の規則は skill screening-rules にまとめ、frontmatter の skills で screener の起動時に読み込ませました。中身は、判定値の意味、E の向き、E1 の範囲、引用の決まり(連続した1か所をそのまま写す。省略記号・言い換え・つなぎ合わせは不可)、出力の形です。
agent 定義の本文には「規則だけに従う」「読むのはバッチファイル1つ」、書き込み先、差し戻されたときの直し方、やらないことを書き、判定の規則そのものは skill に置きました。規則を直すときは skill の1か所を直せば済みます。
4-4. 引用を検査する hook
screener が出力を Write する直前に、PreToolUse の hook check_screen_output.py が動きます。
| 検査すること | 合わないとき |
|---|---|
| バッチの全件があり、余計な PMID が無い | exit 2 で Write を止める |
| 各候補に全基準が1回ずつ、ID 順で、値が −1/0/1 | 同上 |
| ±1 の引用が、タイトルか抄録に逐語である(Unicode の正規化をしてから照合) | 同上 |
| 0 の引用が null で、overall やスコアが無い | 同上 |
PreToolUse の hook が exit 2 を返すと、tool の呼び出しが止まり、hook のエラー文が screener に返ります。screener はエラーに書かれた PMID と基準だけを直して、もう一度 Write します。全件の判定では、差し戻しは1回でした(引用が逐語でない1か所)。
最初の設計では、subagent が終わるとき(SubagentStop)に検査して差し戻すつもりでした。公式ドキュメントを読み直すと、SubagentStop は exit 2 で止められません(subagent はもう終わっている)。そこで差し戻しを PreToolUse に移し、SubagentStop には書かれたファイルを検査し直して本体に知らせる役だけを残しました。
4-5. 人が決めたこと
| 人が決めたこと | 理由 |
|---|---|
基準は /pico-to-criteria の案のまま使い、I5 も直さない |
原著も LLM が書いた基準のまま評価している |
| 「人に決めてほしい点」は screener に渡さない | 問いのまま渡すと、screener が人の代わりに決めることになる |
| 0 は組み入れる側に倒す | SR では見落としを取り返せない |
| 1バッチにつき1回だけ判定させ、エラーで書けなかったときだけ起動し直す | よい判定を選ぶために回し直すと、人の判断が入る |
| 答えを見たあとで、基準・規則・判定を動かさない | 答えに合わせて直した Recall は、評価にならない |
5. 言えること・言えないこと
言えること
- 人の判断を入れずに、LLM が書いた基準のまま判定して合計で並べると、3本の Recall@50 は平均 0.779 で、原著の 0.713 と同じ水準だった
- 順位を下げた −1 8件のうち6件は、基準の案(I5)か、答えと元のレビューの基準の食い違いで説明できた。残る2件は、抄録の記載どおりの判定だった
- 1,866件の判定は、すべて逐語引用の検査を通った
言えないこと
- 原著と同じ性能だ、とは言えない。候補が少ない(485〜698件 vs 2,000件)ので上位に入りやすい。レビューは3本、モデルも違う(原著は GPT-4 と Claude 3 Sonnet、本試行は現行の Claude Sonnet)
- 引用が判定を支えている、とは言えない。hook が確かめるのは、引用が抄録に逐語であることだけ。その引用でその判定になるかは見ていない
- I5 の判定が見込みどおりだった、とは言えない。試走の20件では I5 はすべて 0 で、単群を明記した抄録だけが −1 になると見込んでいた。全件では 698件中110件が −1 になり、組み入れ研究7件のうち4件が含まれた。どの引用で −1 にしたかは、この記事では確かめていない
- 本体1つより subagent のほうが判定が正しい、とは言えない。試走は本体のモデル(Opus)で 101件、本番は Sonnet で全件と、条件がそろっていない。4-1 は「起きたこと」の記録で、比較ではない
- 手順どおりに評価した、とも言い切れない。リポジトリの決まりでは評価の skill
/evalは人だけが起動するが、eval-3 の評価は、人の指示を受けた別のセッションが実行した。結果・基準・検索式は変えていない
6. まとめ
この段の目的は、全文を読むべき論文を上位に集めることと、それを人の手なしでどこまでできるかを確かめることでした。LLM が書いた基準のまま判定して並べると、Recall@50 は3本の平均 0.779(原著 0.713)、Recall@20 は 0.482(原著 0.567)です。
低かった1本は、比較群の基準 I5 がそのまま残ったことで説明できます。基準の案に人が決めるべき問いが残っていれば、それがそのまま順位を下げます。人の判断を外した結果が、人の判断の入れどころを示しました。
組み方としては、本体1つで判定したときの持ち越しと引用の崩れを受けて、判定を subagent screener に20件ずつ分け、規則を skill で preload し、引用を PreToolUse の hook で検査しました。
次のステップ
Part3 ではデータ抽出を扱います。組み入れた研究の全文(PMC で読めるものだけ)から、患者数・年齢・標的抗原などの研究特性を subagent extractor が抜き出し、原著と同じ Accuracy で比べます。全文をどう渡し、なぜ commit しないかも示します。
出典
- Wang Z, Cao L, Danek B, Jin Q, Lu Z, Sun J. Accelerating clinical evidence synthesis with large language models. npj Digit Med 2025;8:509, doi:10.1038/s41746-025-01840-7(arXiv:2406.17755)
- TrialReviewBench(Hugging Face: zifeng-ai/TrialReviewBench、Apache-2.0)
- Anthropic, Claude Code Docs(subagents / skills / hooks)
コードは GitHub で公開しています: github.com/HerzLeben/pubmed-slr-screening