Claude Code × Medical Application
【技術説明】文献スクリーニング自動化 — 技術の系譜と評価指標
1. タスクの定義
SR のスクリーニングは、正例(組み入れ)が数%しかない二値分類です(SR の工程は【業務説明】系統的文献レビューを参照)。自動化の研究の大半は、読む量が最も多いタイトル・抄録の一次スクリーニングを対象にしています。
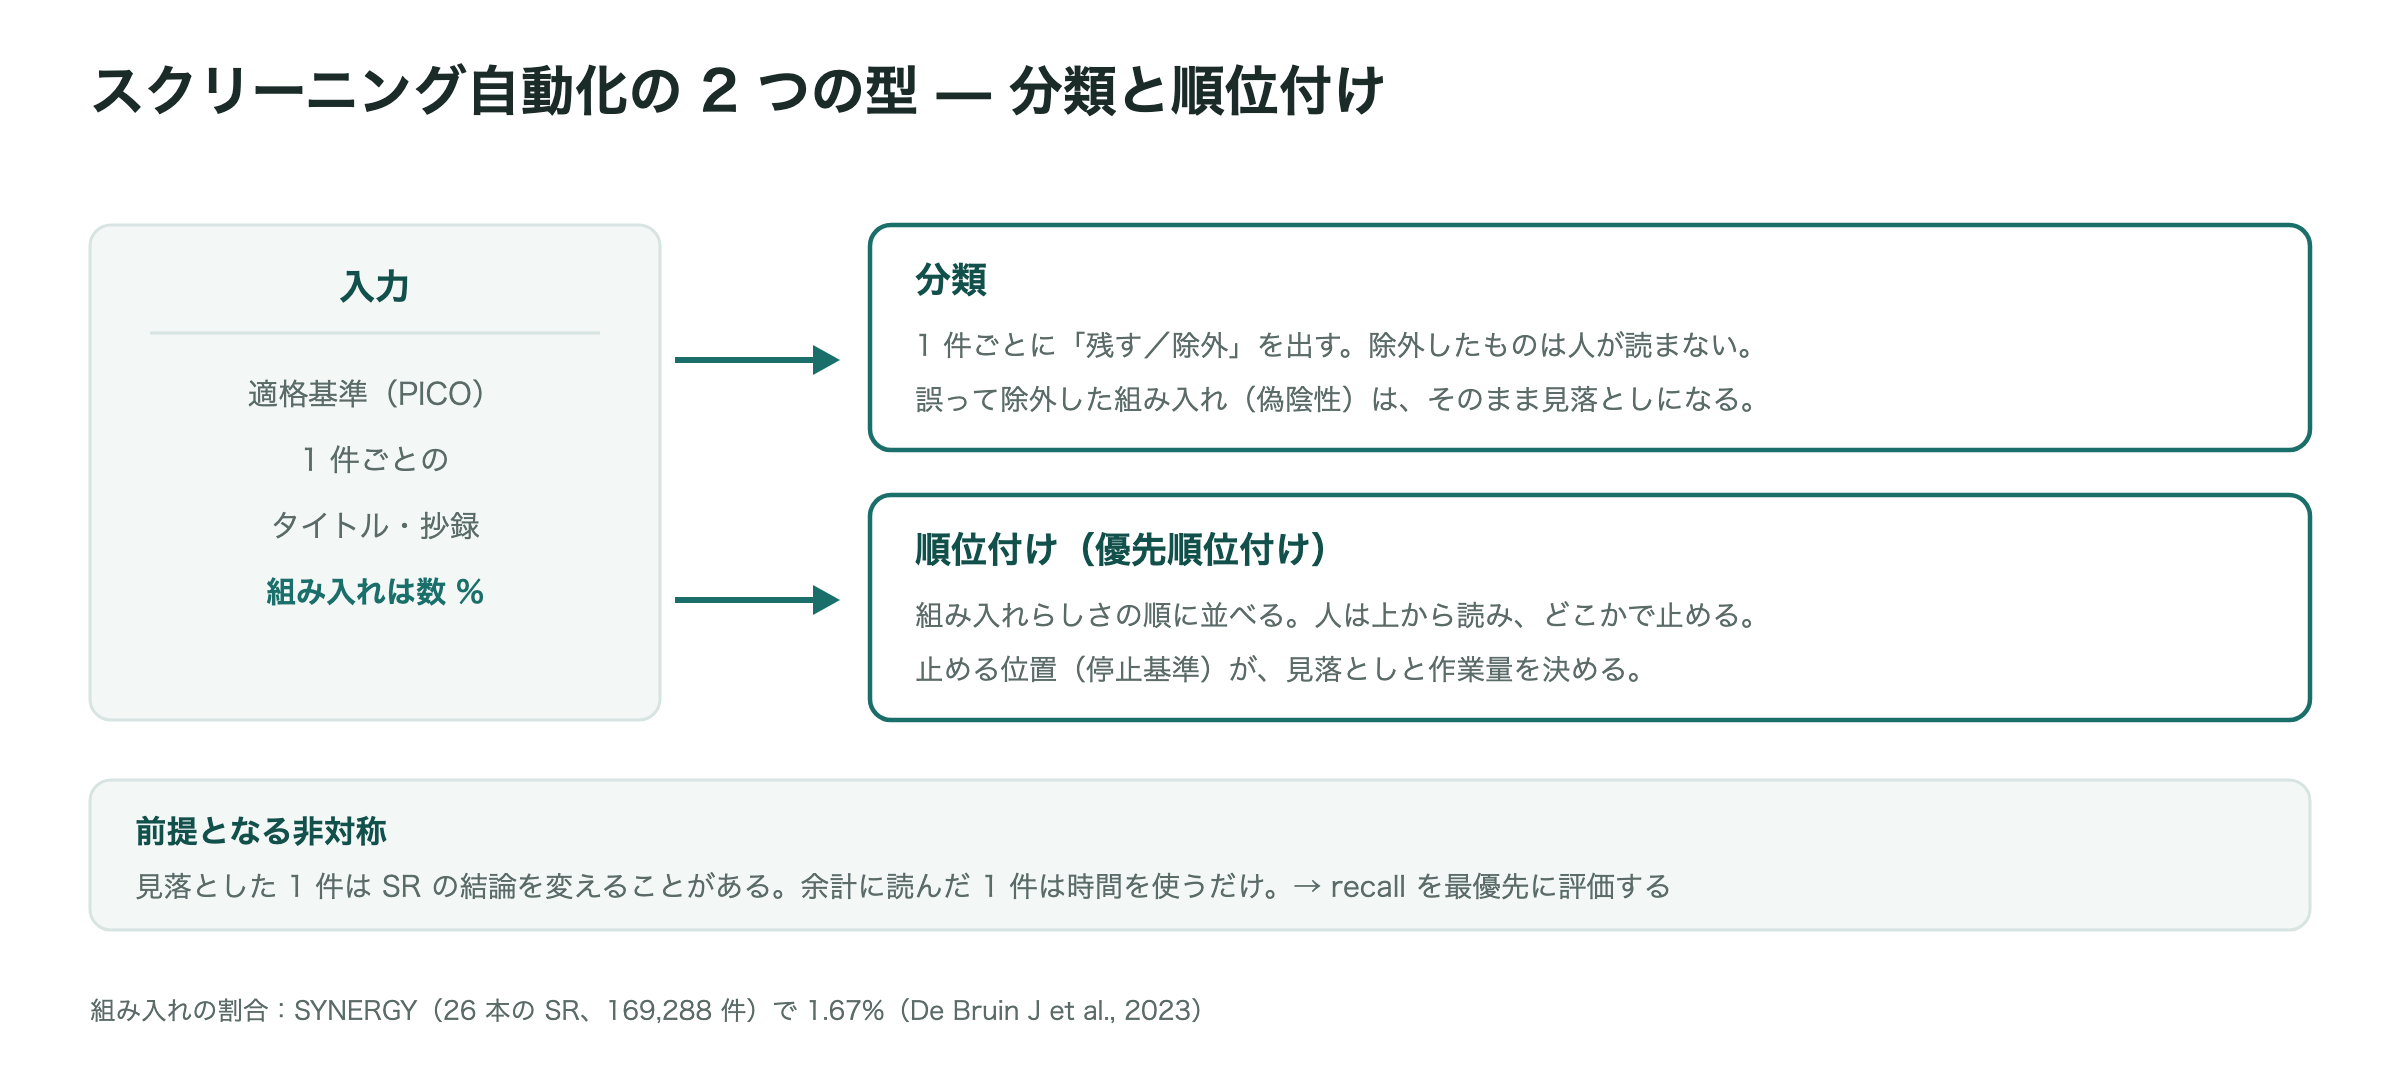
自動化には2つの型があります。1件ずつ「残す/除外」を出す分類と、組み入れらしさの順に並べる順位付けです。分類では誤って除外した1件がそのまま見落としになり、順位付けではどこで読むのを止めるかが見落としと作業量を決めます。
見落とした1件は SR の結論を変えることがありますが、余計に読んだ1件は時間を使うだけです。この非対称が、評価指標の設計を決めてきました(3章)。
2. 系譜
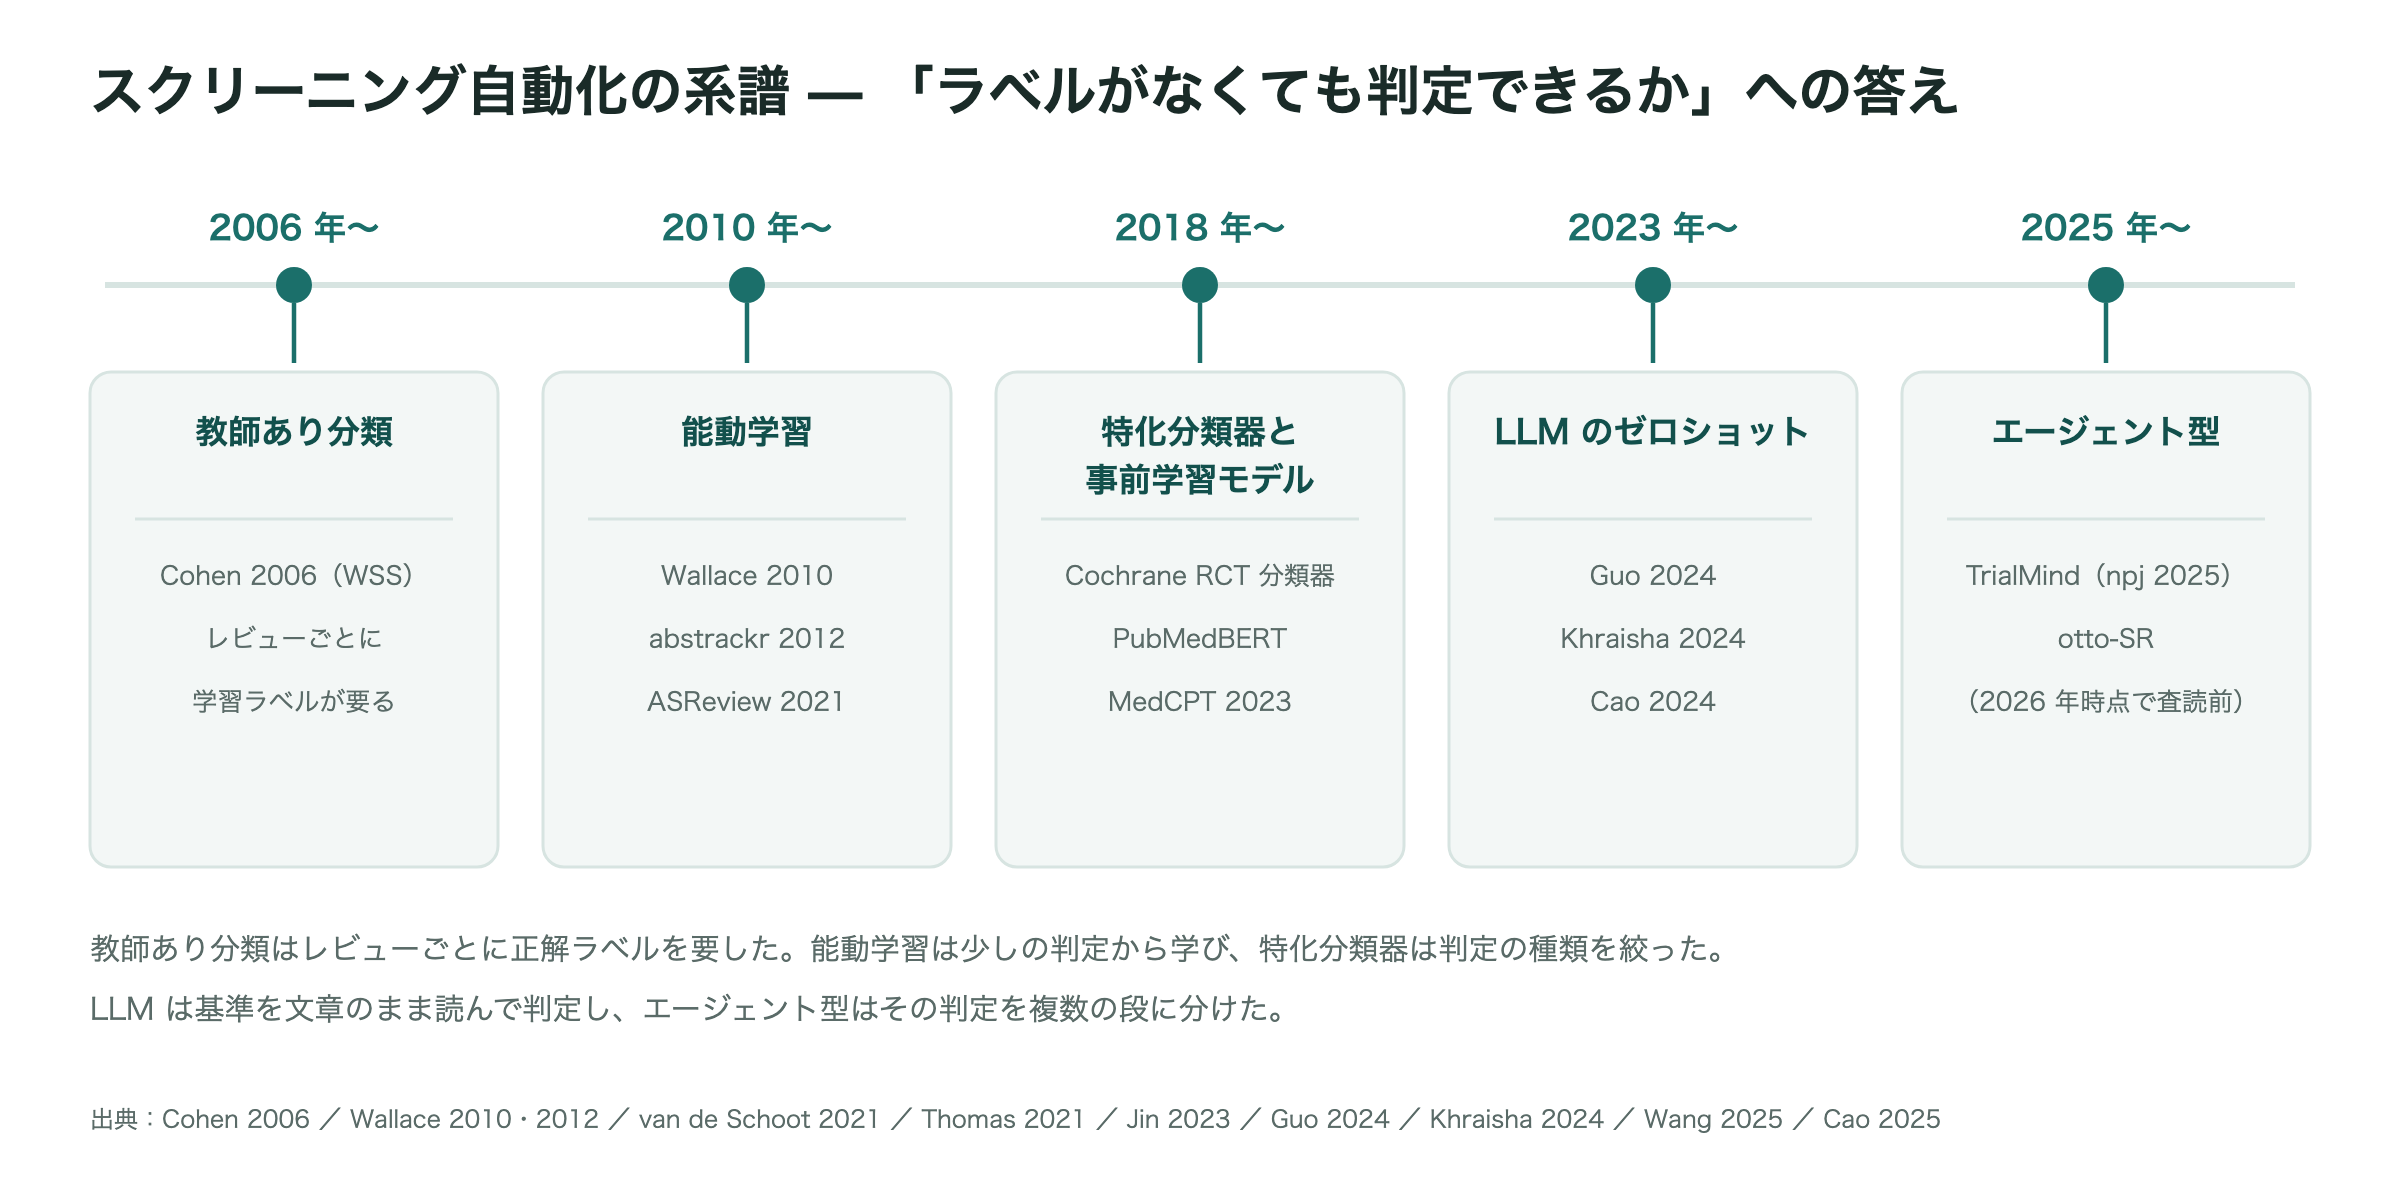
20年の流れは、1つの問いへの答えの積み重ねとして読めます。**「そのレビュー用の正解ラベルがなくても、どこまで判定できるか」**です。
2-1. 教師あり分類
出発点は Cohen らの2006年の研究です。薬効群の SR 15本の判定結果で分類器(voting perceptron)を学習させ、15本中11本で人が読む量が減り、3本では50%以上減りました。評価指標 WSS もこの論文で提案されています(3章)。
弱点は、レビューごとに学習用の正解ラベルが要ることです。新しい SR を始めるときには、まだそのラベルがありません。
2-2. 能動学習
これに答えたのが能動学習です。人が少し判定するたびにモデルを学習し直し、次に読むべき文献を上に並べ直します。Wallace ら(2010)、abstrackr(2012)、ASReview(2021)がこの流れです。
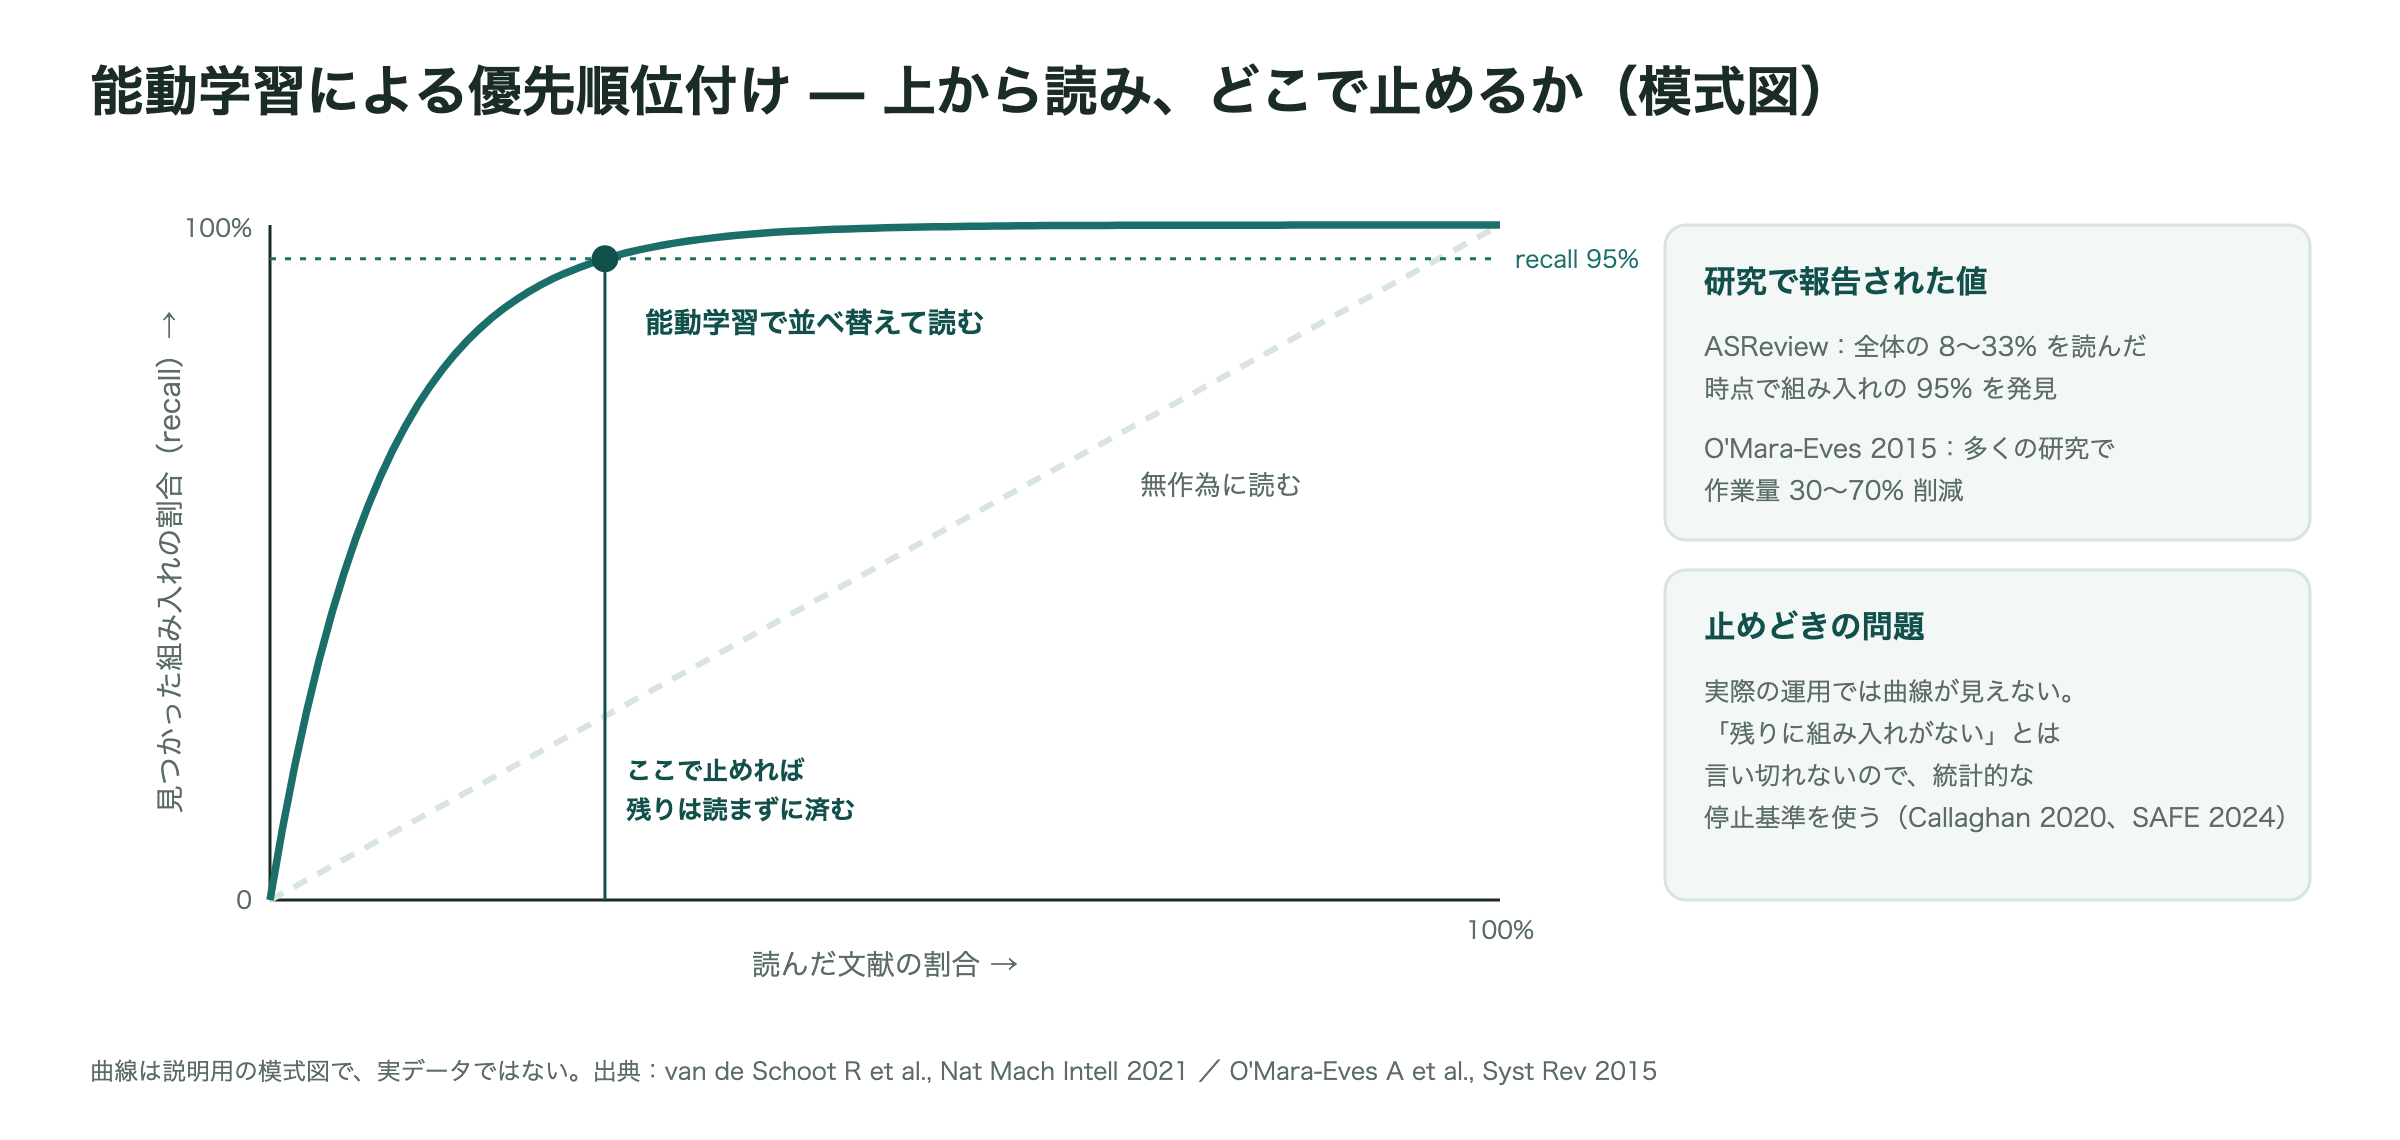
うまく並べば、組み入れの大半は序盤に集まります。残る問題は止めどきです。実際の運用では曲線が見えないので、「残りに組み入れがない」とは言い切れません。
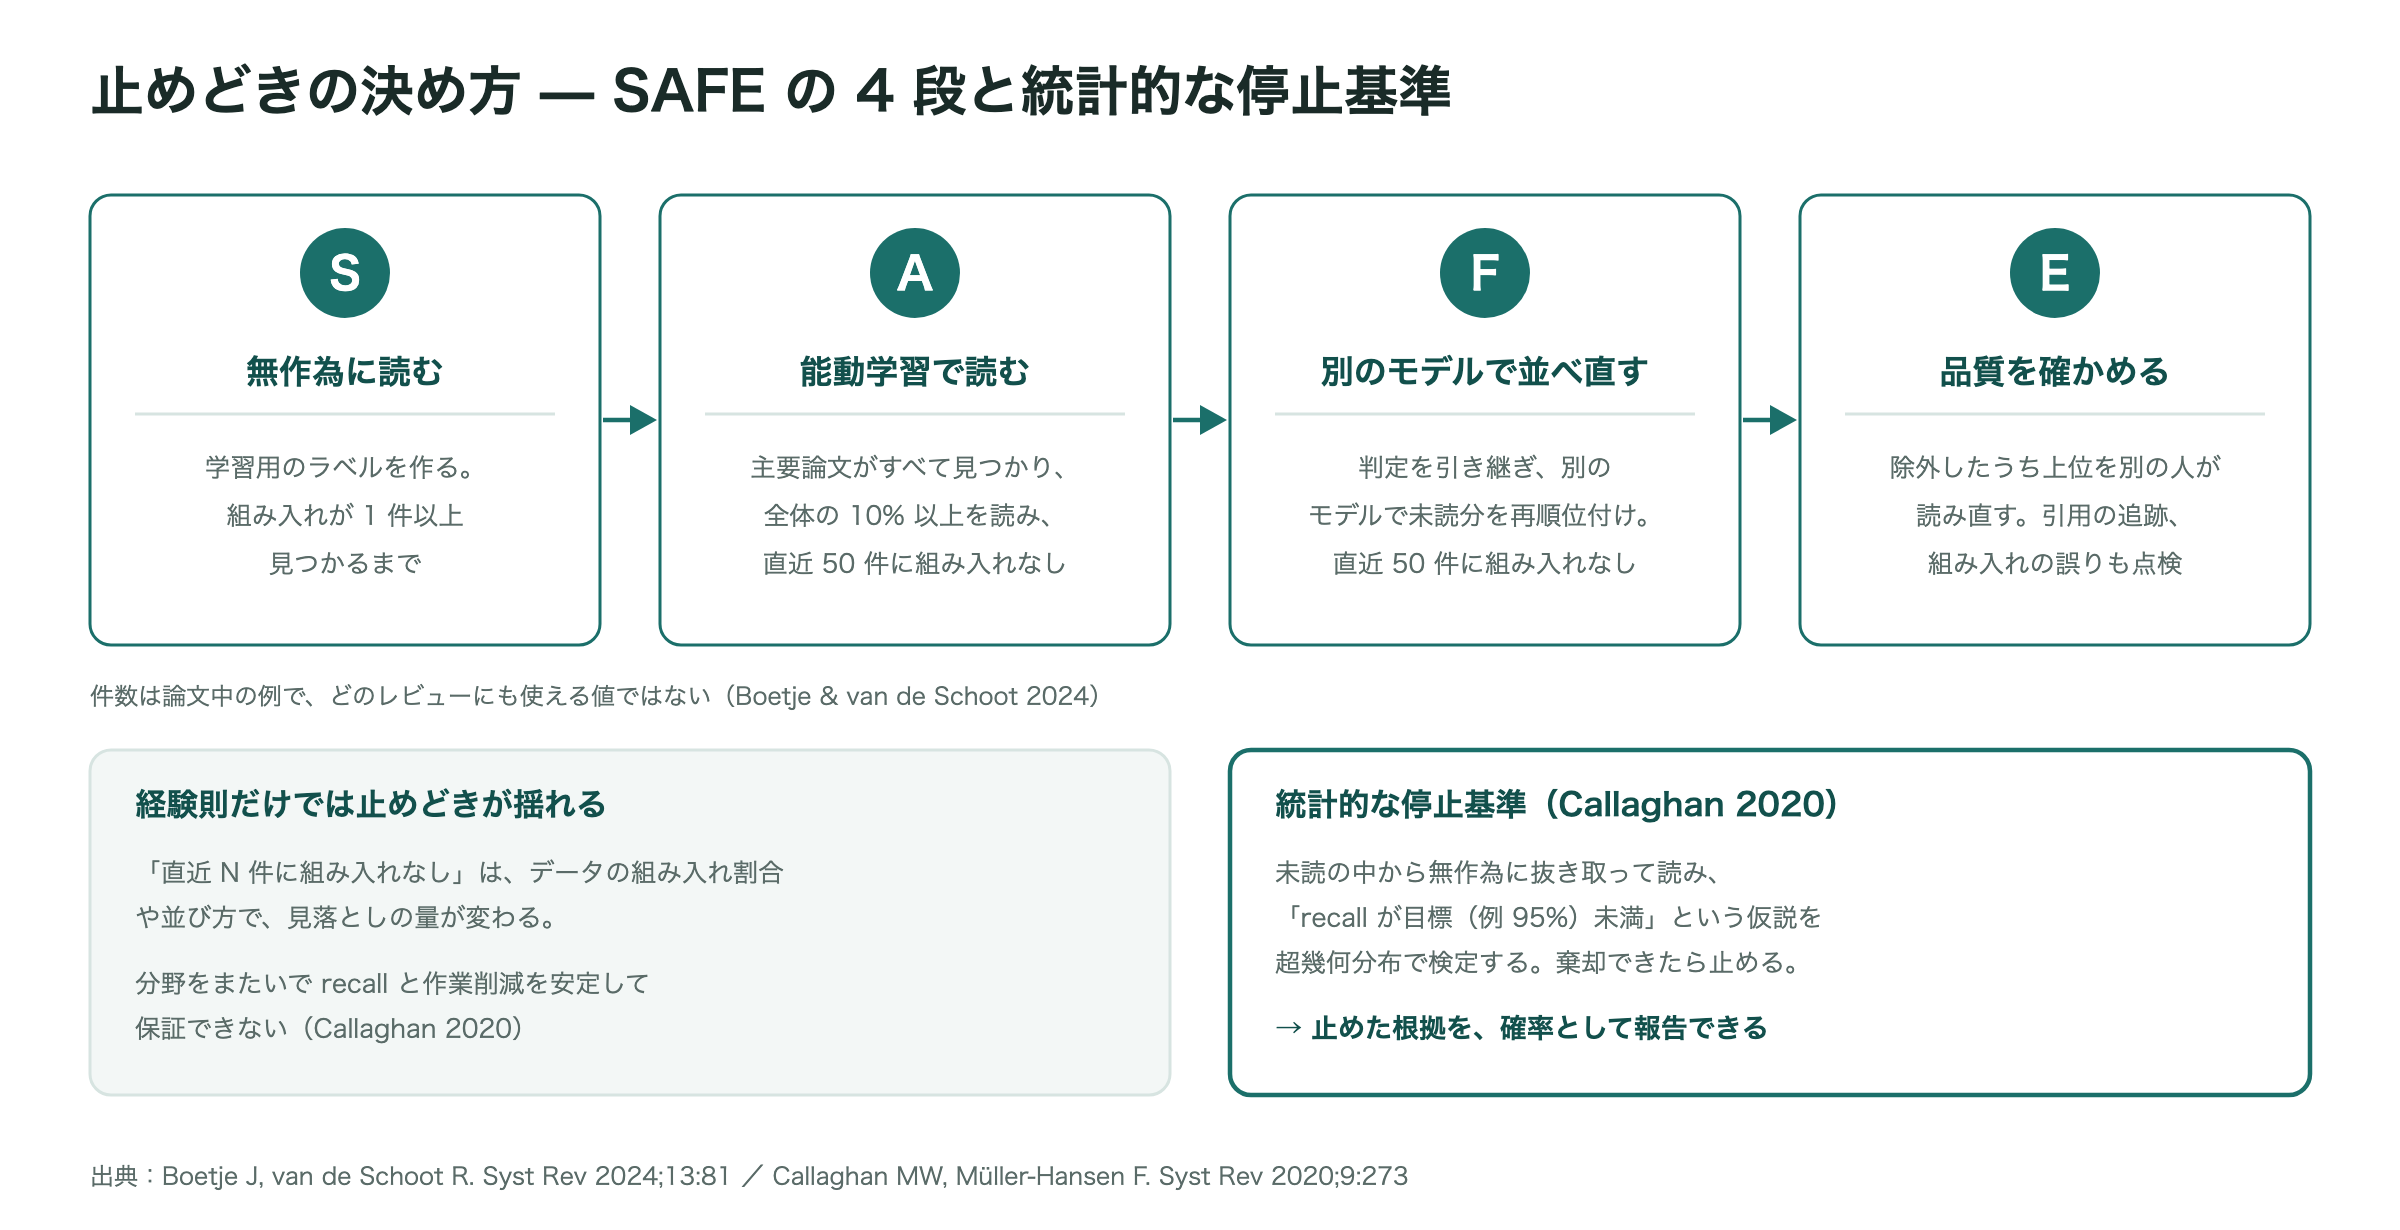
実務向けの手順として、SAFE(Boetje & van de Schoot 2024)があります。無作為に読んで学習用のラベルを作り(S)、能動学習で読み(A)、別のモデルで並べ直して取りこぼしを探し(F)、除外したものを別の人が点検する(E)という4段です。各段の「直近50件に組み入れなし」などの件数は例で、論文自身がどのレビューにも使える値ではないと断っています。
経験則の代わりに、統計的な停止基準もあります(Callaghan & Müller-Hansen 2020)。未読の中から無作為に抜き取って読み、「recall が目標未満」という仮説を検定して、棄却できたら止めます。止めた根拠を確率として報告できるのが利点です。
2-3. 特化分類器と事前学習モデル
判定の種類を絞った分類器は、すでに実務で使われています。Cochrane の RCT 分類器は、Cochrane Review に含まれる RCT 44,007件のうち、見落としが224件(0.5%)でした(Thomas 2021)。
同じ時期に、文書の表し方も変わりました。
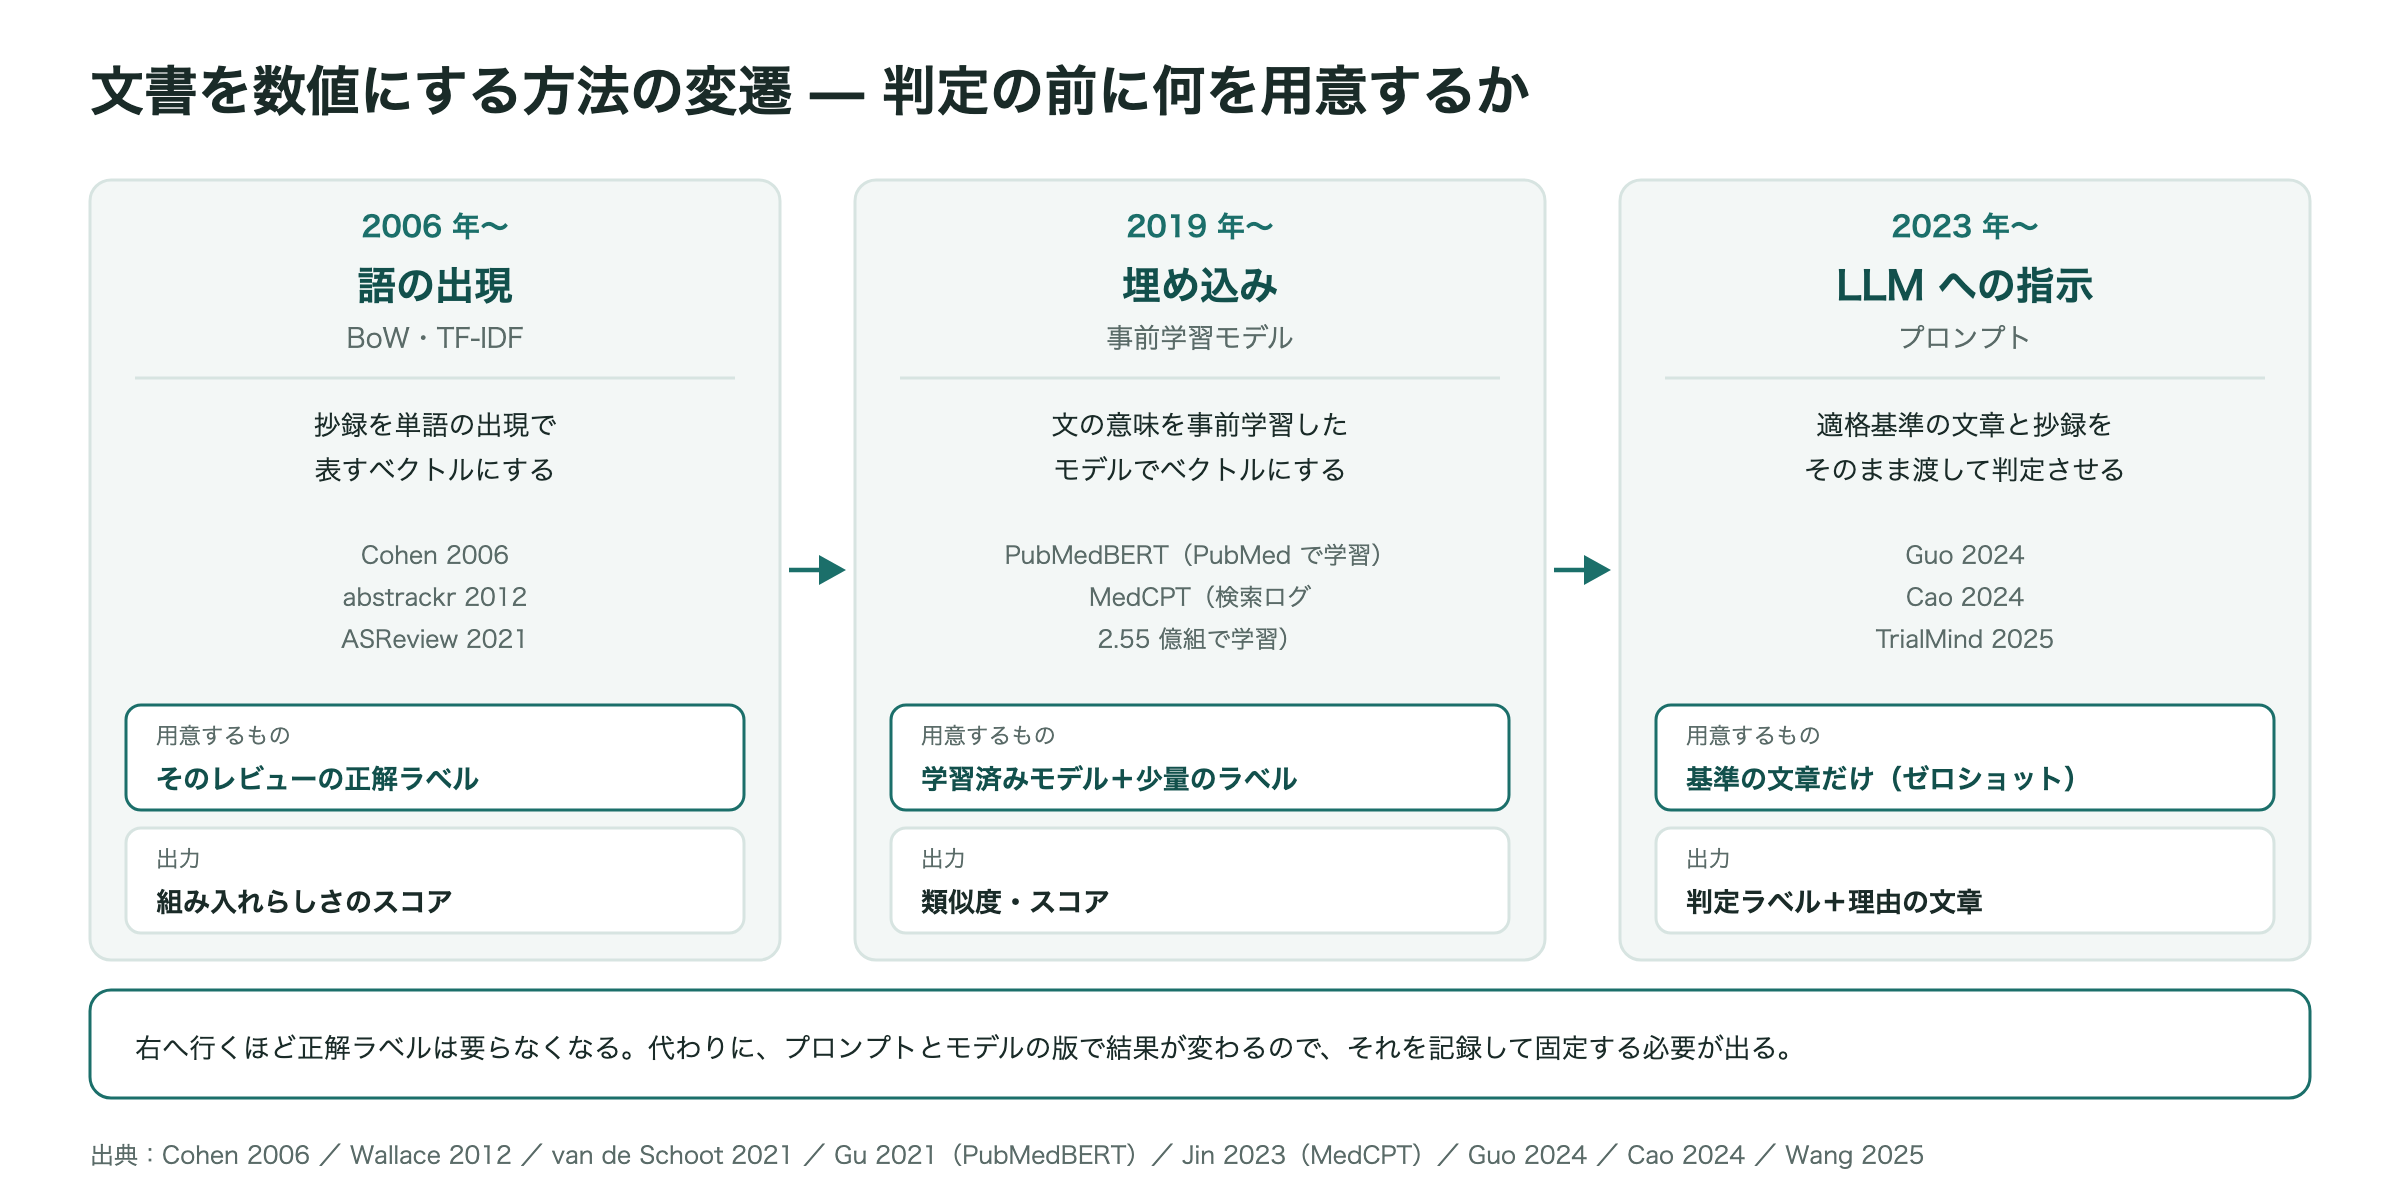
初期は抄録を単語の出現で表していました。次に、PubMedBERT(PubMed の抄録で事前学習)や MedCPT(PubMed の検索ログ2.55億組で学習)のような事前学習モデルの埋め込みが使われるようになります。問いと抄録の意味の近さを測れるので、ラベルが少なくても順位付けができます。TrialMind は、この MedCPT を比較対象にしています(2-5)。
2-4. LLM のゼロショット判定
LLM は適格基準を文章のまま読み、学習データなしで判定できます。出力にラベルだけでなく理由の文章を付けられるので、人が判定を確かめやすくなりました。ただし結果は研究によって大きく違います。
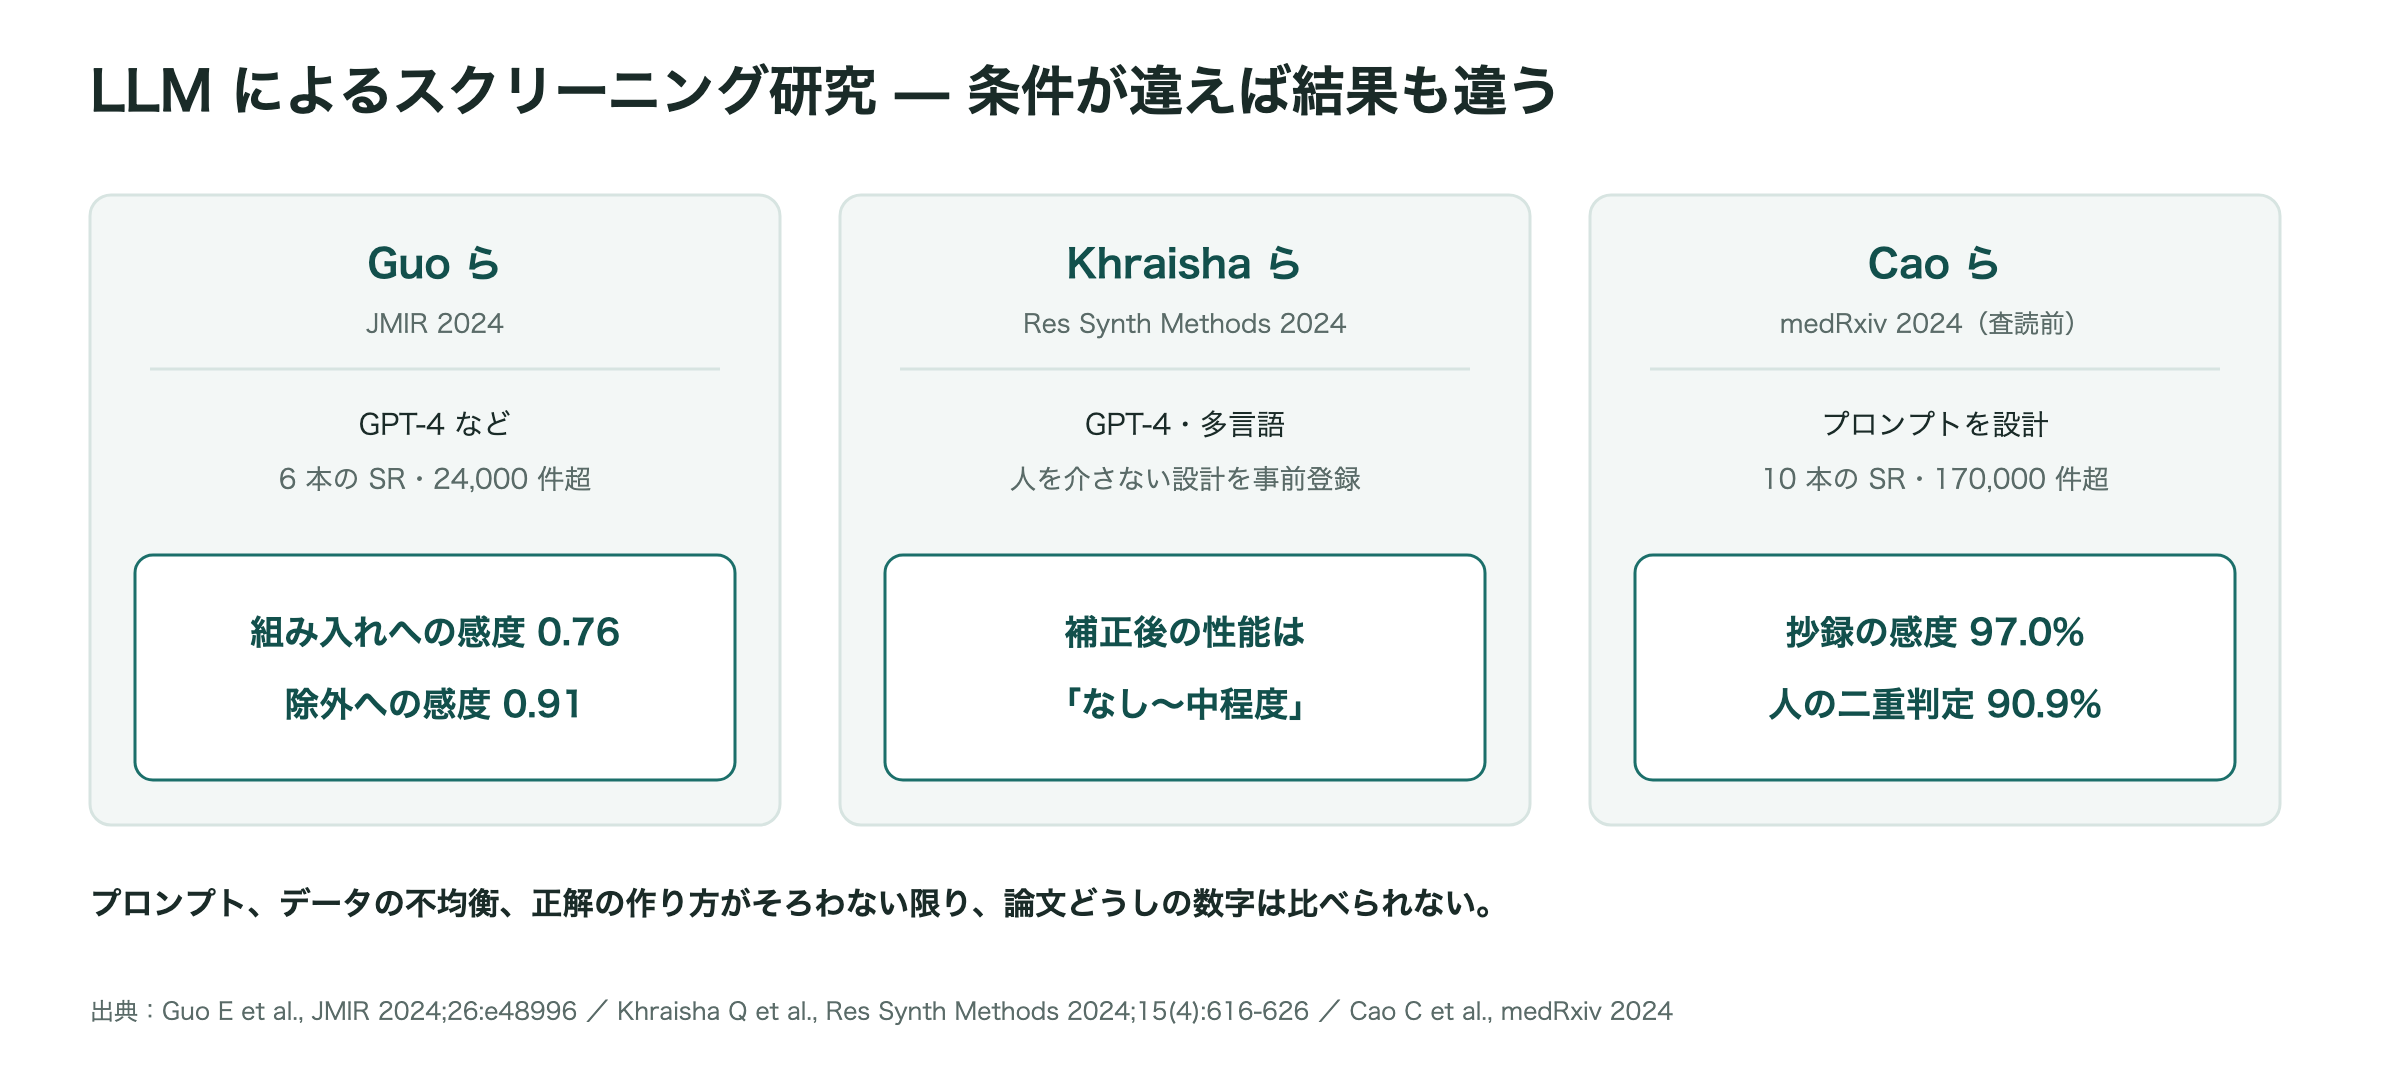
違いを生む主な要因は、プロンプト(基準をまとめて渡すか、1つずつ判定させるか、迷ったときにどちらへ倒すか)、データの不均衡、正解の作り方です。これがそろわない限り、他の論文の数字は並べて比べられません。
2-5. エージェント型
最新の流れは、判定を複数の段に分けて LLM に担わせる構成です。
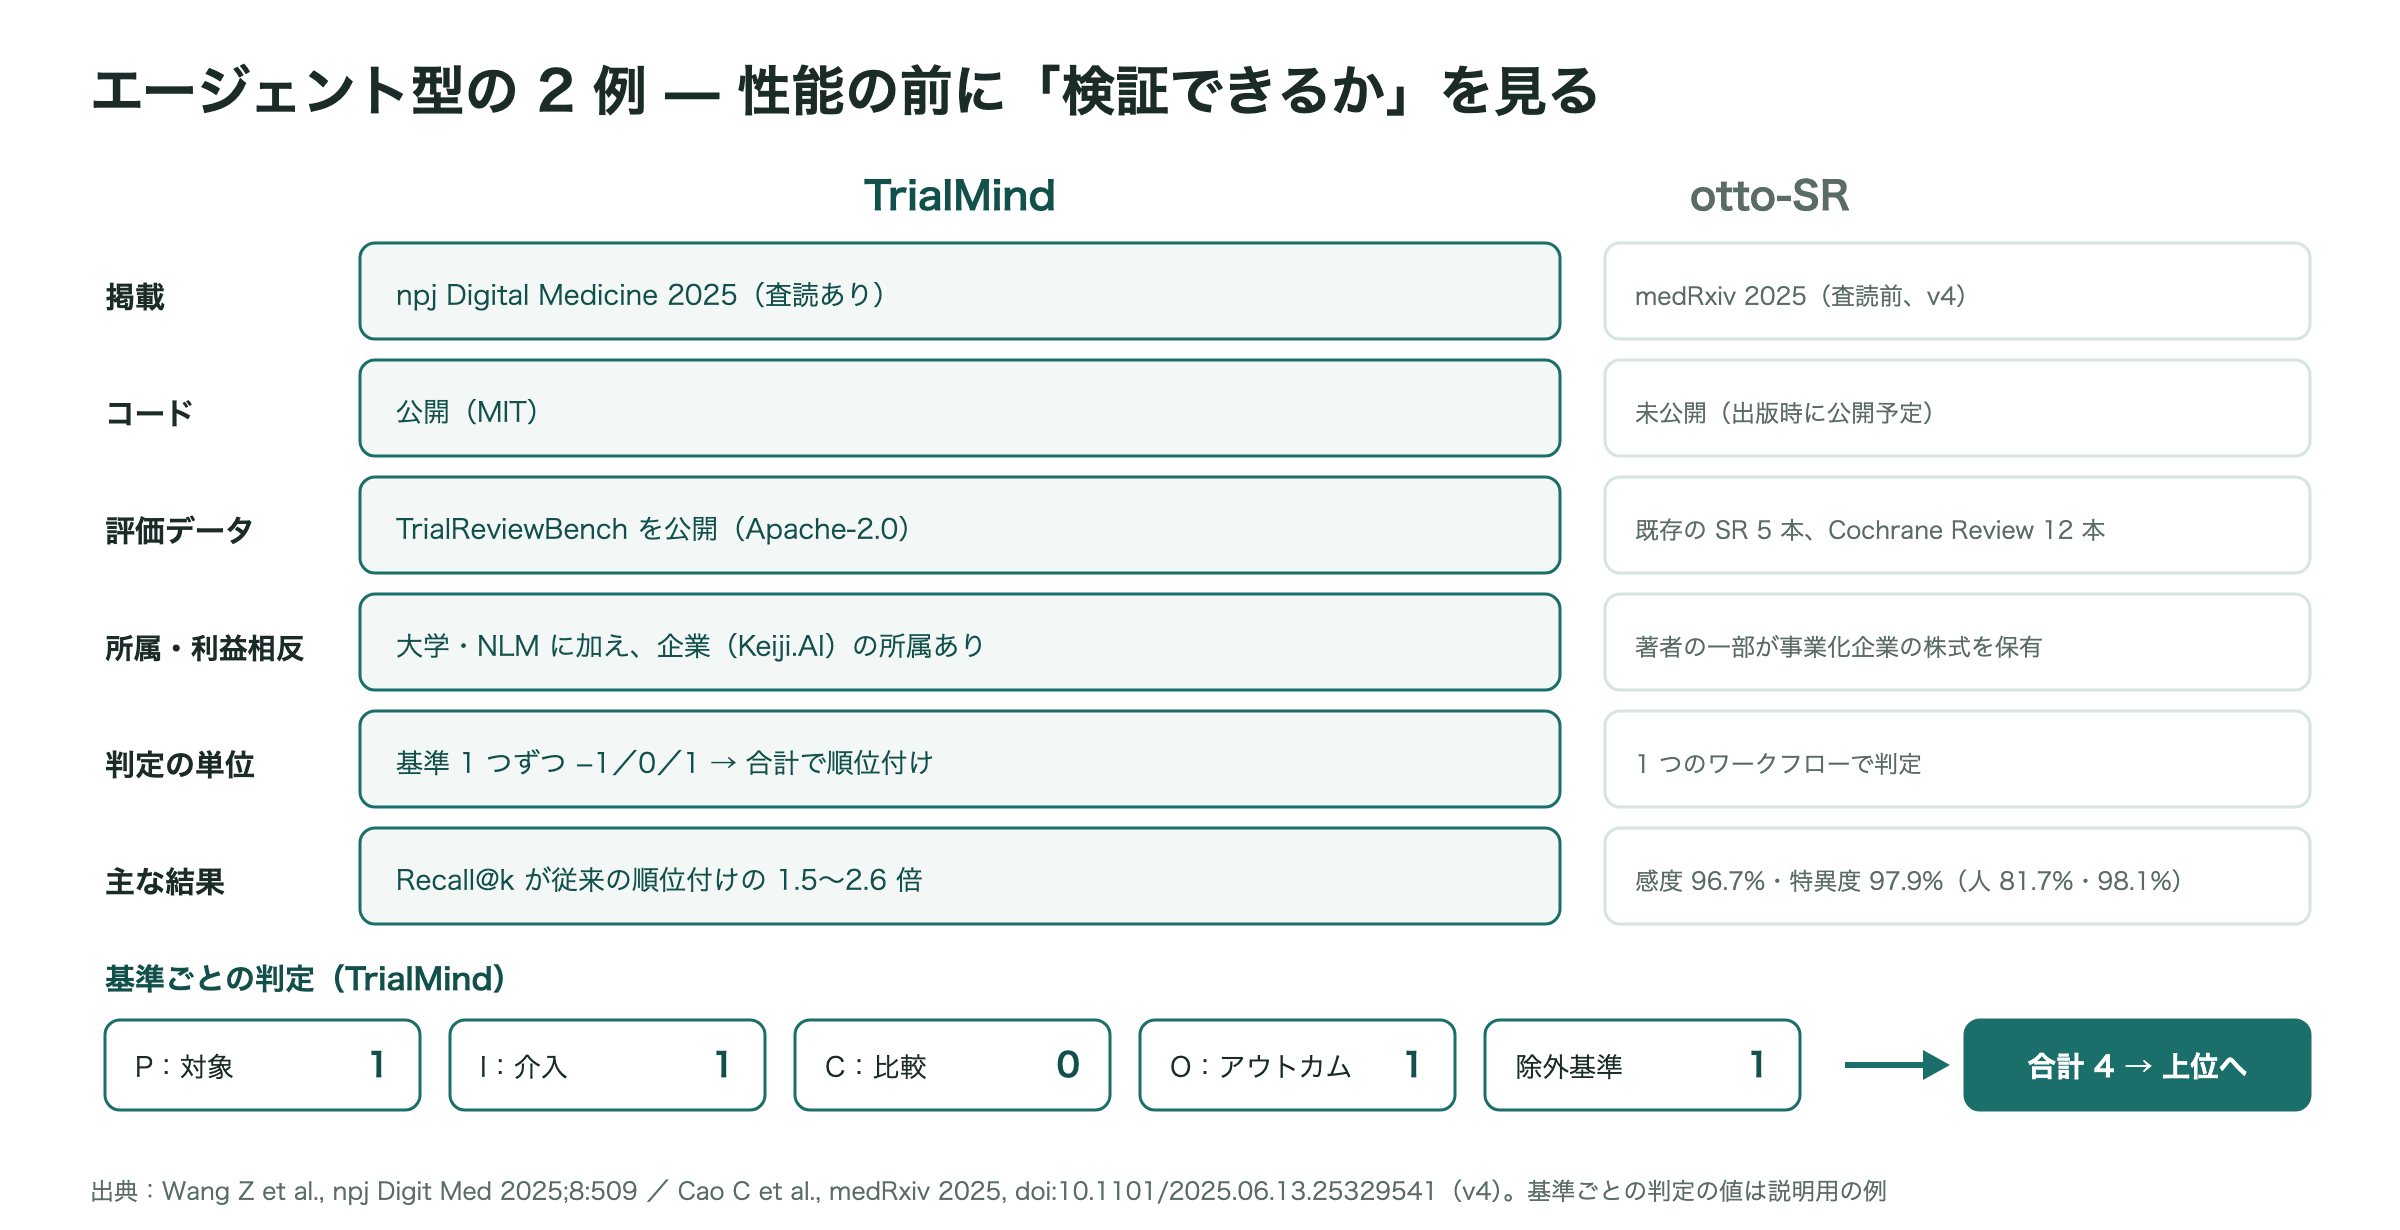
TrialMind は、PICO から LLM に適格基準を書き出させ、文献ごとに基準1つずつを −1(不適格)/0(不明)/1(適格)で判定させ、その合計で順位を付けます。評価には GPT-4 と Claude 3 Sonnet が使われ、順位付けの Recall@k は MPNet や MedCPT による順位付けの1.5〜2.6倍でした。人と組んだ試行では、スクリーニング時間が44.2%短くなっています。
otto-SR は、スクリーニングからデータ抽出までを1つのワークフローで行い、要旨で感度96.7%・特異度97.9%(人は81.7%・98.1%)と報告しています。この人の値は全文段階のもので、段階ごとの値は本文に別にあります。ただし査読前で、コードも公開されていません。
2つの違いは、性能の数字より検証できるかどうかにあります。論文を実装の土台に選ぶときは、査読の有無、コードとデータの公開、利益相反の3点を先に確認します。どちらの論文も著者に企業との関わりがあるので、利益相反は記載を読んで判断します。
3. 評価指標
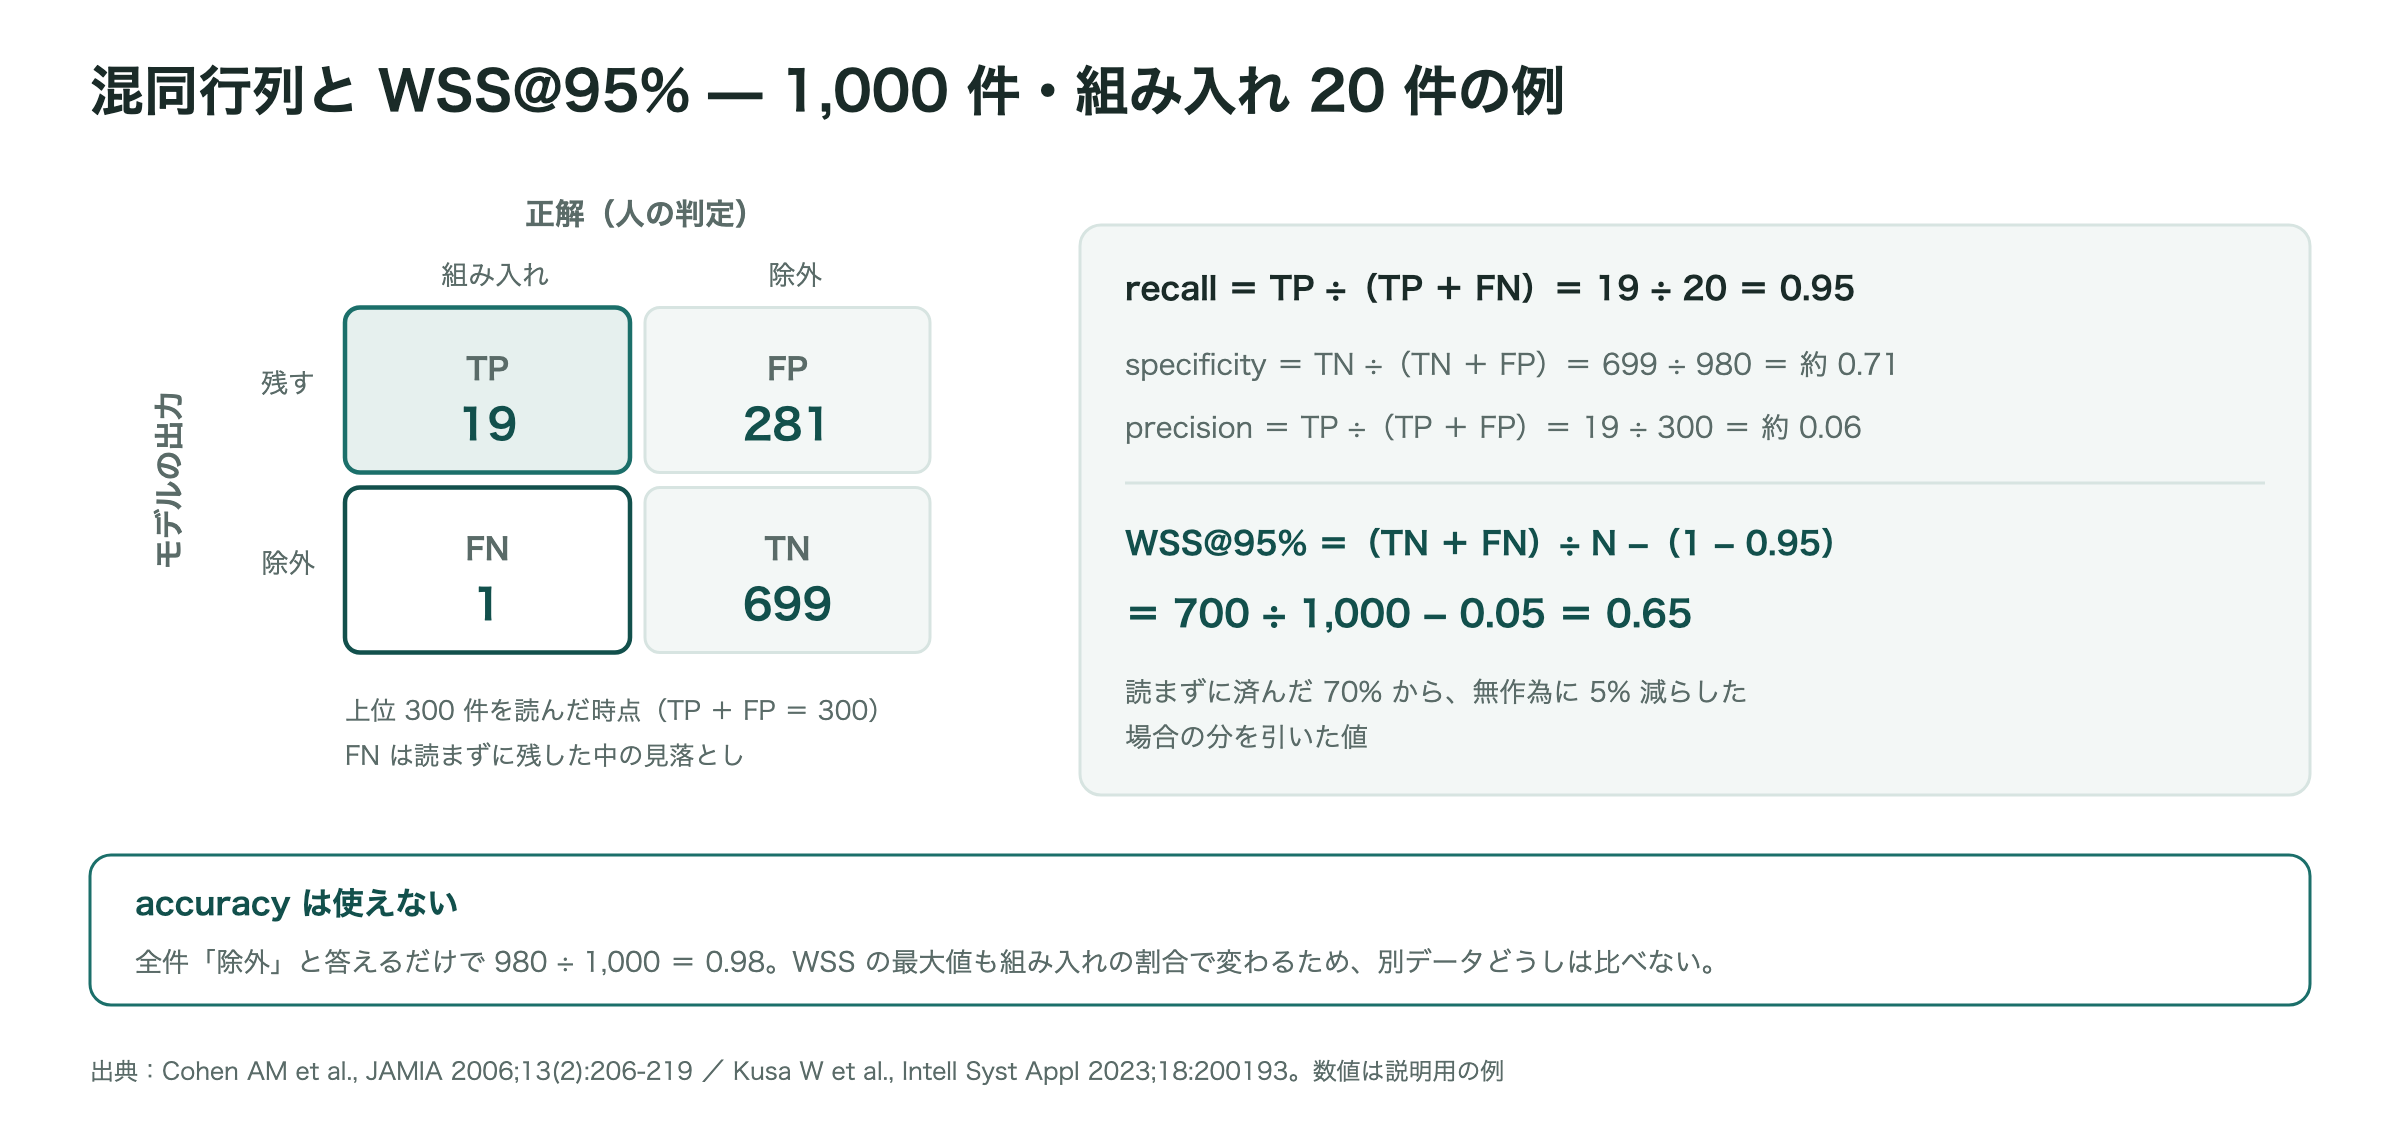
| 指標 | 何を測るか |
|---|---|
| recall(感度) | 組み入れるべき文献を残せた割合。最優先 |
| WSS@95% | recall 95% を保ったまま、人が読まずに済んだ割合(Cohen 2006) |
| Recall@k | 上位 k 件に入った組み入れの割合(TrialMind は主に k = 20、50) |
| kappa | 2人(または人とモデル)の判定の一致度。偶然の一致を差し引く(Cohen 1960) |
accuracy は使いません。組み入れが2%なら、全件「除外」と答えるだけで0.98になるからです。
WSS の最大値は、組み入れの割合で変わります(半々のデータで約0.45、組み入れ5%で約0.90。Kusa 2023)。別のデータセットの WSS どうしは比べません。
4. 評価データと数字の読み方
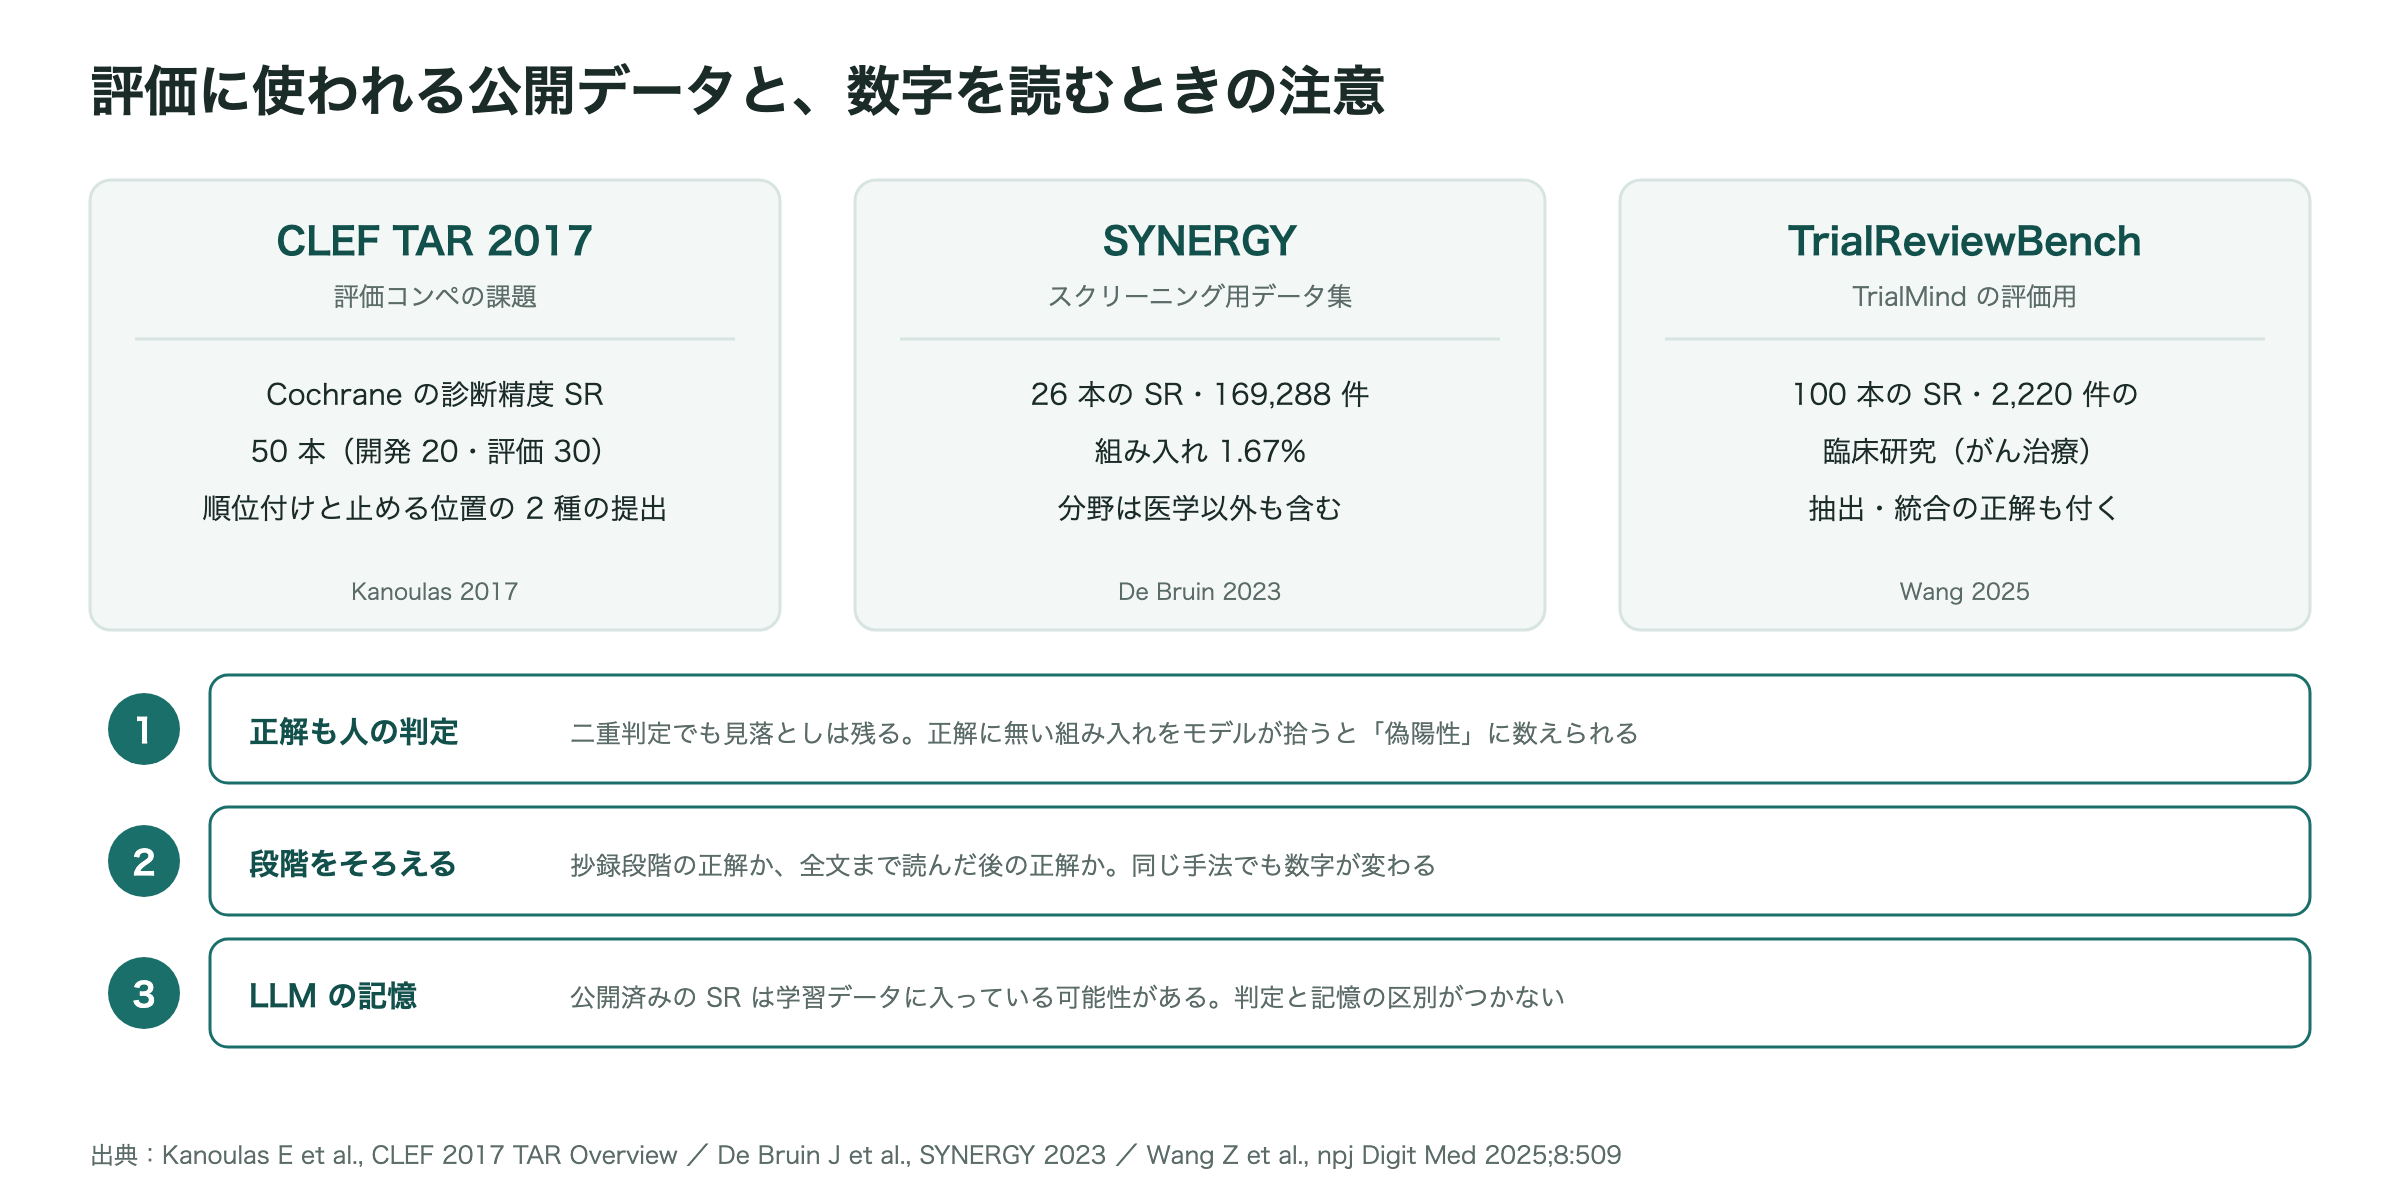
手法を比べるための公開データもそろってきました。CLEF の TAR 課題(2017〜2019)は、順位付けに加えて止める位置も競わせた点で、実務に近い設計です。
数字を読むときは、次の3点を確認します。
- 正解も人の判定 — 人の二重判定にも見落としはあります。モデルが正解に無い組み入れを拾うと、偽陽性として数えられます
- 段階 — 抄録段階の正解か、全文まで読んだ後の正解か。otto-SR も、抄録段階と全文段階で別々の値を報告しています
- LLM の記憶 — 公開済みの SR とその組み入れ文献は、LLM の学習データに入っている可能性があります。評価には、モデルの学習時期より後に出た SR を混ぜると安心です
5. 実務での位置づけ
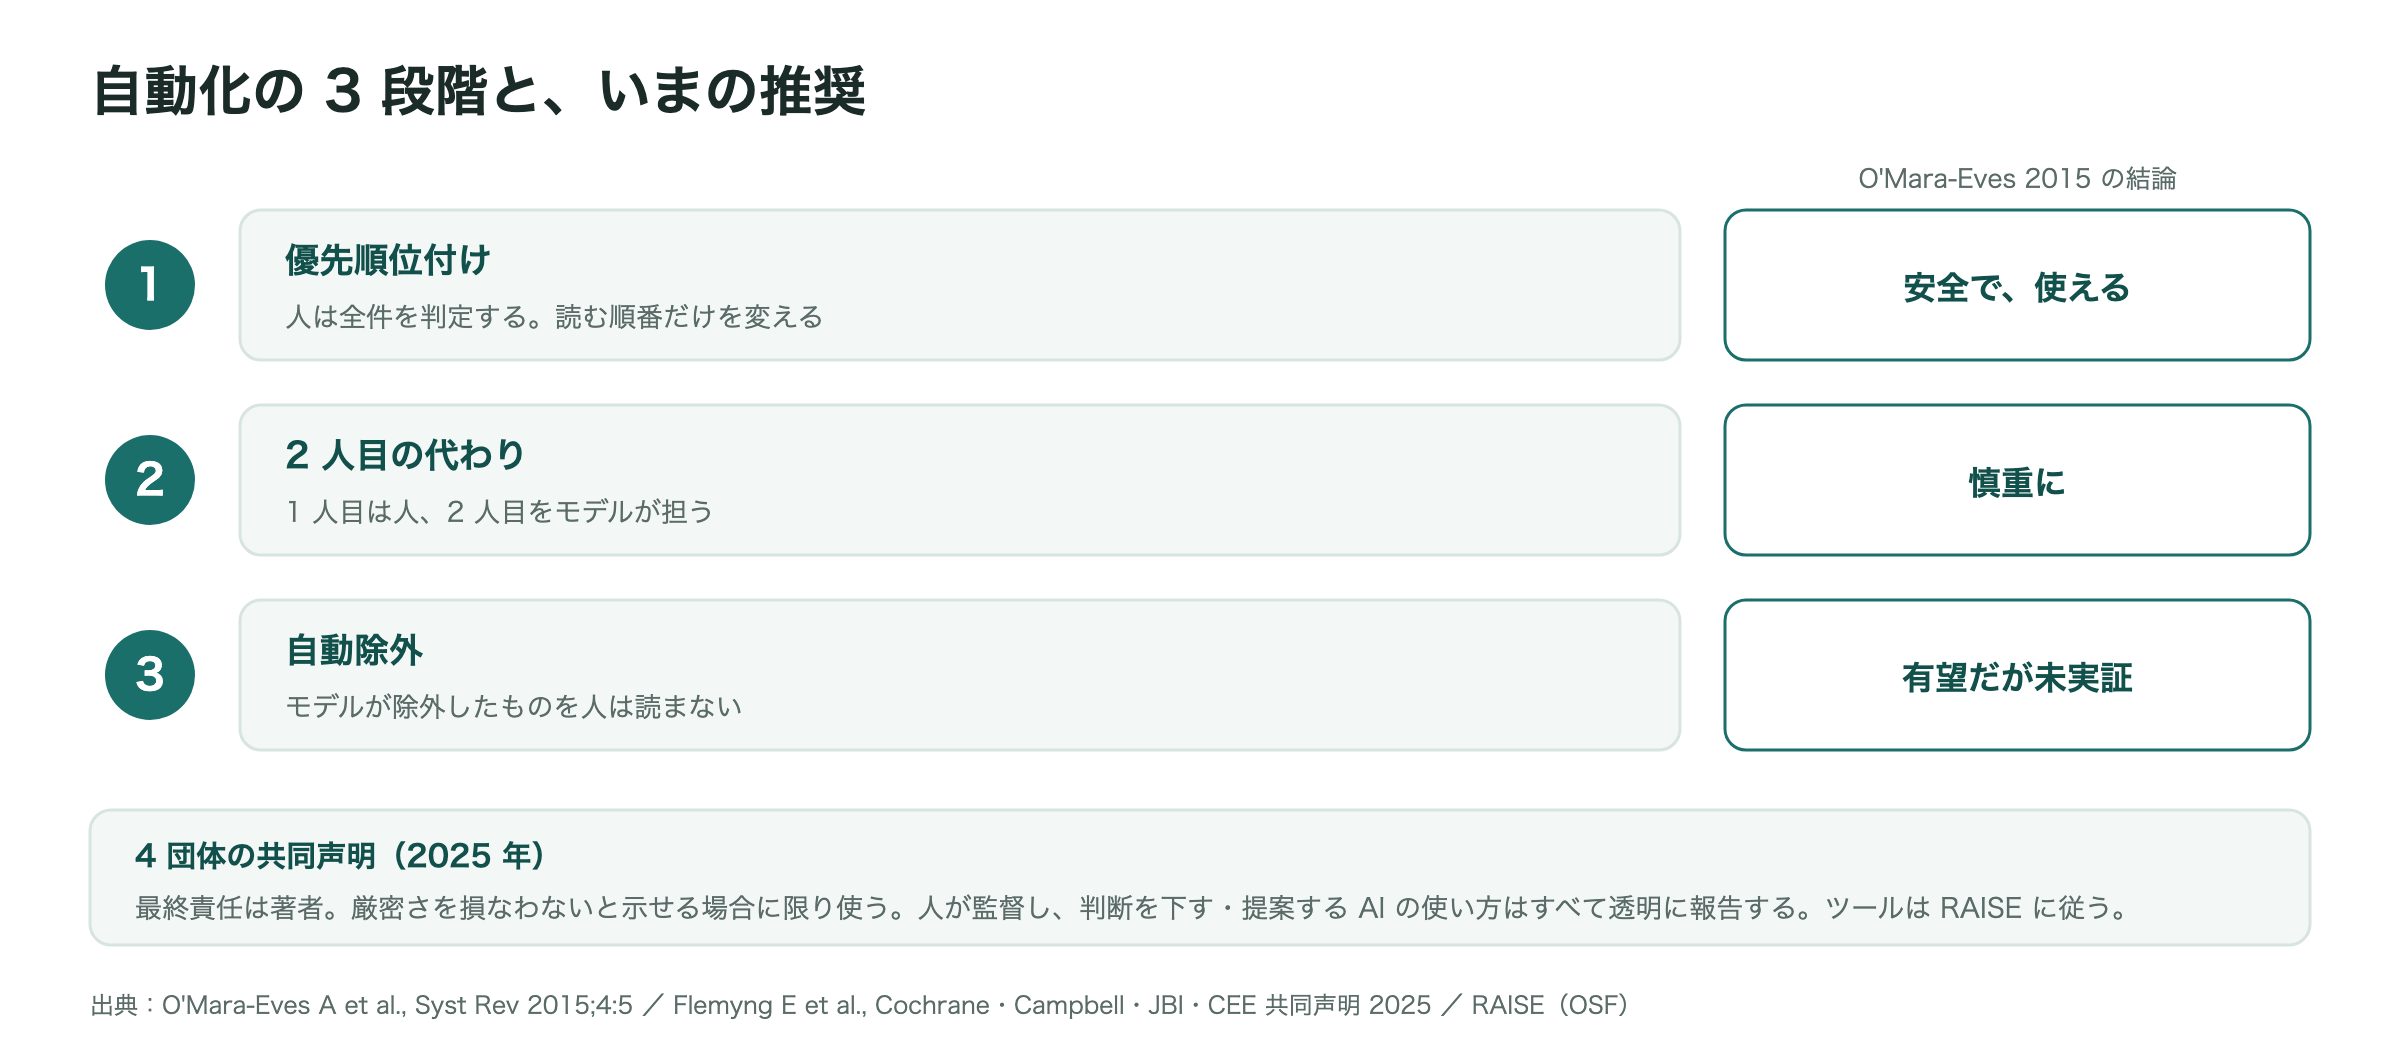
主なツールは、EPPI-Reviewer、Covidence、DistillerSR、Rayyan、Laser AI、Elicit などです。多くは優先順位付けと分類器を備え、LLM による判定や抽出を加えつつあります。各社の「作業時間○%削減」という数字は、査読を経たものではありません。
2025年には Cochrane・Campbell・JBI・CEE の4団体が共同声明を出し、最終責任は著者にあること、判断に関わる AI の使い方はすべて報告することを求めました。ツールの側は RAISE の指針に従います。
6. まとめ
- スクリーニングは不均衡な二値分類。見落としのコストが圧倒的に大きい
- 系譜は、教師あり分類 → 能動学習 → 特化分類器・事前学習モデル → LLM のゼロショット判定 → エージェント型。どれも「正解ラベルなしでどこまで判定できるか」への答え
- 順位付けでは止めどきが要。SAFE のような手順か、統計的な停止基準を使う
- 基本は recall。作業の削減は WSS@95%、順位付けは Recall@k で測る。accuracy は使わない
- 数字を読むときは、正解の作り方・段階・LLM の記憶を確認する
- 論文を選ぶときは、査読・コード公開・利益相反を先に見る
7. 次のステップ
連載本編では、2-5 で紹介した TrialMind の手法(検索・スクリーニング・データ抽出)を Claude Code で組み直し、3章の指標で原著の結果と比べます。
出典
- Cohen AM et al. Reducing workload in systematic review preparation using automated citation classification. JAMIA 2006;13(2):206-219
- Wallace BC et al. Semi-automated screening of biomedical citations for systematic reviews. BMC Bioinformatics 2010;11:55
- Wallace BC et al. Deploying an interactive machine learning system in an evidence-based practice center: abstrackr. ACM IHI 2012
- O'Mara-Eves A et al. Using text mining for study identification in systematic reviews. Syst Rev 2015;4:5
- Thomas J et al. Machine learning reduced workload with minimal risk of missing studies. J Clin Epidemiol 2021;133:140-151
- van de Schoot R et al. An open source machine learning framework for efficient and transparent systematic reviews. Nat Mach Intell 2021;3:125-133
- Callaghan MW, Müller-Hansen F. Statistical stopping criteria for automated screening in systematic reviews. Syst Rev 2020;9:273
- Boetje J, van de Schoot R. The SAFE procedure: a practical stopping heuristic for active learning-based screening in systematic reviews and meta-analyses. Syst Rev 2024;13:81
- Gu Y et al. Domain-specific language model pretraining for biomedical NLP. ACM Trans Comput Healthcare 2021
- Jin Q et al. MedCPT. Bioinformatics 2023;39(11):btad651
- Guo E et al. Automated paper screening for clinical reviews using large language models. J Med Internet Res 2024;26:e48996
- Khraisha Q et al. Can large language models replace humans in systematic reviews? Res Synth Methods 2024;15(4):616-626
- Cao C et al. Prompting is all you need: LLMs for systematic review screening. medRxiv 2024, doi:10.1101/2024.06.01.24308323
- Wang Z et al. Accelerating clinical evidence synthesis with large language models. npj Digit Med 2025;8:509
- Cao C et al. Automation of systematic reviews with large language models. medRxiv 2025, doi:10.1101/2025.06.13.25329541 (v4)
- Kanoulas E et al. CLEF 2017 Technologically Assisted Reviews in Empirical Medicine Overview. CEUR-WS Vol-1866, 2017
- Kusa W et al. An analysis of work saved over sampling in the evaluation of automated citation screening. Intell Syst Appl 2023;18:200193
- Cohen J. A coefficient of agreement for nominal scales. Educ Psychol Meas 1960;20(1):37-46
- De Bruin J et al. SYNERGY dataset. DataverseNL 2023, doi:10.34894/HE6NAQ
- Thomas J et al. RAISE: Responsible use of AI in evidence SynthEsis. OSF, doi:10.17605/OSF.IO/FWAUD
- Flemyng E et al. Position statement on AI use in evidence synthesis across Cochrane, the Campbell Collaboration, JBI and CEE. 2025