Claude Code × Medical Application
【業務説明】系統的文献レビュー — 手順と品質基準
1. 系統的文献レビューとは何か
系統的文献レビュー(systematic review、以下 SR)は、ある1つの問いについて、事前に決めた方法で関係する研究を漏れなく集め、1本ずつ質を評価し、結果をまとめる研究です(Cochrane Handbook v6.5, 1.1 節)。
ここで大事なのは、SR が「文献の紹介」ではなく 研究の一種 だということです。ふつうの研究が患者や検体を対象にするのに対して、SR は すでに発表された研究そのものを対象にする。だから SR にも、対象(どの研究を入れるか)があり、方法(どう探し、どう評価し、どうまとめるか)があり、それを事前に書いた計画書があります。
「系統的」とは何を指すのか
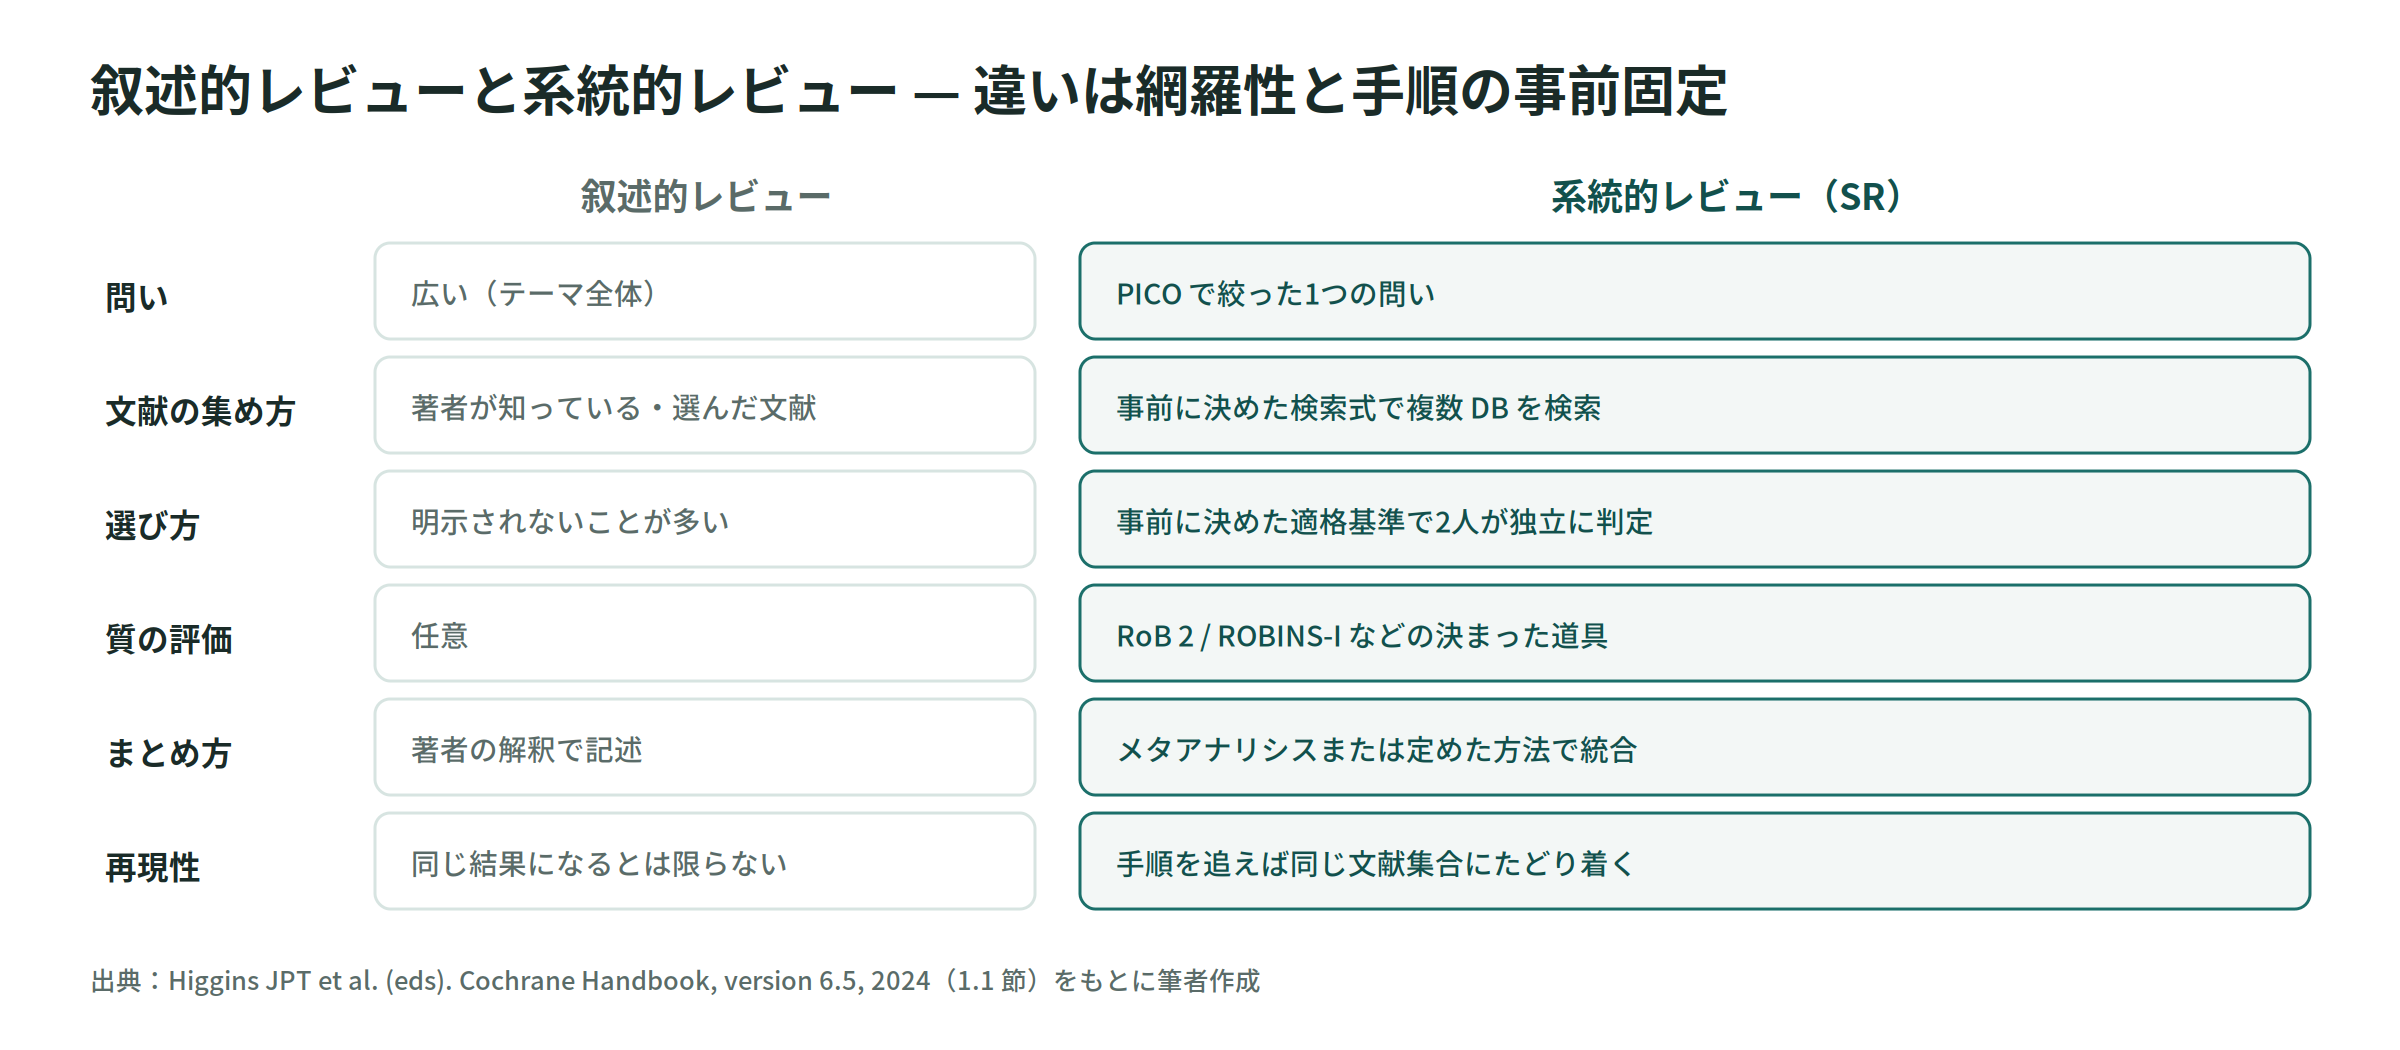
同じ「レビュー」でも、学会誌の総説などで見かける叙述的レビュー(ナラティブレビュー)とは作りが違います。叙述的レビューは、その分野に詳しい著者が、自分の知っている文献を選んで解説します。読み物としては優れていても、なぜその文献が選ばれ、別の文献が選ばれなかったのかは読者にはわかりません。著者が変われば結論も変わりえます。
SR が「系統的(systematic)」と呼ばれるのは、次の3つを満たすからです。
- 手順を先に決めて、先に公開する — 何を組み入れ、何を除外するかを、文献を読む前に文書にする
- 網羅的に探す — 特定の雑誌やデータベースに偏らず、決めた検索式で機械的に集める
- 過程を全部残す — 何件見つけ、何件除き、なぜ除いたかを件数と理由で残す
この3つがあると、別の人が同じ手順をなぞったとき、ほぼ同じ文献集合にたどり着くようになります。結論の説得力は、著者が誰かではなく、この再現性から来ています。
メタアナリシスとの関係
よく混同されますが、SR は手順の名前、メタアナリシスはその中で使うことがある統計解析の名前です。集めた研究の結果を数値として統合し、1つの推定値(と信頼区間)にまとめる計算がメタアナリシスにあたります。
SR をやってもメタアナリシスをしない(できない)ことは珍しくありません。研究ごとに対象者も介入も測り方も違いすぎて、数字を足し合わせると意味のない平均になってしまう場合です。このときは統合を言葉で行い、定性的 SR と呼びます。逆に、メタアナリシスだけを他人の SR の上でやっても SR にはなりません。集め方が保証されていないからです。
2. エビデンスの階層での位置
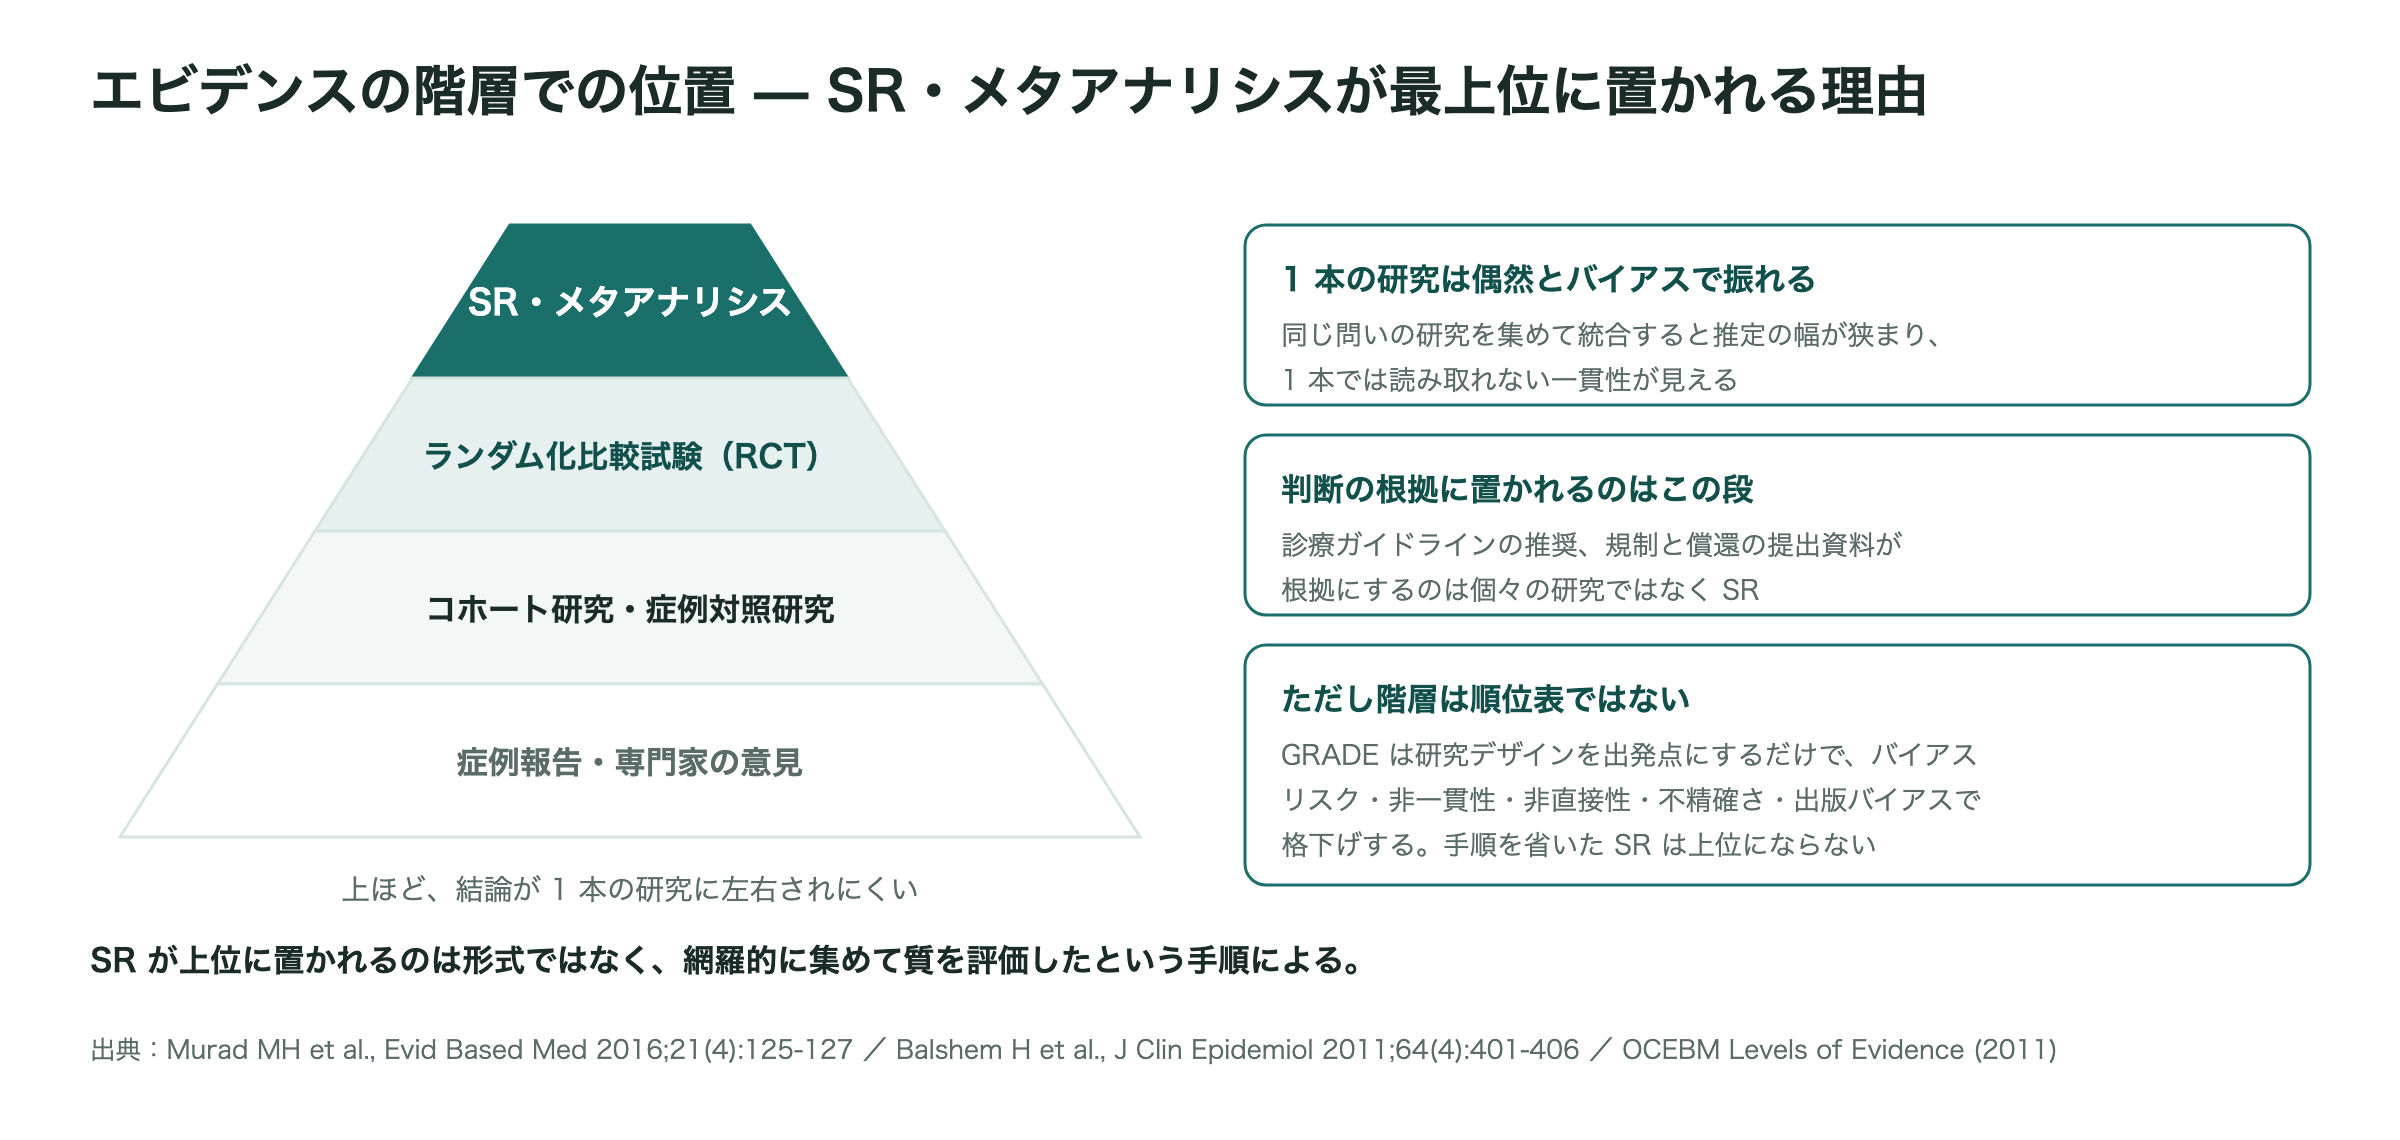
医学のエビデンスは、研究デザインごとに階層(エビデンスレベル)で語られます。下から、専門家の意見・症例報告、症例対照研究やコホート研究などの観察研究、ランダム化比較試験(RCT)、そして一番上に SR・メタアナリシス が置かれます。
上に置かれる理由は単純です。1本の研究の結果は必ず振れるからです。振れの原因は2つあって、ひとつは偶然(たまたまその被験者集団でそう出た)、もうひとつはその研究固有のバイアス(割付の仕方、測り方、脱落の扱い)です。同じ問いを扱った研究を集めて統合すると、偶然による振れは打ち消し合って推定の幅が狭まり、1本では読み取れない一貫性(あるいは不一致)が見えます。
診療ガイドラインの推奨も、規制当局や保険償還の提出資料も、個々の論文ではなく SR を根拠に置くのはこのためです。
ただし、階層の上にあること自体が質を保証するわけではありません。GRADE(後述)は研究デザインを出発点の格付けに使うだけで、バイアスリスク・非一貫性・非直接性・不精確さ・出版バイアスがあれば格下げします。手順を省いた SR は上位になりません。 ピラミッドは「SR と名乗れば勝ち」という順位表ではなく、「網羅的に集めて質を評価した」という手順に対する評価だと考えてください。
3. なぜ必要になったのか
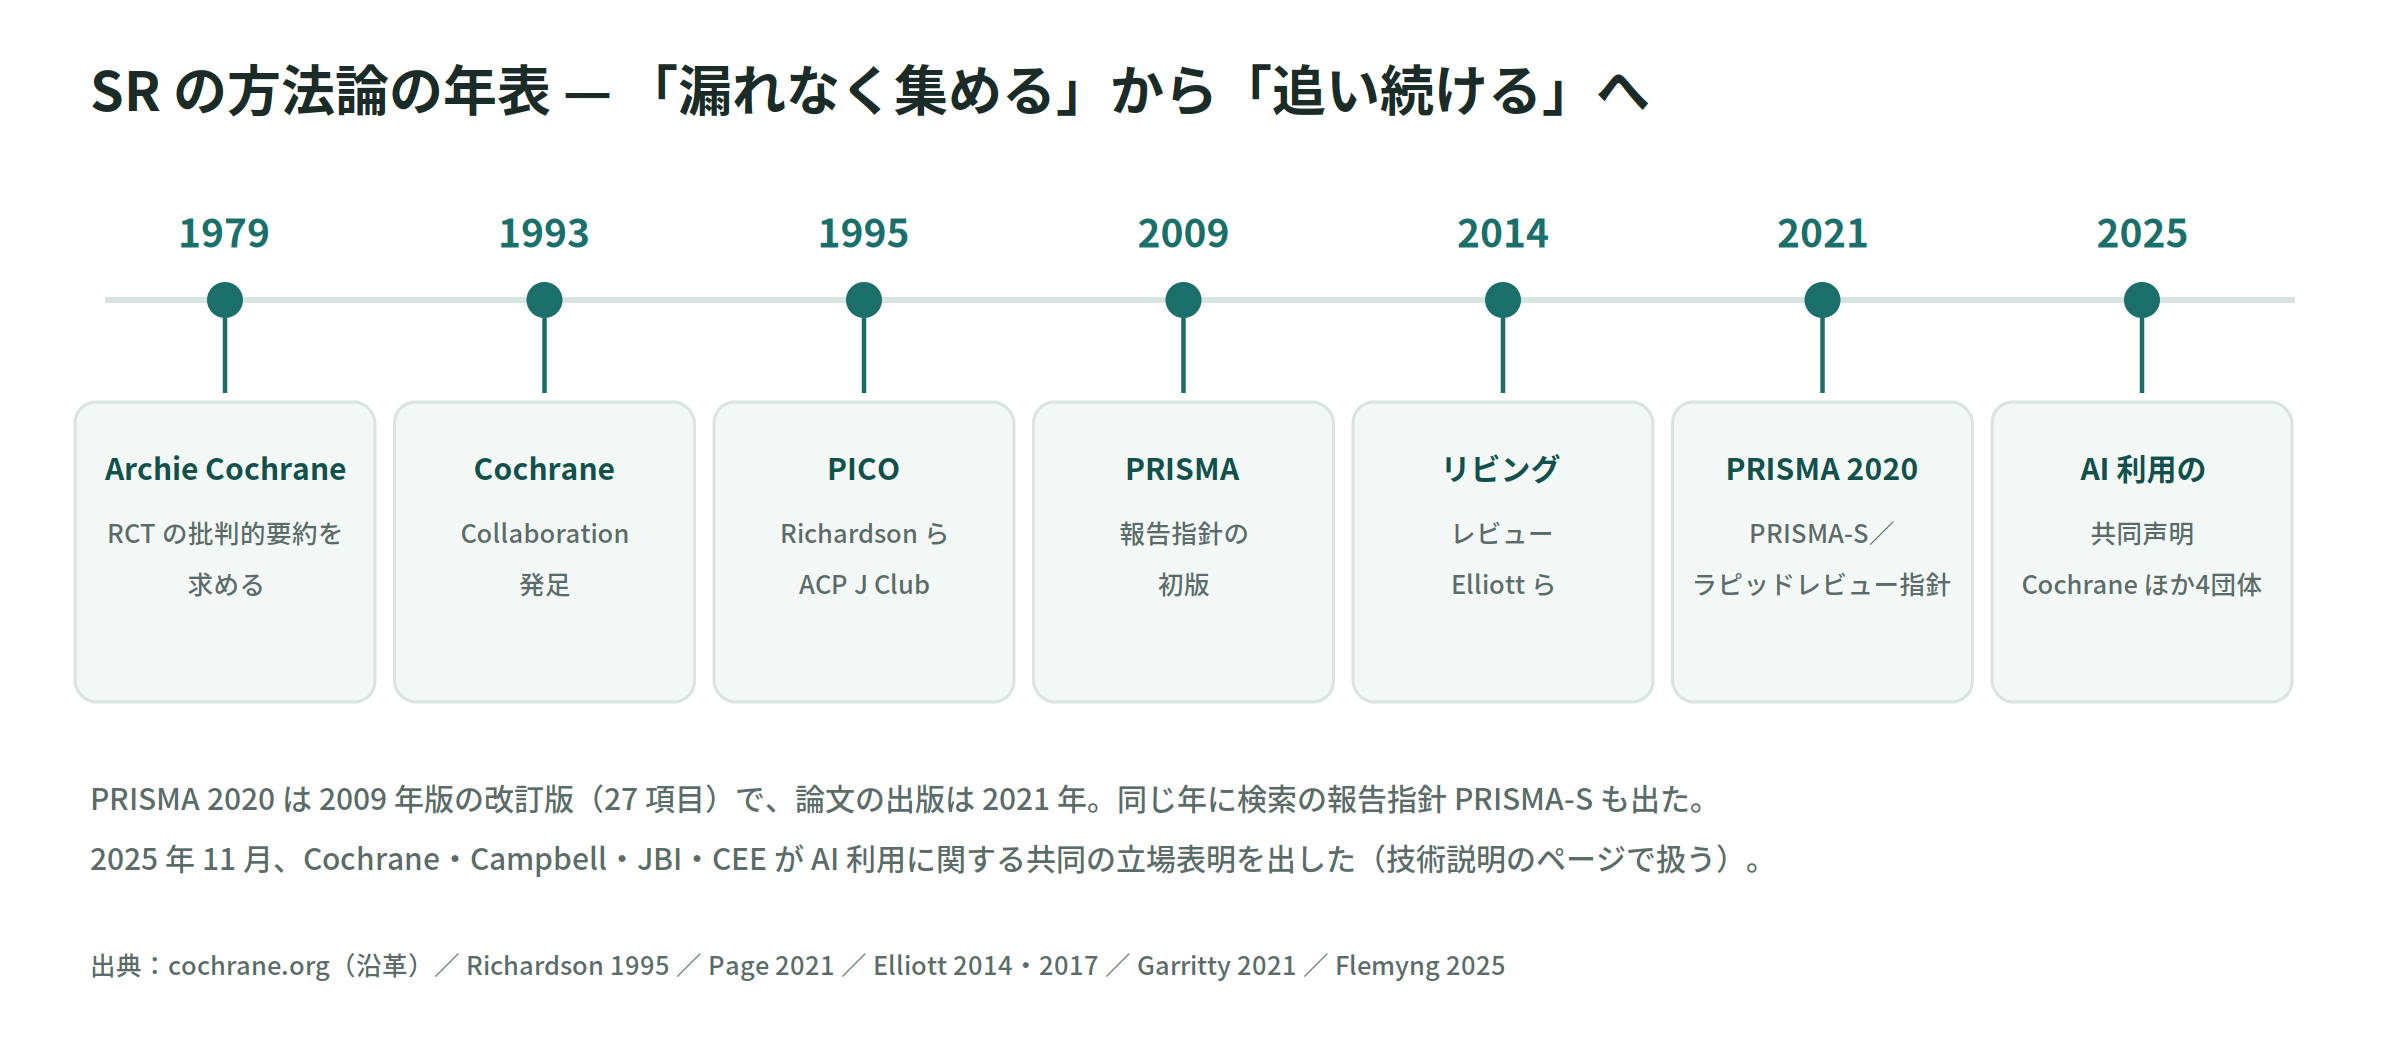
SR が方法として整備されたのは、一次研究の量が人の読める限界を超えたからです。PubMed の収載は4,000万件を超え、いまも毎日増え続けています。臨床医が自分の専門領域の論文を全部読んで判断する、ということが物理的に成り立たなくなりました。
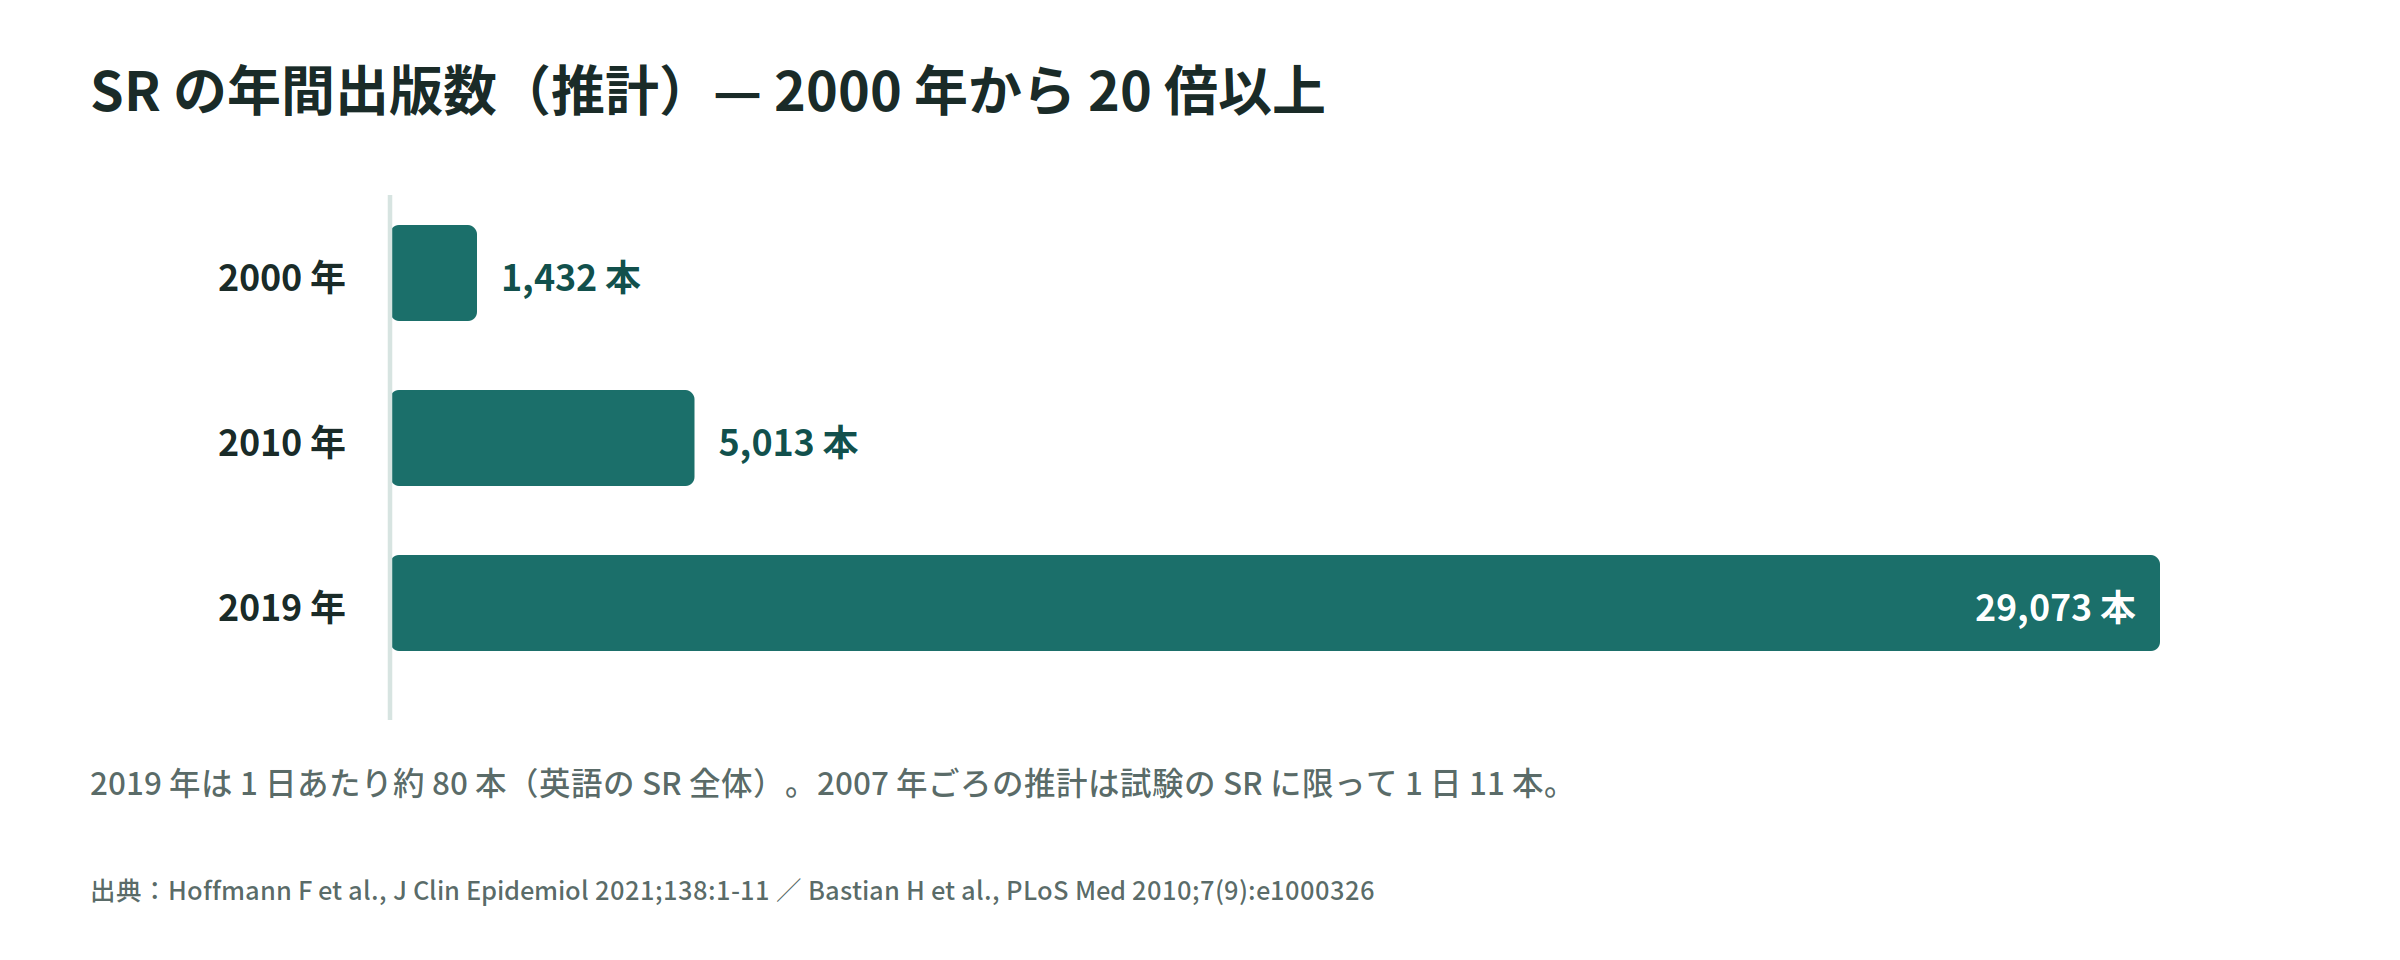
皮肉なことに、SR そのものも増えています。2019年には年に約3万本、1日あたり約80本の SR が出ている計算です。2000年の約1,400本から20倍以上になりました。
4. 6つの工程
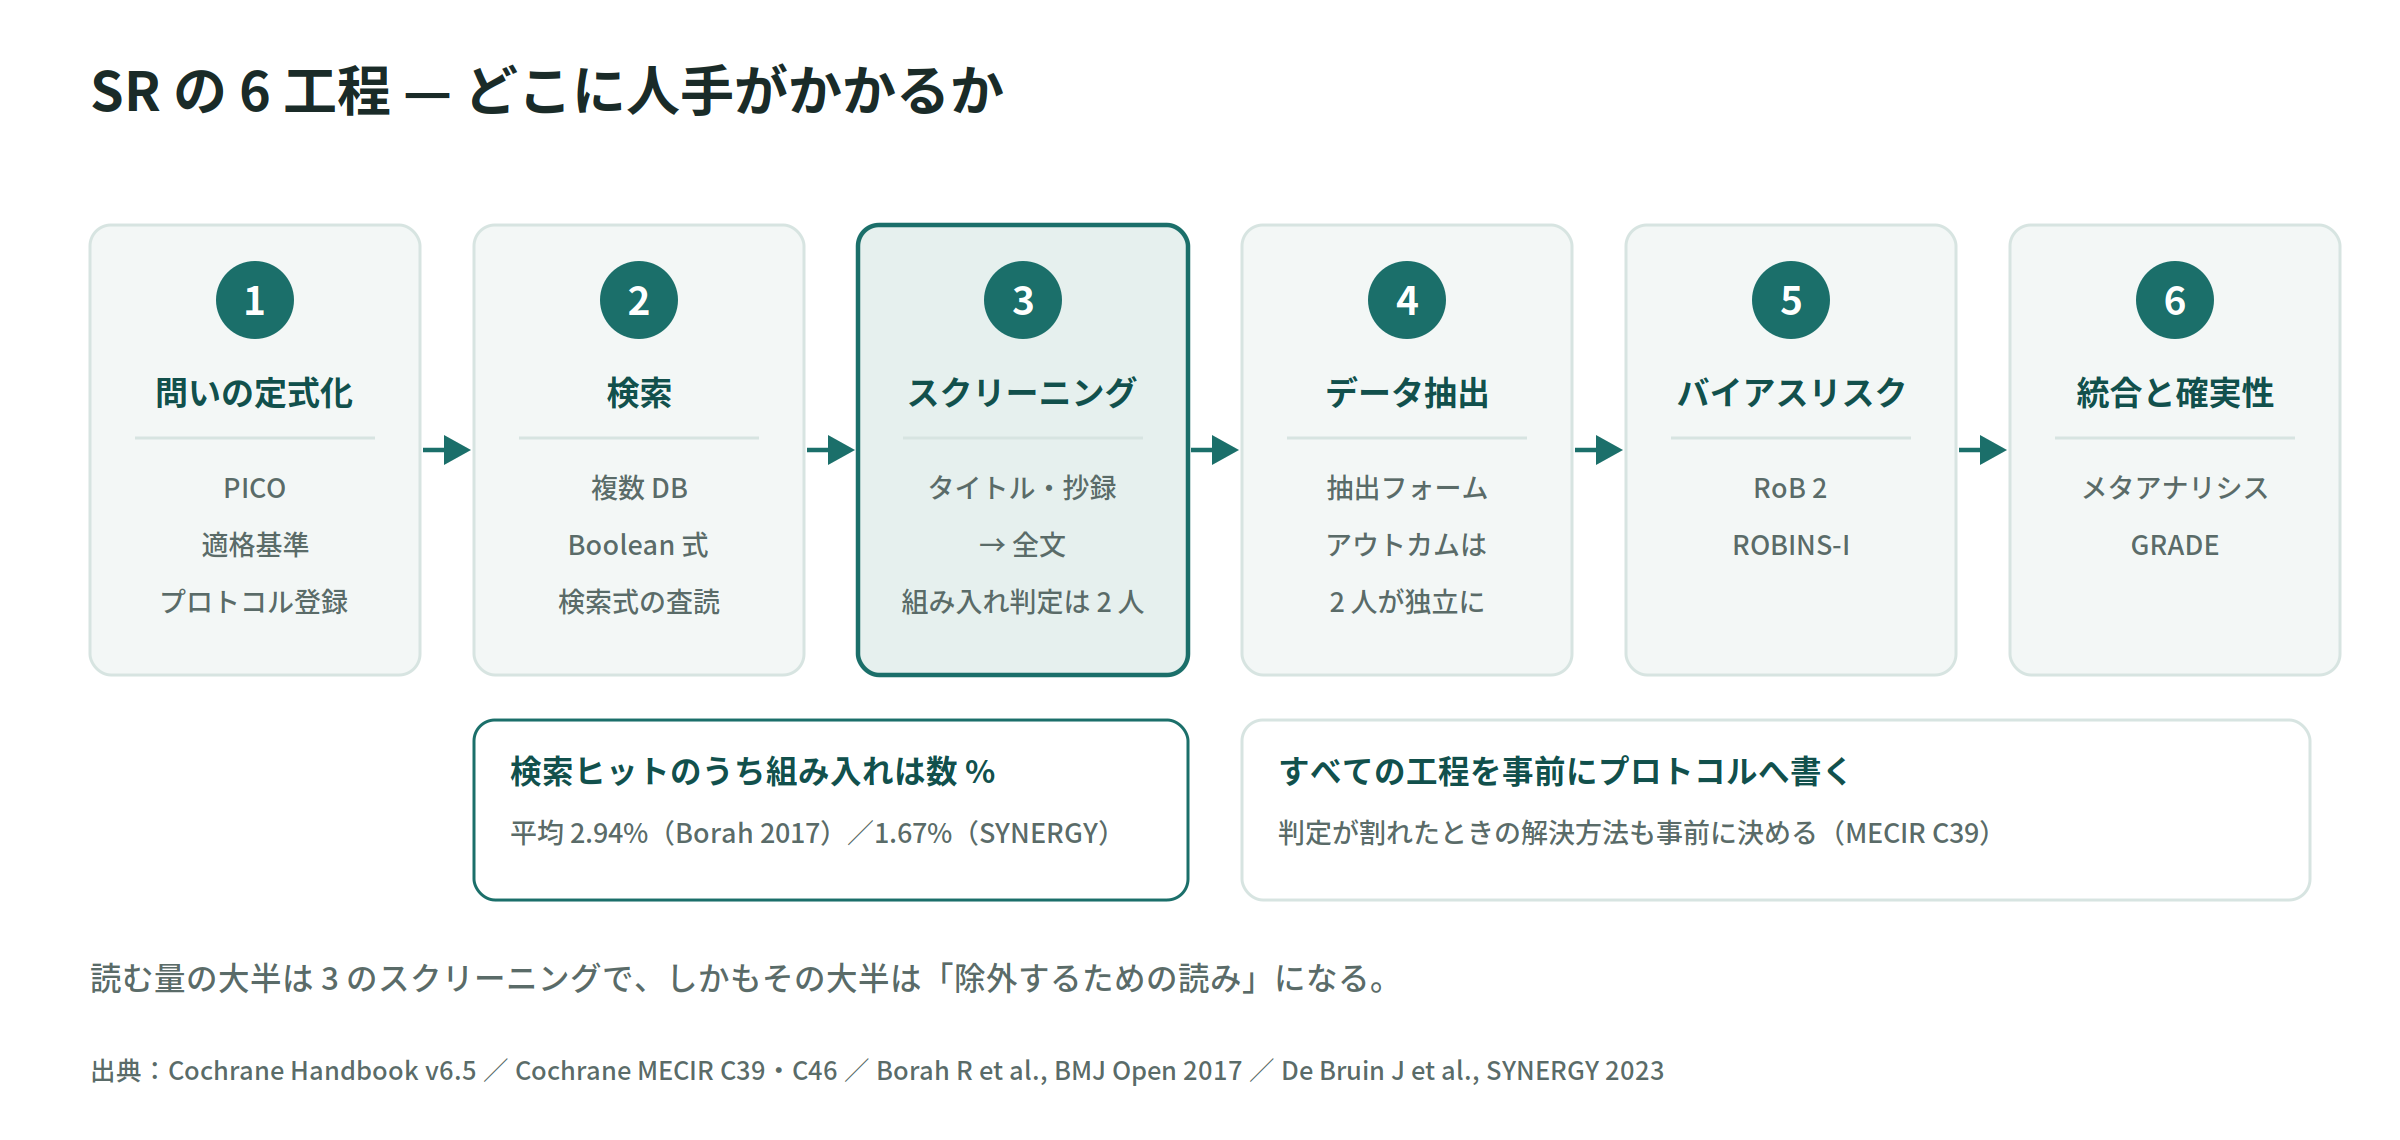
| 工程 | 何をするか | 成果物 |
|---|---|---|
| 1. 問いの定式化 | PICO で問いを書き、適格基準を決め、プロトコルに書いて登録する | プロトコル(PROSPERO 登録番号) |
| 2. 検索 | 複数のデータベースを検索式で検索し、重複を除く | 検索式・検索日・ヒット件数 |
| 3. スクリーニング | タイトル・抄録 → 全文の2段階で絞り込む | 組み入れ文献の一覧と除外理由 |
| 4. データ抽出 | 各論文から決めた項目を抜き出す | 抽出フォーム(研究特性表) |
| 5. バイアスリスク評価 | 結果が系統的にずれるおそれを領域ごとに判定する | 評価シート |
| 6. 統合と確実性 | 定性的にまとめ、可能ならメタアナリシス、GRADE で格付け | フォレストプロット・SoF 表 |
以下、ひとつずつ手続きのレベルで見ていきます。
4.1 問いの定式化 — PICO・適格基準・プロトコル
最初にやるのは、答えられる形に問いを削ることです。「この薬は効くのか」では広すぎて、どの研究を入れるべきか決まりません。そこで PICO という4つの枠に分けて書きます。
| 記号 | 読み | 中身 | 例 |
|---|---|---|---|
| P | Patient / Population | 誰を対象にするか | 2型糖尿病の成人 |
| I | Intervention | 何をするか | SGLT2 阻害薬 |
| C | Comparison | 何と比べるか | プラセボまたは他の経口血糖降下薬 |
| O | Outcome | 何を測るか | 心血管死、重症低血糖、HbA1c |
PICO が決まったら、そこから 適格基準(組み入れ基準・除外基準) に落とします。PICO の4つに加えて、研究デザイン(RCT だけか、観察研究も入れるか)、発表年の範囲、言語、追跡期間の下限、サンプルサイズの下限 などを決めます。ここが曖昧だと、後のスクリーニングで判定が人によって割れます。
決めた内容は プロトコル(SR の計画書)に書きます。書式は PRISMA-P というチェックリストがあり、健康関連の SR は PROSPERO という国際的な登録簿に登録できます。登録は義務ではありませんが、多くの雑誌が事実上求めています。
なぜ検索の前に固定するのか。理由は、文献を読んでから基準を決めると、結果を見てから都合のよい研究を選べてしまうからです。「この研究は質が低いから外そう」という判断が、結果を見たあとだと正当化されてしまう。これを防ぐために、先に書いて、先に公開します。
なお、診療ガイドライン作成のための SR(Minds 方式)では、アウトカムごとに文献集合を作るのが特徴です。1つの介入について、有効性のアウトカムと有害事象のアウトカムで別々に集合を作るので、同じ論文が複数のアウトカムで採用されることがあります。
4.2 検索 — 検索式を作り、漏れなく集める
使うデータベースは、最低でも次を押さえます(Minds 方式では PubMed/MEDLINE・Cochrane Library・医中誌 Web は必須)。
- PubMed / MEDLINE — 生物医学全般。米国 NLM
- Embase — 欧州中心。医薬品・有害事象に強い
- Cochrane Library(CENTRAL) — ランダム化比較試験を集めた登録簿
- 医中誌 Web — 日本語文献
- 領域に応じて CINAHL(看護)、PsycINFO(心理)など
1つのデータベースだけでは漏れます。索引の付け方も収録誌も違うためです。
検索式の作り方は、おおむね次の手順です。
- PICO の P と I(必要なら C)から概念を取り出す。O は原則として検索式に入れません。アウトカムはタイトルや抄録に書かれないことがあり、入れると取りこぼすからです
- 概念ごとに、統制語彙(PubMed なら MeSH、Embase なら Emtree)と自由語(タイトル・抄録中の語)を両方用意する。統制語彙は索引者が付けたタグなので表記ゆれに強く、自由語は新しい語や索引が間に合っていない文献を拾えます
- 同義語・略語・英米綴りの違い・単複を並べる(例:
neoplasm/cancer/tumour/tumor)。語尾の揺れは切り捨て記号(cancer*)でまとめます - 同じ概念の中は OR、概念どうしは AND でつなぐ
- データベースごとに構文が違うので、1つのマスター検索式を作ってから各データベース用に書き換える
SR の検索は、ふだんの文献検索と目的が逆です。ふだんは「読む価値のある数本」を効率よく見つけたい。SR では 1本も漏らさないことが最優先なので、ノイズが増えるのを承知で広く取ります。結果として数千件、テーマによっては数万件がヒットします。
データベース検索だけでは足りないので、次も行います。
- 灰色文献 — 学会抄録、学位論文、政府報告書、企業報告書。学会抄録として報告された研究の半分以上は本論文にならないと言われており、これを無視すると出版バイアスが入ります
- 臨床試験登録 — ClinicalTrials.gov、jRCT、WHO ICTRP。結果が公表されていない試験を見つけるため
- 引用追跡(snowballing) — 組み入れた論文の参考文献をたどる(後ろ向き)、その論文を引用している論文をたどる(前向き)
- ハンドサーチ — 主要誌の目次を手でめくる
検索式は PRESS(Peer Review of Electronic Search Strategies)という基準で、もう一人の情報検索の専門家に査読してもらうのが推奨されています。Minds 方式でも、SR チームの2名のうち1名は医学文献検索の専門家を入れる、とされています。
最後に、検索式そのものと検索日を、そのまま記録します。PRISMA-S(16項目)は、読者が同じ検索を再現できるだけの情報を報告することを求めています。集まったレコードは文献管理ソフト(EndNote、Zotero など)に取り込み、重複を除去してからスクリーニングに回します。
4.3 スクリーニング — 一次・二次の2段階
集めた数千件から組み入れる数十件まで絞る工程です。SR のなかで もっとも読む量が多いのがここです。
一次スクリーニングは、タイトルと抄録だけを見て判定します。全文を取り寄せる価値があるかどうかの判断なので、迷ったら残すのが原則です。ここで誤って落とすと、あとの工程では二度と拾えません。
二次スクリーニングは、残ったものの全文を入手して適格基準に照らします。ここで文献集合が確定します。
手続きとして決まっているのは次の点です。
- 2人が独立に判定する。 Cochrane の MECIR では C39 として必須とされています。ここで重要なのは「独立に」です。後から判定する人が先の人の判定を見ると、誤りをそのまま追認しやすくなります
- 事前にパイロットを回す。 いきなり全件やらず、最初の50〜100件を2人で判定して、判定が割れた箇所から基準の読み違いを洗い出し、適格基準の文言を直します
- 一致度を確認する。 2人の判定の一致をκ(カッパ)係数などで見ます。低ければ基準が曖昧だという信号です
- 割れたら合議、決まらなければ第三者。 解決方法もプロトコルに事前に書いておきます
- 二次スクリーニングの除外は、1件ずつ理由を残す。 PRISMA 2020 は、全文まで見て除外した文献をリストで示し、理由を付けることを求めています
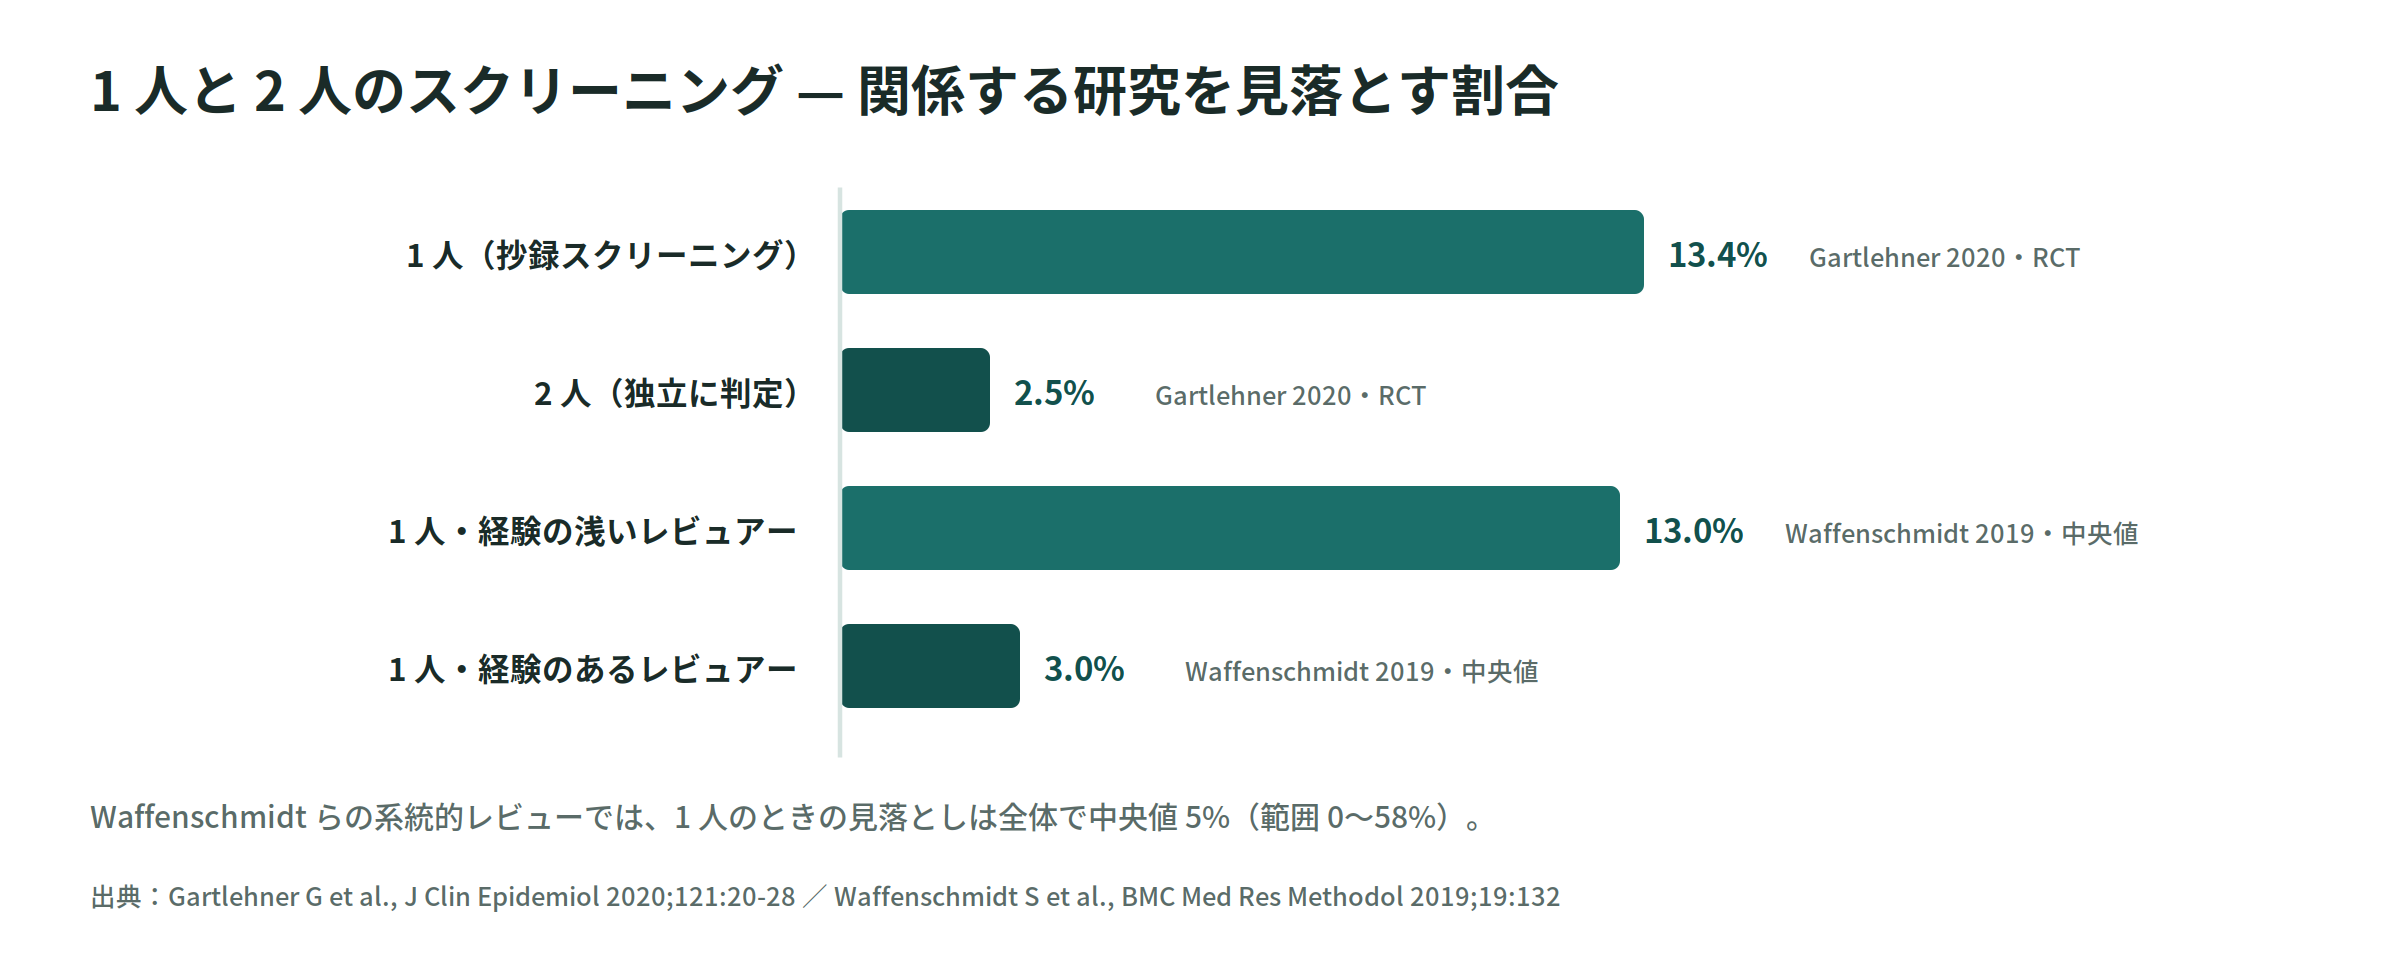
なぜ2人がかりなのか。1人で判定すると、関係する研究の 1割前後を見落とす ことが繰り返し報告されているからです(Gartlehner 2020 で 13.4% 対 2.5%、Waffenschmidt 2019 の系統的レビューで経験の浅いレビュアーの中央値 13%)。
量の感覚もつかんでおくと役に立ちます。検索ヒットのうち最終的に組み入れられるのは 平均2.94%(Borah 2017)。スクリーニング用の公開データセット SYNERGY では 1.67% です。つまり、読む量の97%以上は除外するための読みになります。この非対称性が、あとで自動化の話につながります。
4.4 データ抽出 — 論文から数字を取り出す
組み入れが確定したら、各論文から決めた項目を抜き出します。ここも アウトカムのデータは2人が独立に抽出する(MECIR C46)のが必須です。
抽出フォームは事前に作り、数本でパイロットします。 抽出しながら項目を足していくと、最初に抽出した論文だけ項目が欠けることになります。典型的な項目は次のとおりです。
- 書誌 — 著者、発表年、国、資金源、利益相反
- 研究デザイン — RCT か観察研究か、割付の単位、盲検化の有無、追跡期間
- 対象者 — 組み入れ基準、人数、年齢、重症度、併存疾患
- 介入と対照 — 薬剤名・用量・期間、対照の内容
- アウトカム — 定義、測定方法、測定時点
- 結果 — 各群の n、イベント数または平均値と標準偏差、効果量と信頼区間
実務でつまずくのは次の2点です。
ひとつは、必要な数字が論文に載っていないこと。中央値と四分位しかない、グラフしかない、といったケースです。著者に問い合わせる、グラフから読み取る、他の統計量から推定する、といった対応を取り、どれをしたかを記録します。
もうひとつは、1つの試験が複数の論文に分かれていること。主要アウトカムの論文、長期追跡の論文、サブグループ解析の論文が別々に出ていることがあります。これを別々の研究として数えると、同じ患者を二重に数えることになります。数えるのは論文ではなく試験です。
4.5 バイアスリスクの評価
集めた研究の結果を、そのまま信じてよいかを判定する工程です。ここで見るのは論文の「出来のよさ」ではなく、結果が真の値から系統的にずれるおそれ(risk of bias)です。
判定は 研究単位ではなくアウトカム単位 で行います。同じ論文でも、客観的に測れる死亡率と、患者の主観が入る疼痛スコアではバイアスの入り方が違うからです。
RCT には RoB 2 を使います。次の5領域を、それぞれ「低リスク/懸念あり/高リスク」で判定し、全体判定を出します。
- ランダム化の過程から生じるバイアス — 乱数列の生成は適切か、割付は隠蔽(コンシールメント)されていたか、ベースラインに不均衡がないか
- 意図した介入からの逸脱によるバイアス — 参加者・医療者が割付を知っていたか、それによって行動が変わったか、ITT 解析か
- アウトカムデータの欠測によるバイアス — 脱落はどれだけか、脱落の理由が群間で違わないか
- アウトカム測定のバイアス — 測定者が割付を知っていたか、測定方法は群間で同じか
- 報告される結果の選択によるバイアス — プロトコルにあったアウトカムが全部報告されているか、都合のよい解析だけ出していないか
非ランダム化研究には ROBINS-I を使います。領域は7つで、RoB 2 の5領域に加えて 交絡(比べている群の背景が違う)と 参加者の選択 が入ります。観察研究では交絡が最大の問題なので、ここが独立した領域になっています。
日本の Minds 方式では、従来からの5分類(選択バイアス/実行バイアス/検出バイアス/症例減少バイアス/その他のバイアス)で評価シートを作り、RoB 2 対応版も用意されています。各領域を「低 0/中・疑い −1/高 −2」で点数化してまとめる形です。
観察研究については、逆に格を 上げる要因も評価します。用量反応勾配がある、調整しきれていない交絡がむしろ効果を弱める向きに働いている、効果の大きさが極端(RR > 5 または < 0.2 で +2、RR > 2 または < 0.5 で +1)、といった場合です。
4.6 統合とエビデンスの確実性
まず 定性的 SR を行います。アウトカムごとに、集めた研究全体(エビデンス総体)としてどう言えるかを、研究数・対象者数・バイアスリスク・結果の方向のばらつきとあわせて記述します。
そのうえで、数量的に統合できる場合に メタアナリシス(定量的 SR) へ進みます。メタアナリシスは必須ではありません。 Minds は、定性的にエビデンスの強さが保証できる場合(たとえば対象論文がすべて同じ結果)、同じ研究デザインの研究が1つしかない場合、既存のメタアナリシスがある場合は不要としています。
メタアナリシスの実務で決めることは次のとおりです。
- 効果指標 — 二値アウトカムならリスク比(RR)、オッズ比(OR)、リスク差(RD)。連続量なら平均値差(MD)、尺度が違うなら標準化平均値差(SMD)。時間を含むならハザード比(HR)
- 統合モデル — 集めた研究だけを対象とみなす 固定効果モデル と、背後の母集団からランダムに選ばれた研究とみなす ランダム効果モデル。研究間に真のばらつきがあることを前提にできるため、ランダム効果モデルが推奨されます
- 異質性の確認 — フォレストプロット で各研究の効果量と信頼区間を並べ、ばらつきを I² などの指標で見ます。ばらつきが大きいときは、無理に1つの数字にまとめず、原因(対象者、用量、追跡期間)をサブグループ解析で探ります
- 出版バイアスの確認 — ファンネルプロット の非対称性を見ます。小規模で否定的な結果の研究が公表されていないと、左右が非対称になります
- 感度分析 — 「高リスクの研究を外したら結論が変わるか」「固定効果にしたら変わるか」を確かめます
最後に、アウトカムごとの エビデンスの確実性 を GRADE で4段階(高・中・低・非常に低)に格付けします。RCT は「高」から、観察研究は「低」から出発し、次の5つで格下げします。
- バイアスリスク — 組み入れた研究のバイアスリスクが高い
- 非一貫性 — 研究間で結果の方向や大きさが揃わない
- 非直接性 — 知りたい PICO と研究の PICO がずれている(対象者が違う、代替アウトカムを見ている)
- 不精確さ — 信頼区間が広い、イベント数が少ない
- 出版バイアス — 都合の悪い結果が公表されていない疑い
観察研究では、前述の3つの要因(効果が大きい、用量反応勾配、効果を弱める向きの残余交絡)で格上げします。
結果は SoF 表(Summary of Findings、結果のまとめ表) にまとめます。アウトカムごとに、対象者数、効果の大きさ(相対・絶対)、確実性の格付けと、格下げした理由が1枚に並ぶ表です。診療ガイドラインの推奨は、この表を見て作られます。
5. 報告の型:PRISMA 2020
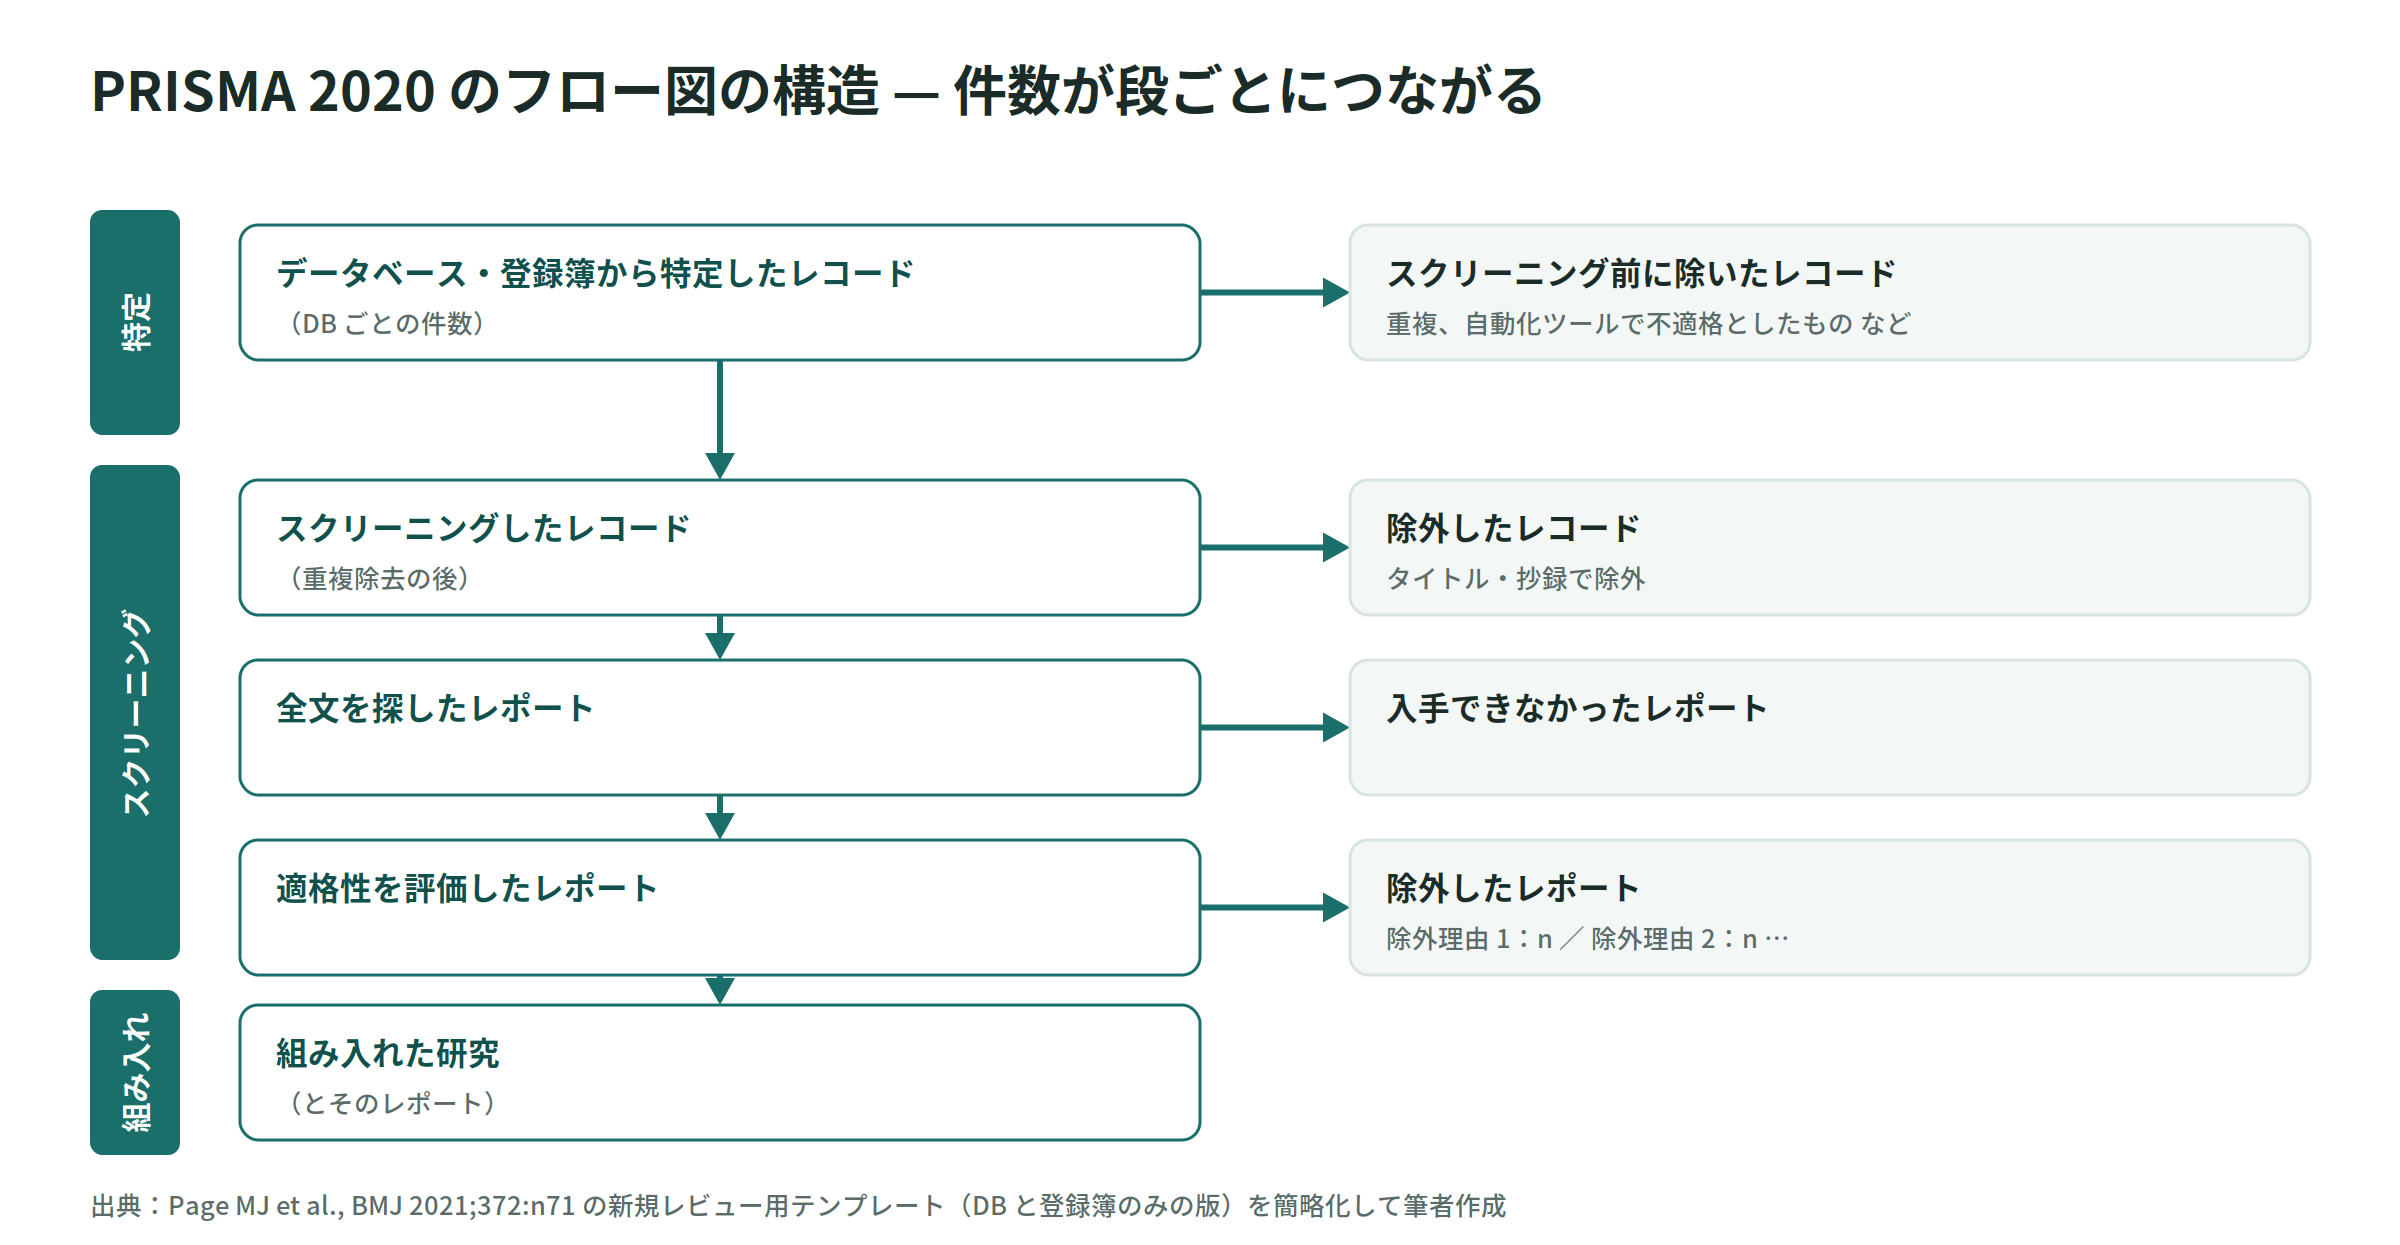
ここまでの工程を、読者が追えるように書くための報告指針が PRISMA 2020 です。27項目のチェックリストと、件数の流れを示すフロー図からなります(日本語訳は上岡ら 2021)。
フロー図の要点は、段ごとに件数がつながることです。データベースから何件見つけ、重複除去で何件になり、一次スクリーニングで何件除外し、全文を何件探して何件入手でき、何件を適格性評価にかけ、何件をなぜ除外し、最終的に何件を組み入れたか。この足し算が合わないと、どこかで説明されていない操作があることになります。
Minds 方式では、この過程を SR-1「データベース検索結果」から SR-15「Future Research Question」までのテンプレート群として様式化しています(SR-2 が文献検索フローチャート、SR-5/SR-6 が個別文献の評価シート、SR-7 がエビデンス総体、SR-12 以降が SoF 表)。
6. どれくらいの時間と人手がかかるか
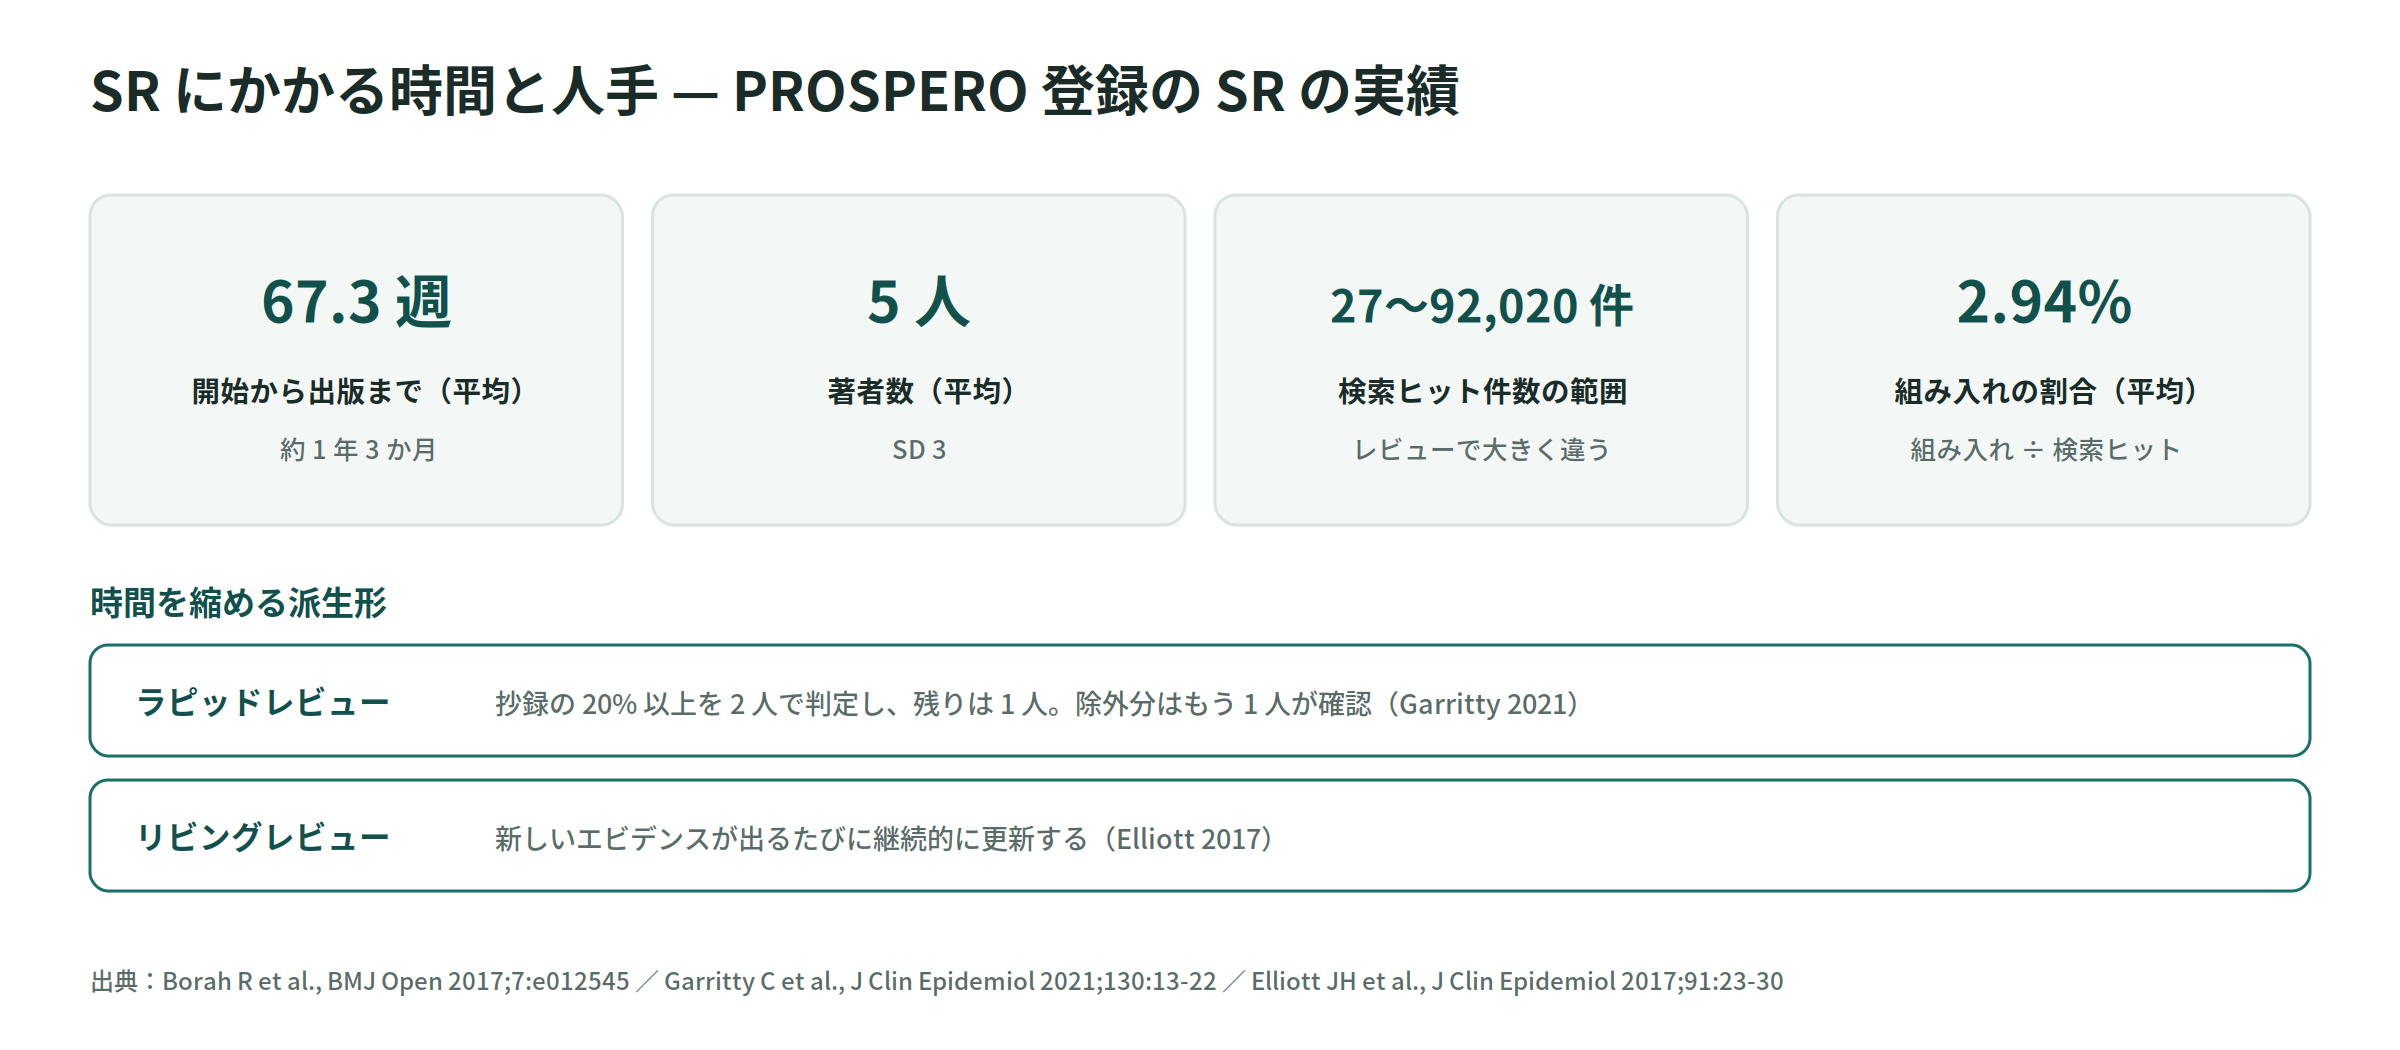
PROSPERO に登録された SR の実績では、開始から出版まで 平均67.3週(約1年3か月)、著者は 平均5人 です(Borah 2017)。検索ヒット件数は27件から92,020件まで、レビューによって3桁以上違います。
問題は、1年以上かけて完成させた時点で、検索日のあとに新しい研究が出ていることです。SR が「出版された瞬間に少し古い」という構造的な弱点を持つため、2つの派生形が使われています。
- ラピッドレビュー — 手順を意図的に簡略化して速く出す。Cochrane の指針では、抄録の20%以上を2人で判定して基準をすり合わせ、残りは1人で判定、除外分はもう1人が確認、といった形に落とします(Garritty 2021)
- リビングレビュー — 一度作って終わりにせず、新しいエビデンスが出るたびに継続的に更新する(Elliott 2017)
どちらも中心の課題は同じで、スクリーニングの工数をどう減らすかです。
7. 製薬・ヘルスケアでの用途
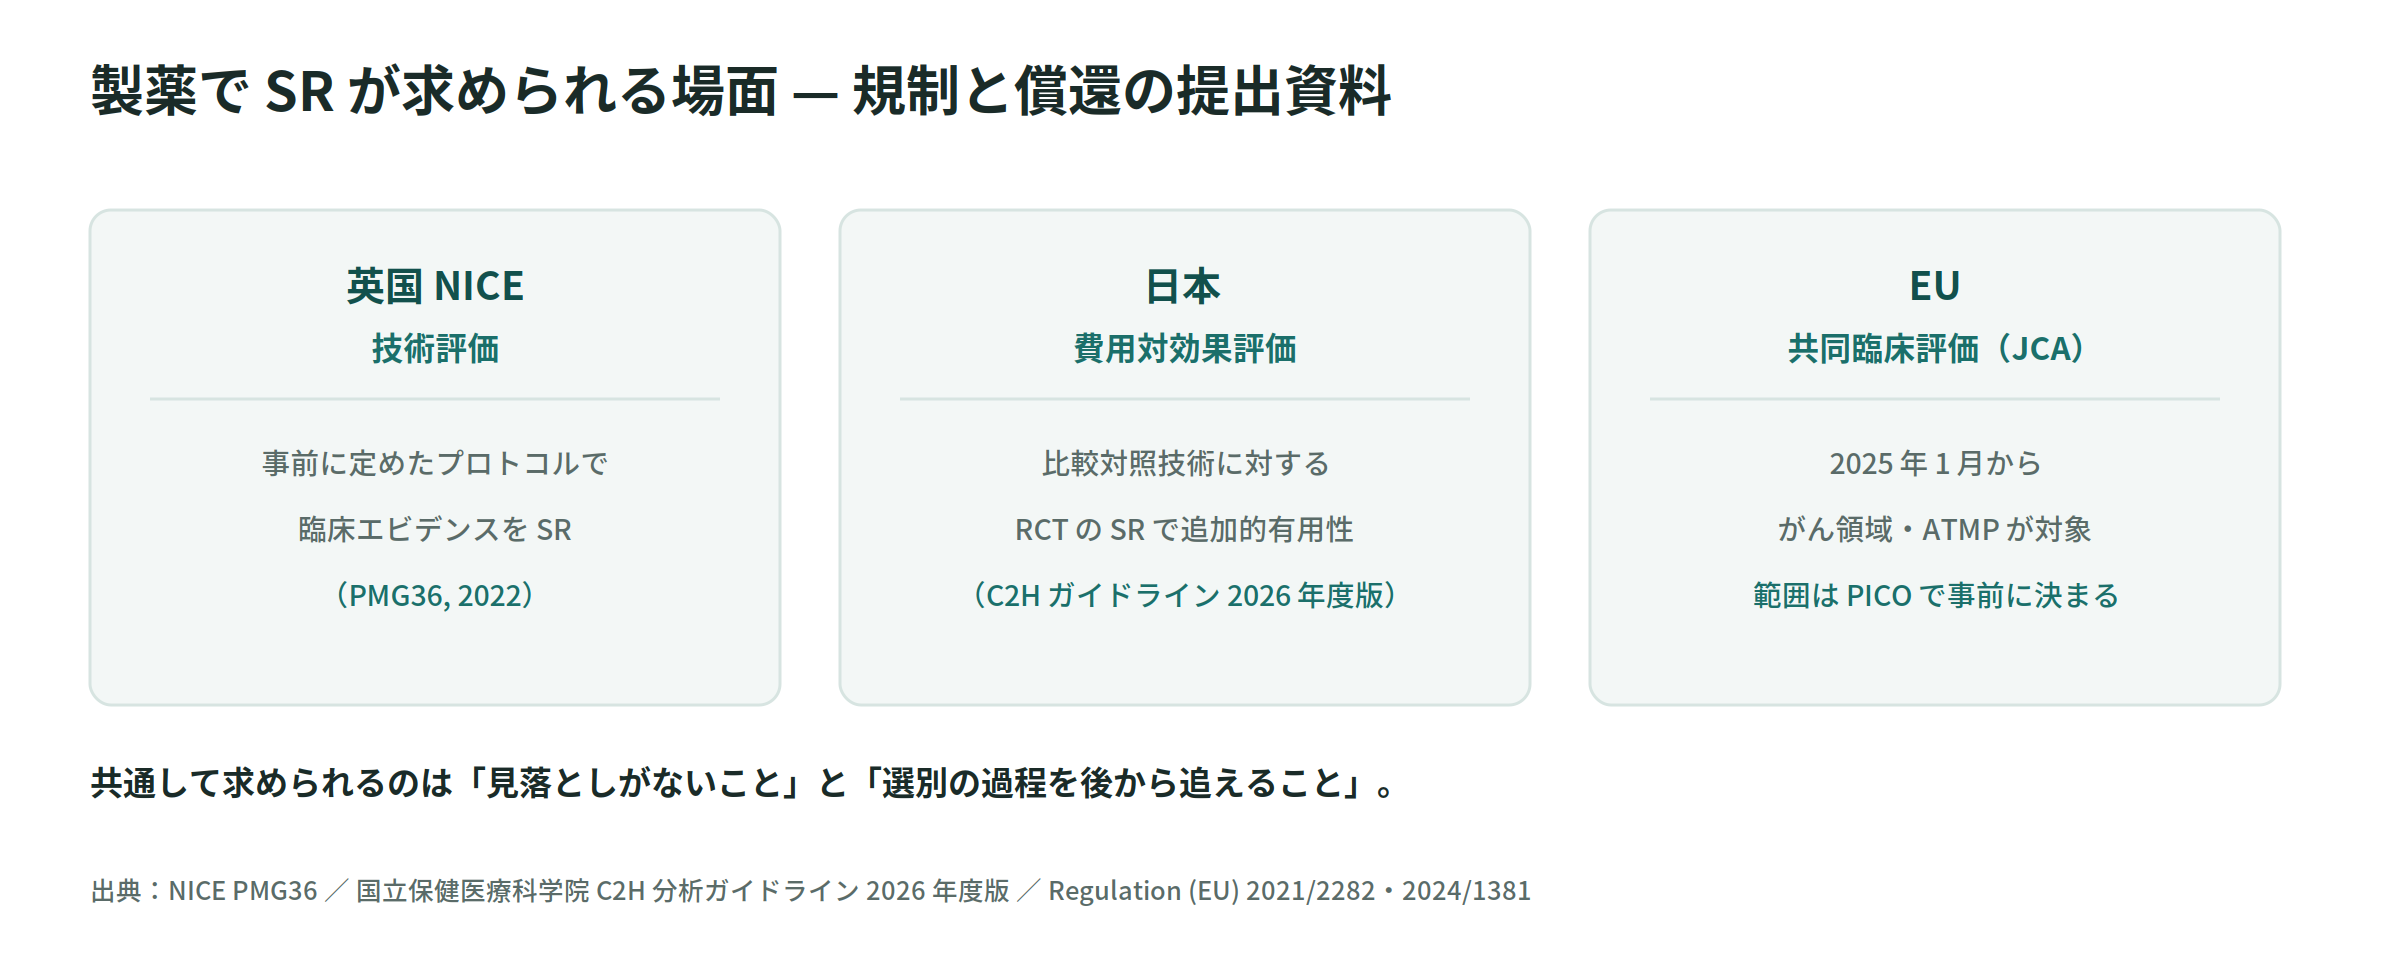
製薬企業にとって SR は、学術的な活動である前に 規制と償還の提出資料 です。
- 英国 NICE — 技術評価で、事前に定めたプロトコルに基づく臨床エビデンスの SR を求めます(PMG36, 2022)
- 日本の費用対効果評価 — 分析ガイドライン 2026年度版が、比較対照技術に対する追加的有用性を RCT の SR で示すことを想定しています
- EU の共同臨床評価(JCA) — 2025年1月から、がん領域と ATMP を対象に始まりました。評価の範囲は PICO の形で事前に決まります
共通して求められるのは、見落としがないことと、選別の過程を後から追えることの2つです。どちらも「たくさん読んだ」では代用できず、手順と記録で示す必要があります。
8. つまずきやすいところ
- 検索を絞りすぎる — 精度を上げようとして検索式を狭めると、漏れが出ます。SR の検索はノイズを許容します
- アウトカムを検索式に入れる — 抄録に書かれていないアウトカムがあるため、取りこぼします
- 基準を後から変える — 文献を読んでから適格基準を直すと、結果を見て選んだのと同じことになります。変更するなら、いつ・なぜ変えたかを報告します
- 論文の数と試験の数を混同する — 1試験が複数論文に分かれていると、同じ患者を二重に数えます
- バイアスリスクを研究単位で付ける — アウトカムごとに付けます
- 異質なものを無理に統合する — 数字は出ますが、意味のない平均になります。統合しない判断も正解です
- 既存の SR を無視する — Minds も、既存の SR の利用(統合結果をそのまま使う、同じ検索戦略で新しい研究を足す、など)を明示的に認めています。ゼロから始める必要はありません
9. まとめ
- SR は、事前に決めた手順で研究を漏れなく集め、質を評価し、統合する 研究。1本の研究が持つ偶然とバイアスの振れを平らにするための手順
- エビデンスの階層では最上位。ただし上位に置かれる根拠は手順であって形式ではなく、確実性は GRADE で個別に格付けする
- 工程は PICO とプロトコル → 検索 → 一次・二次スクリーニング → データ抽出 → バイアスリスク → 統合と GRADE の6つ
- 組み入れの判定とデータ抽出は、2人が独立に行うことが必須(MECIR C39 / C46)
- 検索ヒットのうち組み入れに残るのは平均2.94%。読む量の97%以上は除外するための読み
- 報告は PRISMA 2020。件数が段ごとにつながり、除外理由が追えることが最低条件
- 1本に平均67.3週。だからラピッドレビューとリビングレビューがあり、どちらもスクリーニングの工数が中心の課題になる
10. 次のステップ
この最後の1点、スクリーニングの工数をどう減らすかを、機械で支援する側から扱います。教師あり分類から能動学習、LLM によるゼロショット判定、エージェント型までの技術の系譜と、recall・WSS@95%・Recall@k といった評価指標を、続く解説ページ「【技術説明】文献スクリーニング自動化」で公開予定です。
そのうえで、連載本編では Claude Code の AI サブエージェントを使って、この工程を実際に動かすところまで作ります。
出典
- Higgins JPT et al. (eds). Cochrane Handbook for Systematic Reviews of Interventions, version 6.5. Cochrane, 2024
- 日本医療機能評価機構 EBM 医療情報部(Minds). Minds 診療ガイドライン作成マニュアル 2020 ver3.0
- 日本医療機能評価機構 EBM 医療情報部(Minds). 診療ガイドライン作成のためのシステマティックレビュー(基礎編・研修資料、2024年3月29日公開)
- Page MJ et al. The PRISMA 2020 statement. BMJ 2021;372:n71
- 上岡洋晴ら. 「PRISMA 2020 声明:システマティック・レビュー報告のための更新版ガイドライン」の解説と日本語訳. 薬理と治療 2021;49:831-842
- Rethlefsen ML et al. PRISMA-S. Syst Rev 2021;10:39
- McGowan J et al. PRESS Peer Review of Electronic Search Strategies: 2015 Guideline Statement. J Clin Epidemiol 2016;75:40-46
- Richardson WS et al. The well-built clinical question. ACP J Club 1995;123(3):A12-A13
- Borah R et al. Analysis of the time and workers needed to conduct systematic reviews. BMJ Open 2017;7:e012545
- Bastian H, Glasziou P, Chalmers I. Seventy-five trials and eleven systematic reviews a day. PLoS Med 2010;7(9):e1000326
- Hoffmann F et al. Nearly 80 systematic reviews were published each day. J Clin Epidemiol 2021;138:1-11
- Gartlehner G et al. Single-reviewer abstract screening missed 13 percent of relevant studies. J Clin Epidemiol 2020;121:20-28
- Waffenschmidt S et al. Single screening versus conventional double screening. BMC Med Res Methodol 2019;19:132
- Cochrane. MECIR Manual, C39 / C46
- Sterne JAC et al. RoB 2. BMJ 2019;366:l4898 / ROBINS-I. BMJ 2016;355:i4919
- Higgins JPT, Thompson SG. Quantifying heterogeneity in a meta-analysis. Stat Med 2002;21:1539-1558
- Guyatt GH et al. GRADE. BMJ 2008;336:924-926
- Balshem H et al. GRADE guidelines: 3. Rating the quality of evidence. J Clin Epidemiol 2011;64(4):401-406
- Murad MH et al. New evidence pyramid. Evid Based Med 2016;21(4):125-127
- OCEBM Levels of Evidence Working Group. The Oxford 2011 Levels of Evidence
- Garritty C et al. Cochrane Rapid Reviews Methods Group guidance. J Clin Epidemiol 2021;130:13-22
- Elliott JH et al. Living systematic review: 1. J Clin Epidemiol 2017;91:23-30
- De Bruin J et al. SYNERGY dataset. DataverseNL 2023, doi:10.34894/HE6NAQ
- NICE. PMG36 technology appraisal and highly specialised technologies guidance: the manual (2022)
- 国立保健医療科学院 C2H. 中央社会保険医療協議会における費用対効果評価の分析ガイドライン 2026年度版(2026年1月16日中医協総会了承)
- Regulation (EU) 2021/2282 on health technology assessment / Implementing Regulation (EU) 2024/1381
- NLM. PubMed About / MEDLINE PubMed Production Statistics