Claude Code × Medical Application
【Claude Code】系統的文献レビュー × AI サブエージェント Part0:原著と本試行の設計
1. はじめに
系統的文献レビュー(SR)は、決めた手順で文献を漏れなく集め、基準に沿って選び、結果をまとめる作業です。中でも、数百〜数千件の候補をタイトルと抄録で振り分ける一次スクリーニングに、いちばん人手がかかります。手順と品質基準は解説ページ「【業務説明】系統的文献レビュー」に、自動化の技術の流れは「【技術説明】文献スクリーニング自動化」にまとめました。
この連載の第2作では、LLM で SR の作業を進めた論文 TrialMind を取り上げ、その手法を Claude Code で組み直します。原著と同じ物差しで測り、どこまで同じ結果が出るか、どこが違うかを確かめます。
第1作は「エージェントにアプリを作らせる」話でした。第2作は「エージェントに業務の手順を任せ、その出来を原著と同じ指標で測る」話です。Part0 では、原著の中身と、本試行の問い・条件・流れを示します。
SR の工程のうち、本試行で扱うのは次の3つです。
| 工程 | 読むもの | 出すもの | 本試行 |
|---|---|---|---|
| 検索 | PICO | 検索式と候補の論文(数百件) | ○(Part1) |
| 一次スクリーニング | 候補すべてのタイトルと抄録 | 「読むべきか」の判定と順位 | ○(Part2) |
| 二次スクリーニング | 残った論文の全文 | 組み入れるかの最終判断 | ×(原著にもない) |
| データ抽出 | 組み入れた論文だけの全文(表を含む) | 患者数、年齢、標的抗原、投与量などの値の表 | ○(Part3) |
| 統合 | 抽出した値 | メタアナリシス、forest plot | ×(原著にはある。臨床の結論にあたるので扱わない) |
一次スクリーニングは「どれを読むか」を決める作業で、指標は Recall@20・@50 です。データ抽出は「読むと決めた論文から値を書き写す」作業で、指標は Accuracy です。答えの論文も、使うデータも、指標も別になります。つまり本試行は、原著の3つの作業(検索・スクリーニング・抽出)を、統合の手前まで組み直したものです。
コードは GitHub(MIT)で公開しています。結果は見本の画面で、概要・論文の一覧・抽出の3つのタブから見られます(抄録と引用は伏せた公開版)。
2. 原著 TrialMind
2-1. 論文の概要
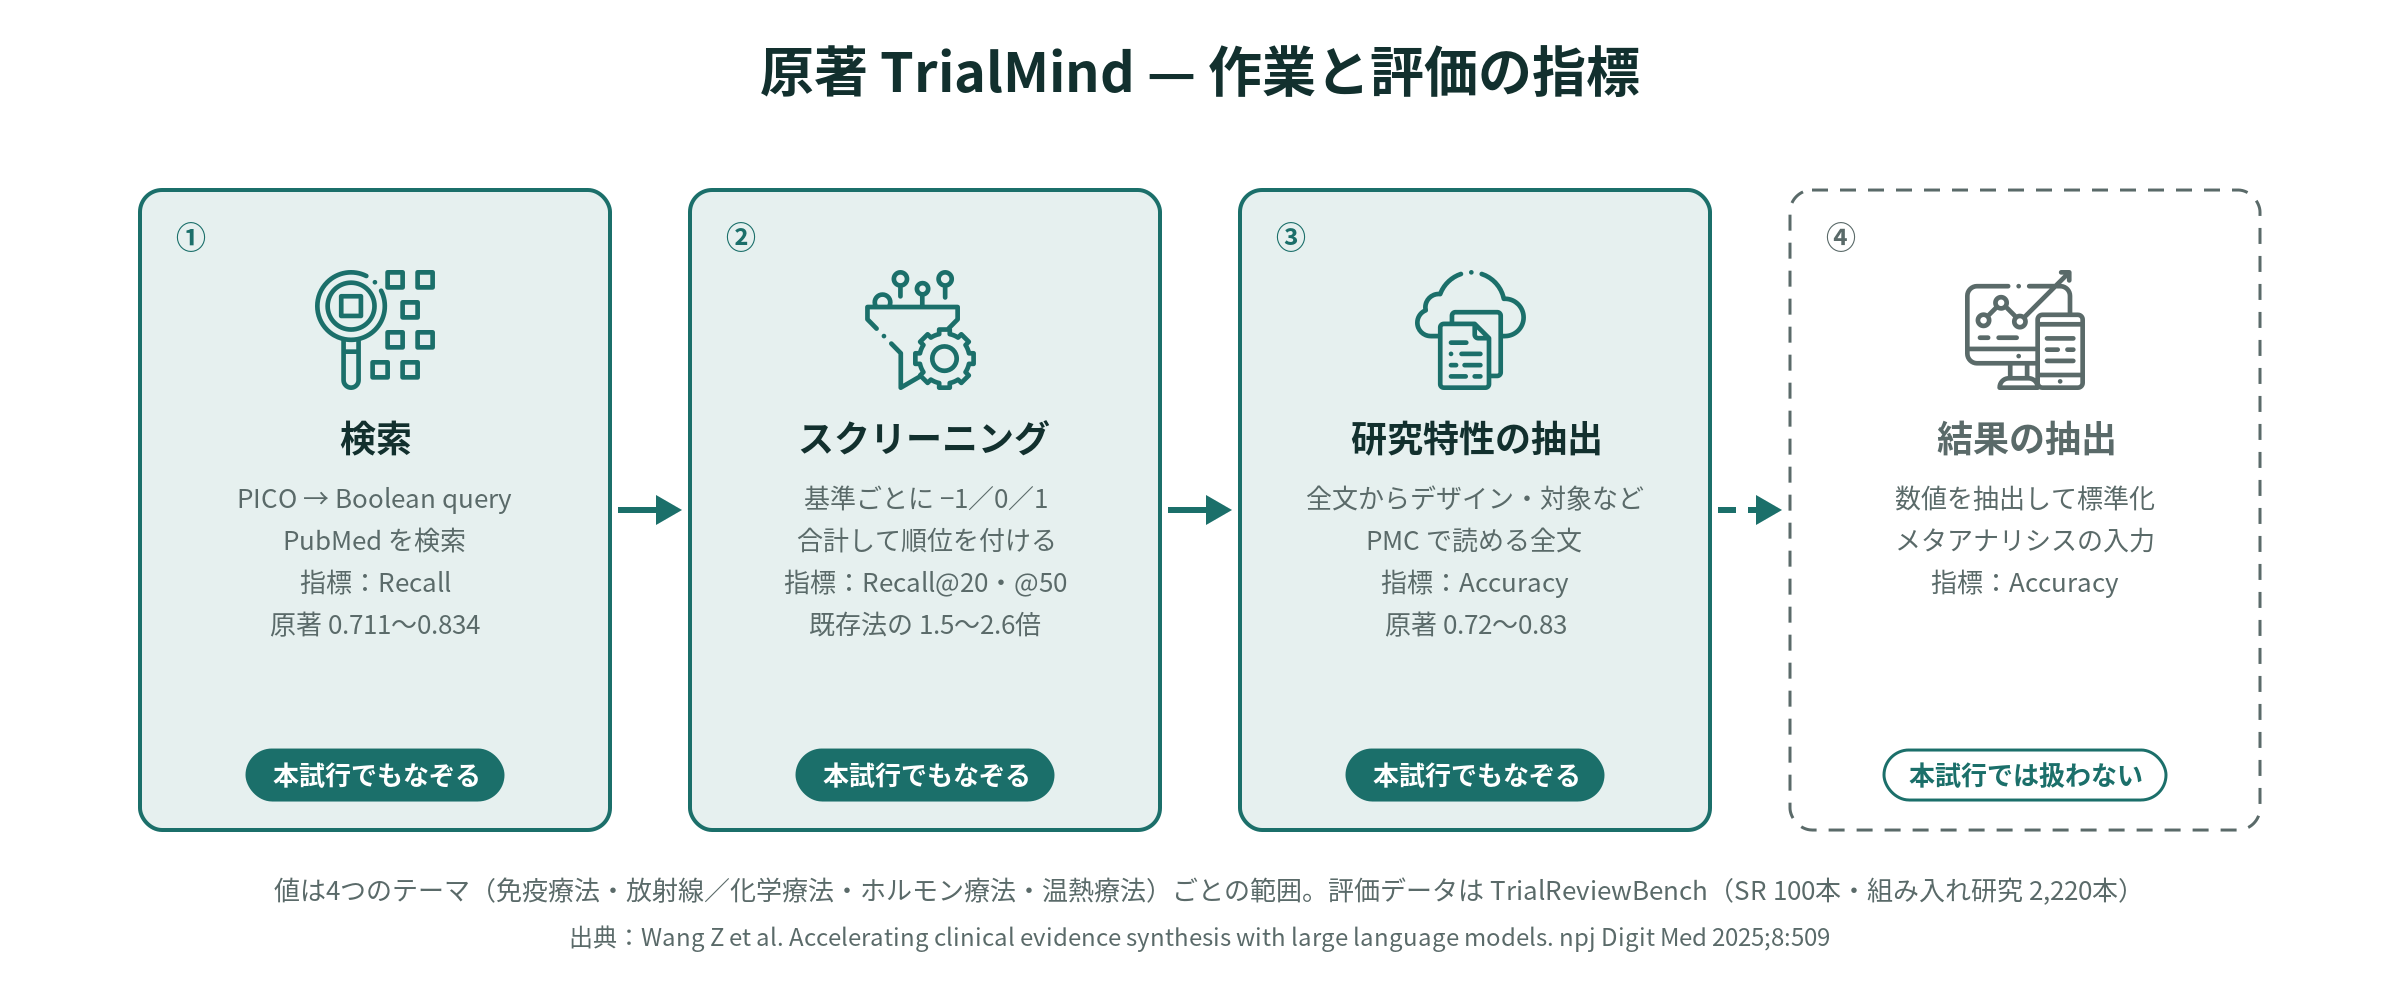
米国 NIH の国立医学図書館(NLM)などのグループが、npj Digital Medicine に 2025年に発表した論文です(Wang et al., 2025;8:509)。SR の作業のうち、検索・スクリーニング・データ抽出の3つを LLM に担わせ、それぞれを公開ベンチマークで評価しました。
| 作業 | 原著の方法 | 指標 | 原著の値 |
|---|---|---|---|
| 検索 | PICO から Boolean query を作り、予備検索の抄録を参考に語を足し引きして PubMed を検索 | Recall(組み入れ研究をどれだけ拾えたか) | 0.711〜0.834(人が作った検索式は 0.138〜0.232) |
| スクリーニング | PICO から適格基準を書き出し、候補ごとに基準1つずつを −1(不適格)/0(不明)/1(適格)で判定し、合計で順位を付ける | Recall@20・Recall@50(上位20件・50件に組み入れ研究が何割入るか) | 埋め込みによる順位付けの 1.5〜2.6倍 |
| データ抽出 | 全文から研究特性(デザイン、対象、介入など)と結果を抽出 | Accuracy(人が原著の表と照らして採点) | 研究特性で 0.72〜0.83 |
値は4つのテーマ(免疫療法、放射線・化学療法、ホルモン療法、温熱療法)ごとの範囲です。評価に使ったモデルは GPT-4 と Claude 3 Sonnet でした。
評価データの TrialReviewBench は、がん治療の SR 100本と、その組み入れ研究 2,220本からなります。正解は「元の SR が組み入れた研究の PubMed ID(PMID)」です。
2-2. 原著の限界
原著自身が、次の限界を書いています。
- 検索は PubMed だけ。全文は PubMed Central(PMC)で読めるものに限った
- テーマはがん治療に限られ、予防や診断の研究に当てはまるかは分からない
- スクリーニングの評価では、1本の SR につき組み入れ研究をすべて含む 2,000件の候補の中で順位を付けた
最後の点は、数字を読むときに効きます。実際の検索では組み入れ研究を取りこぼすことがありますが、原著はスクリーニングを検索と切り離し、組み入れ研究がすべて候補にある状態で順位付けの力を測っています。
2-3. otto-SR ではなく TrialMind を選んだ理由
近い研究に、スクリーニングからデータ抽出までを1つのワークフローで行う otto-SR(Cao et al., medRxiv 2025)があります。報告された感度・特異度は高いものの、査読前で、コードも公開されていません。
TrialMind は査読を経ており、コード(MIT)と評価データ(Apache-2.0)が公開されています。同じデータで同じ指標を測れるので、組み直した結果を原著と並べられます。再実装の土台には、数字の高さより確かめられることを優先しました。なお、どちらの論文も著者に企業との関わりがあるので、利益相反は選んだ理由にしていません。詳しい比較は技術説明ページの 2-5 にあります。
3. 本試行の問いと位置づけ
3-1. 問い
原著の手法を Claude Code で組み直し、同じ指標で測ると、原著と同じ水準になるか。
原著の3つの作業(検索・スクリーニング・データ抽出)をなぞります。結果の統合(メタアナリシス)は臨床の結論にあたるので扱いません。
3-2. 位置づけ
このワークフローは、SR の手法を学ぶ教材と、論文の手法を自分で確かめる道具です。業務の一次スクリーニングの代わりにはしません。実際の SR は Embase や Cochrane CENTRAL、臨床試験レジストリ、学会抄録も検索しますが、この試行は原著と同じく PubMed だけを検索するからです。
同じ理由で、この連載では次の書き方をしません。
- 「追試」「再現に成功した」:データの取得時期、候補の集め方、モデルが原著と違う
- 「精度が証明された」:3本のレビューでの1回の結果にすぎない
4. 原著との違い
組み直すと、どうしても原著と条件が変わります。先に並べておきます。
| 項目 | 原著 | 本試行 |
|---|---|---|
| 対象 | がん治療の SR 100本 | TrialReviewBench の免疫療法から、血液がんの CAR-T の SR 3本 |
| スクリーニングの候補 | 組み入れ研究をすべて含む 2,000件 | 検索のヒットに、検索で拾えなかった組み入れ研究を足したもの(485〜698件、3本で計 1,866件) |
| モデル | GPT-4、Claude 3 Sonnet | Claude Sonnet(Claude Code の subagent) |
| 判定のしかた | 基準ごとに −1/0/1、合計で順位 | 同じ。加えて、判定ごとに抄録からの逐語引用を必須にし、hook で検査 |
| 人の関与 | 基準は人が編集できる設計 | 原著と比べる流れでは、基準は LLM の案のまま使い、人は判定に入らない |
| 全文 | PMC で読めるもの | 同じ(PMC から本文が取れる研究だけ) |
| 抽出の採点 | 3人の採点者が手作業で照合 | 完全一致は規則で正解、それ以外は人が1件ずつ採点 |
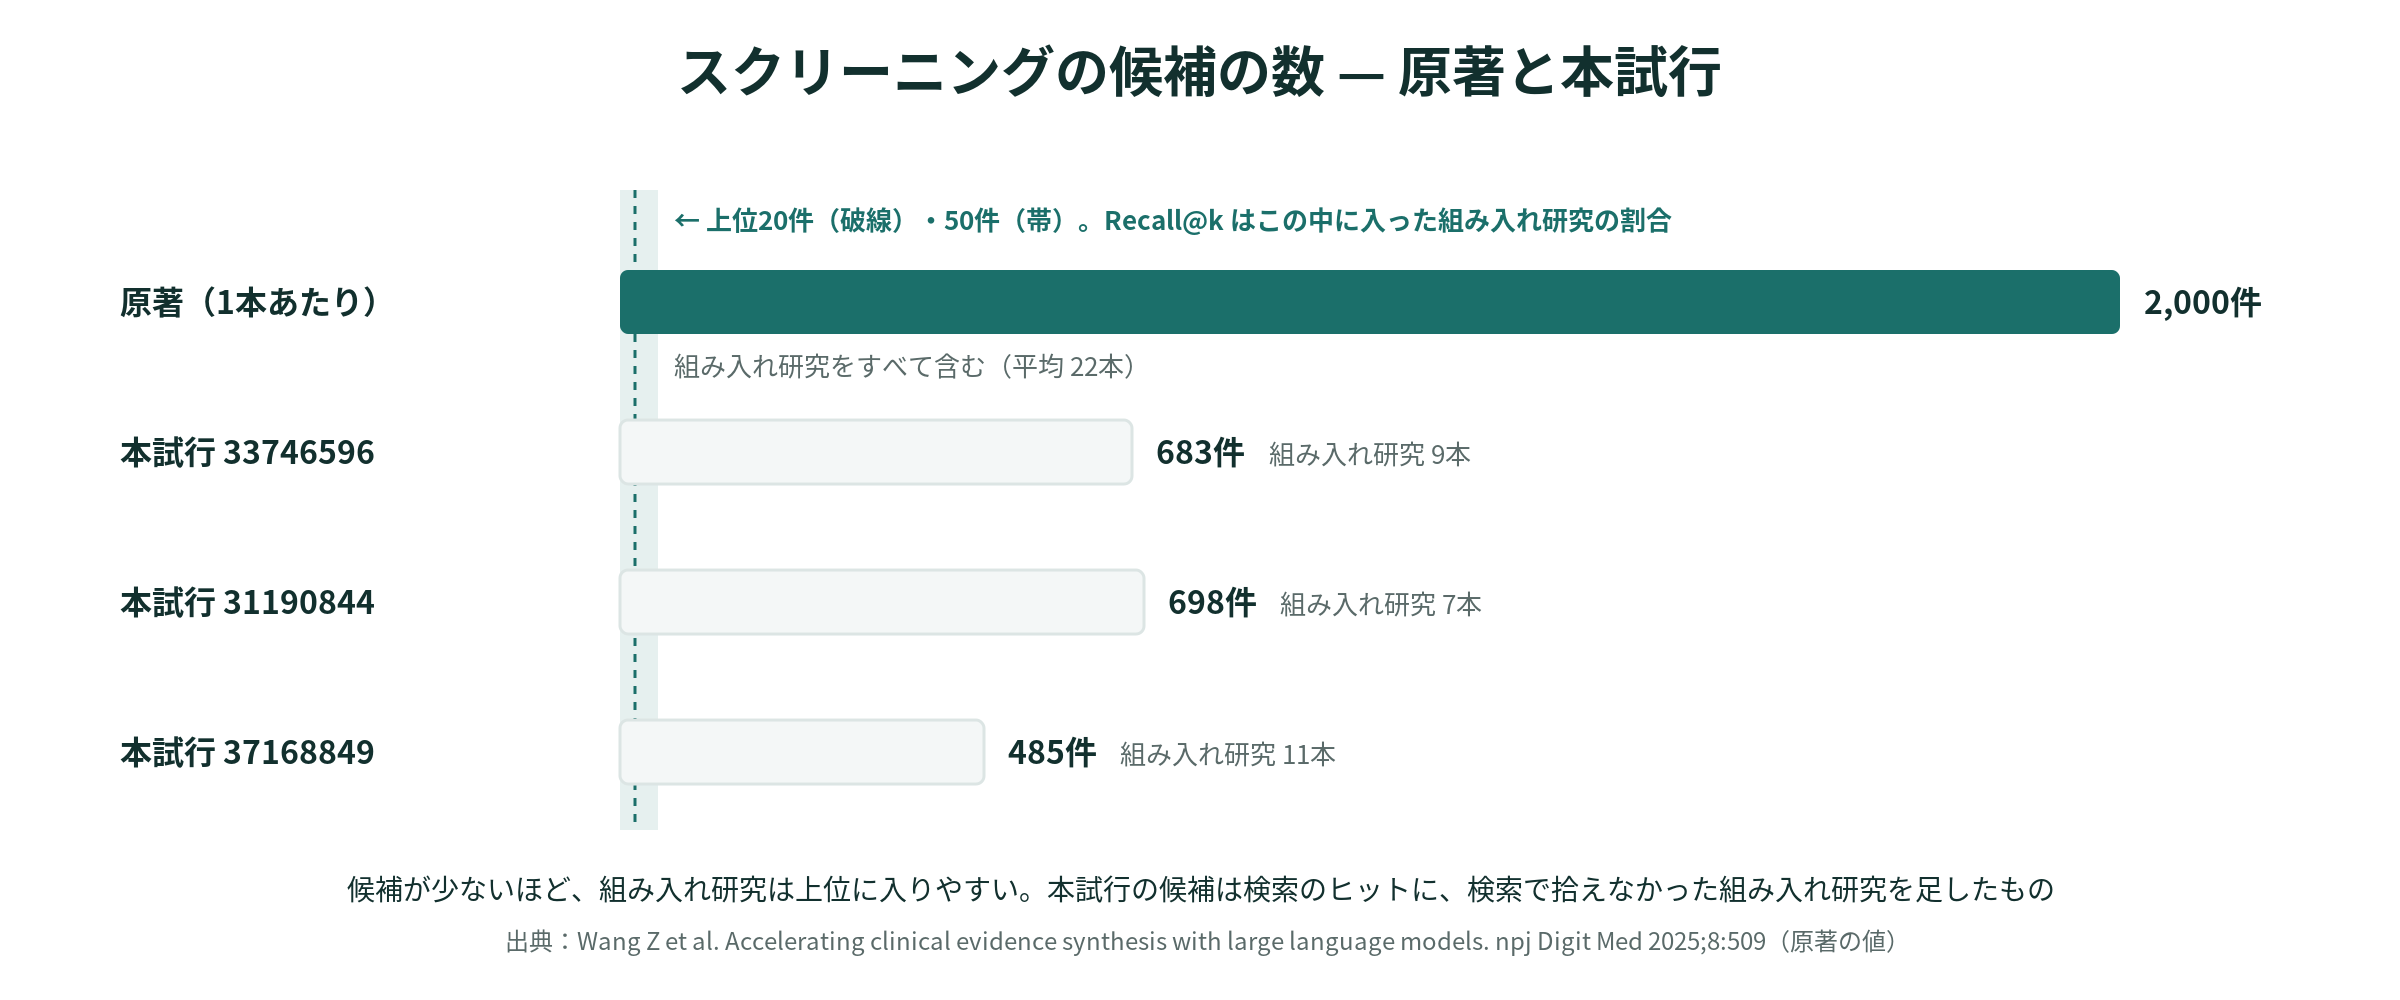
候補の数の違いは、Recall@k の読み方に直接効きます。候補が少ないほど、組み入れ研究は上位20件・50件に入りやすくなります。本試行でも原著に合わせて、検索で拾えなかった組み入れ研究は候補に足していますが、数の差は残ります。原著との比較はこの差を書き添えたうえで行います(Part2)。
5. 対象のレビュー
| PMID | テーマ | 組み入れ研究(正解) |
|---|---|---|
| 33746596 | 再発・難治性の多発性骨髄腫に対する CAR-T 療法の有効性と安全性 | 9本 |
| 31190844 | 血液がんに対する自家 CD19 CAR-T 療法の生存と有効性 | 7本 |
| 37168849 | 再発・難治性の急性骨髄性白血病に対する CAR-T 療法の成績 | 11本 |
3本はテーマが近く、組み入れ研究が少ないので、1本ずつ中身を確かめられます。検索期間の上限は元のレビューの出版時点に合わせました。元のレビューが見られなかった論文を、正解と比べる土俵に入れないためです。
6. 本試行の流れ
6-1. 全体の流れ
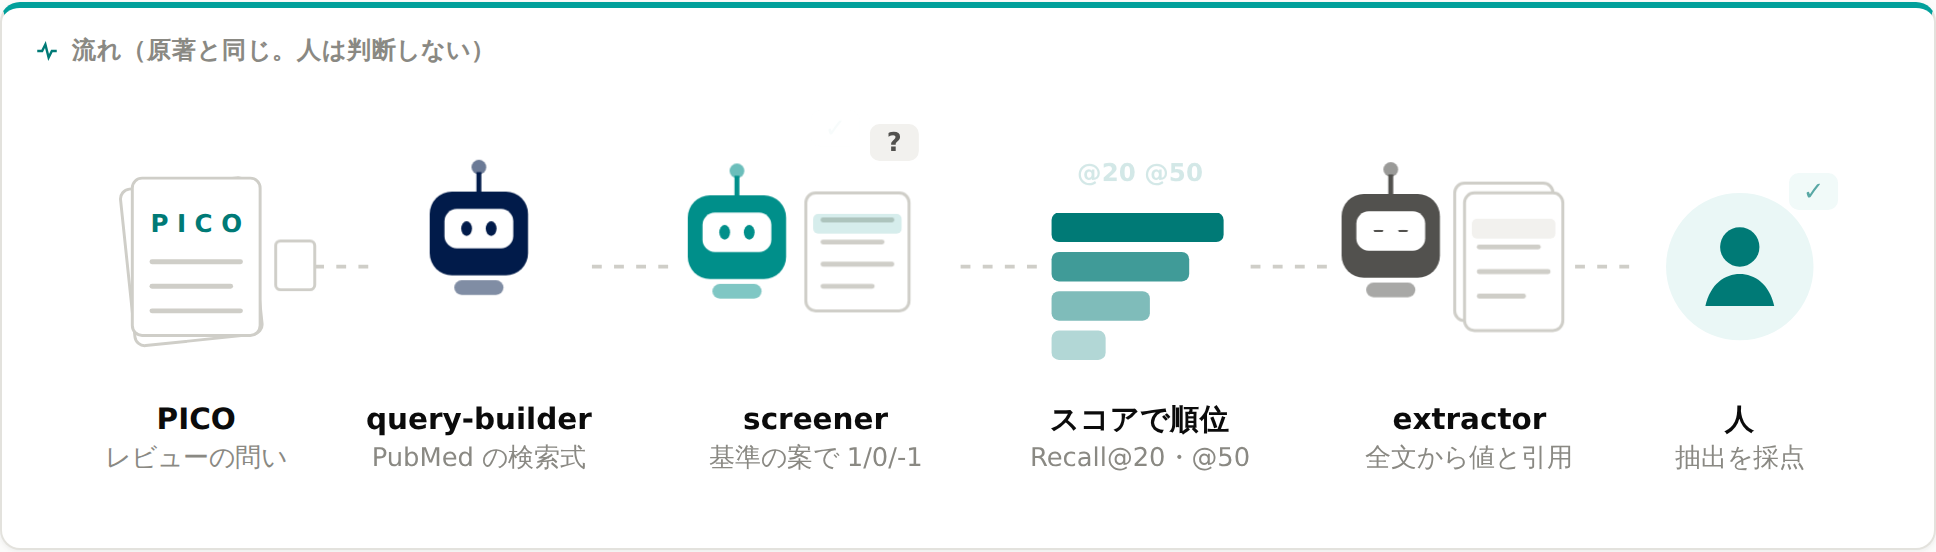
冒頭のアニメーションは、この流れを1周させたものです。表の①〜⑥と記録を、段ごとに見ると次のとおりです。
| 段 | 担当 | 中身 |
|---|---|---|
| ① 適格基準 | skill /pico-to-criteria |
PICO から、組み入れ基準(I)と除外基準(E)の案を書く |
| ② 検索式 | subagent query-builder |
Anthropic 公式の PubMed コネクタ(MCP)で部分式を試し、検索式を1本作る |
| ③ 候補の取得 | スクリプト fetch_pubmed.py |
決まった検索式で、全ヒットの書誌と抄録を E-utilities から一括で取る |
| ④ スクリーニング | subagent screener + hook |
20件ずつのバッチで、基準ごとに 1/0/−1 と逐語引用を書く。引用が抄録に実在するかを hook が検査し、無ければ差し戻す |
| ⑤ 順位付けと評価 | スクリプト、skill /eval |
判定を合計して順位を付け、検索の Recall と Recall@20・@50 を出す |
| ⑥ データ抽出 | subagent(extractor) | PMC の全文から研究特性を抽出し、Accuracy を出す(Part3) |
| 記録 | skill /prisma-record + hook |
段ごとの件数を PRISMA 2020 の形で残し、件数の和が合うかを hook が検査する |
6-2. 分けた subagent
作業を受け持つ subagent は3つです。本体(Claude Code のメインの会話)は段の順番を進め、スクリプトを実行し、候補をバッチに分けて subagent を起動します。判定や抽出そのものは、本体ではしません。
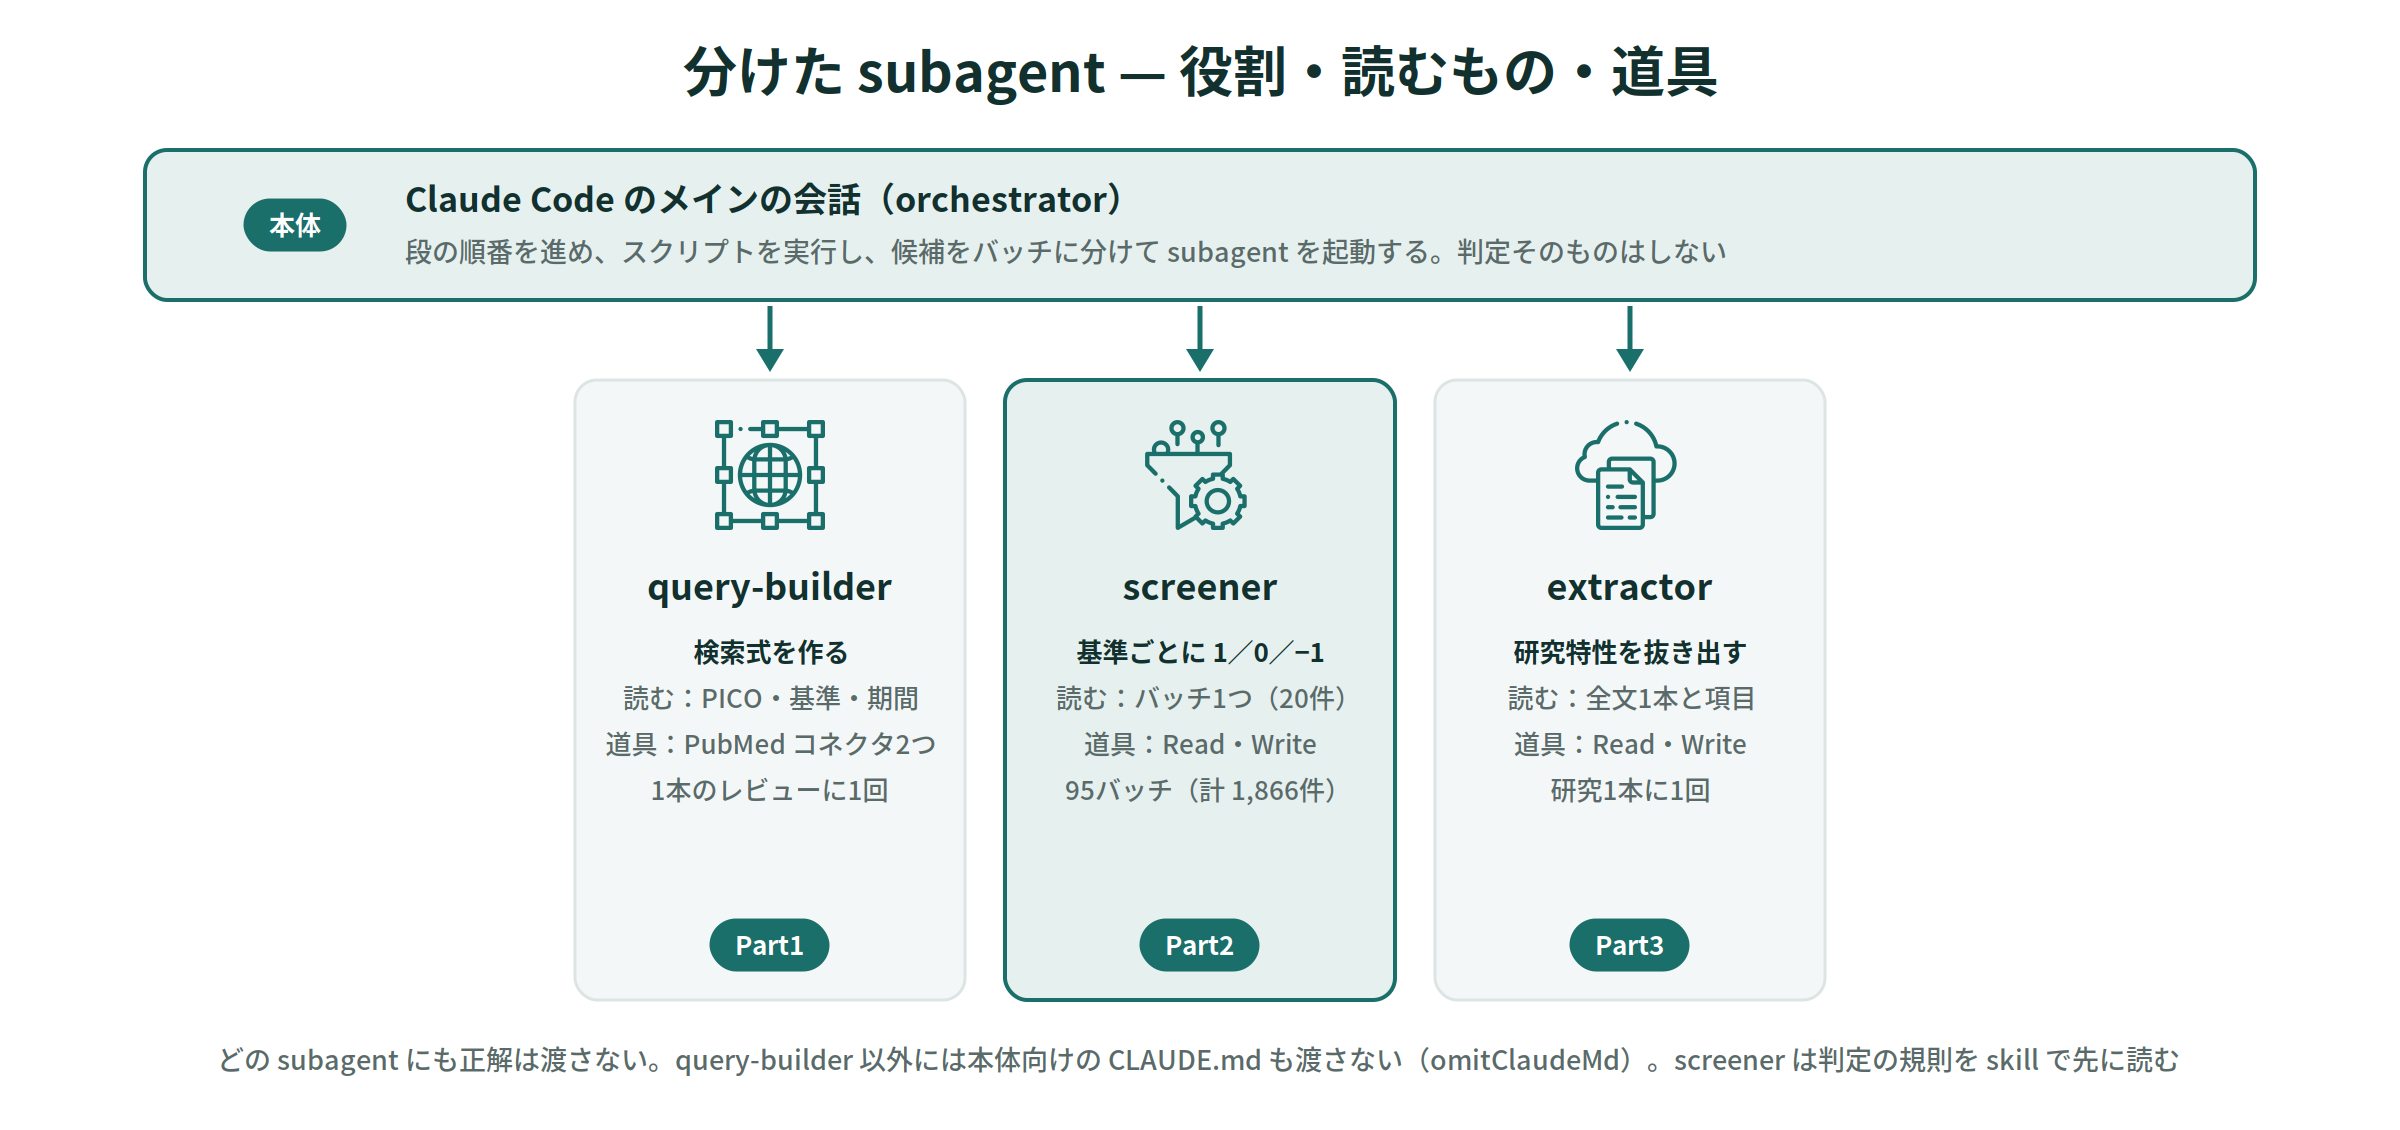
| subagent | 受け持つ作業 | 読むもの | 使える道具 | 起動の単位 |
|---|---|---|---|---|
query-builder |
PICO から検索式を作り、部分式ごとに件数を見て直す | PICO、適格基準、検索期間の上限 | PubMed コネクタの2つ(検索、書誌の取得)だけ | レビュー1本に1回 |
screener(定義ファイルは screener-a.md) |
候補1件ごとに、基準ごとの 1/0/−1 と抄録からの逐語引用を書く | バッチファイル1つ(基準と候補20件) | Read・Write だけ |
20件ごと。本試行では 95バッチ |
extractor |
全文から研究特性を項目ごとに抜き出す(Part3 で作る) | 全文1本と抽出の項目 | Read・Write だけ |
研究1本に1回 |
6-3. subagent で分ける理由
スクリーニングは、候補が数百件あると1つの会話に収まりません。1件の判定におよそ 1.5k トークン使うので、1本のレビューだけでも context があふれます。
また、SR の判定は1件ずつ独立しているべきです。同じ会話で続けて判定すると、先に見た研究の判定や、途中で変わった線引きが後の判定に持ち越されます。subagent は1回ごとに新しい context で起動するので、この持ち越しを断てます。
そのため、どの subagent にも渡すものを絞りました。
- 正解は渡さない:元のレビューの組み入れ研究は、どの subagent も読めない
- 本体向けの文書を渡さない:
screenerとextractorには、本体向けのCLAUDE.mdを読ませない(omitClaudeMd: true) - 道具を絞る:
query-builderは PubMed を検索できるが、ファイルは読めない。screenerはファイルを読み書きできるが、検索はできない - 規則は skill で渡す:判定の規則
screening-rulesは、screenerの起動時に読み込ませる(skillsの preload)
6-4. 人が決めたこと
エージェントに任せたのは、各段の作業です。人が決めたのは、実験の条件と止める所です。
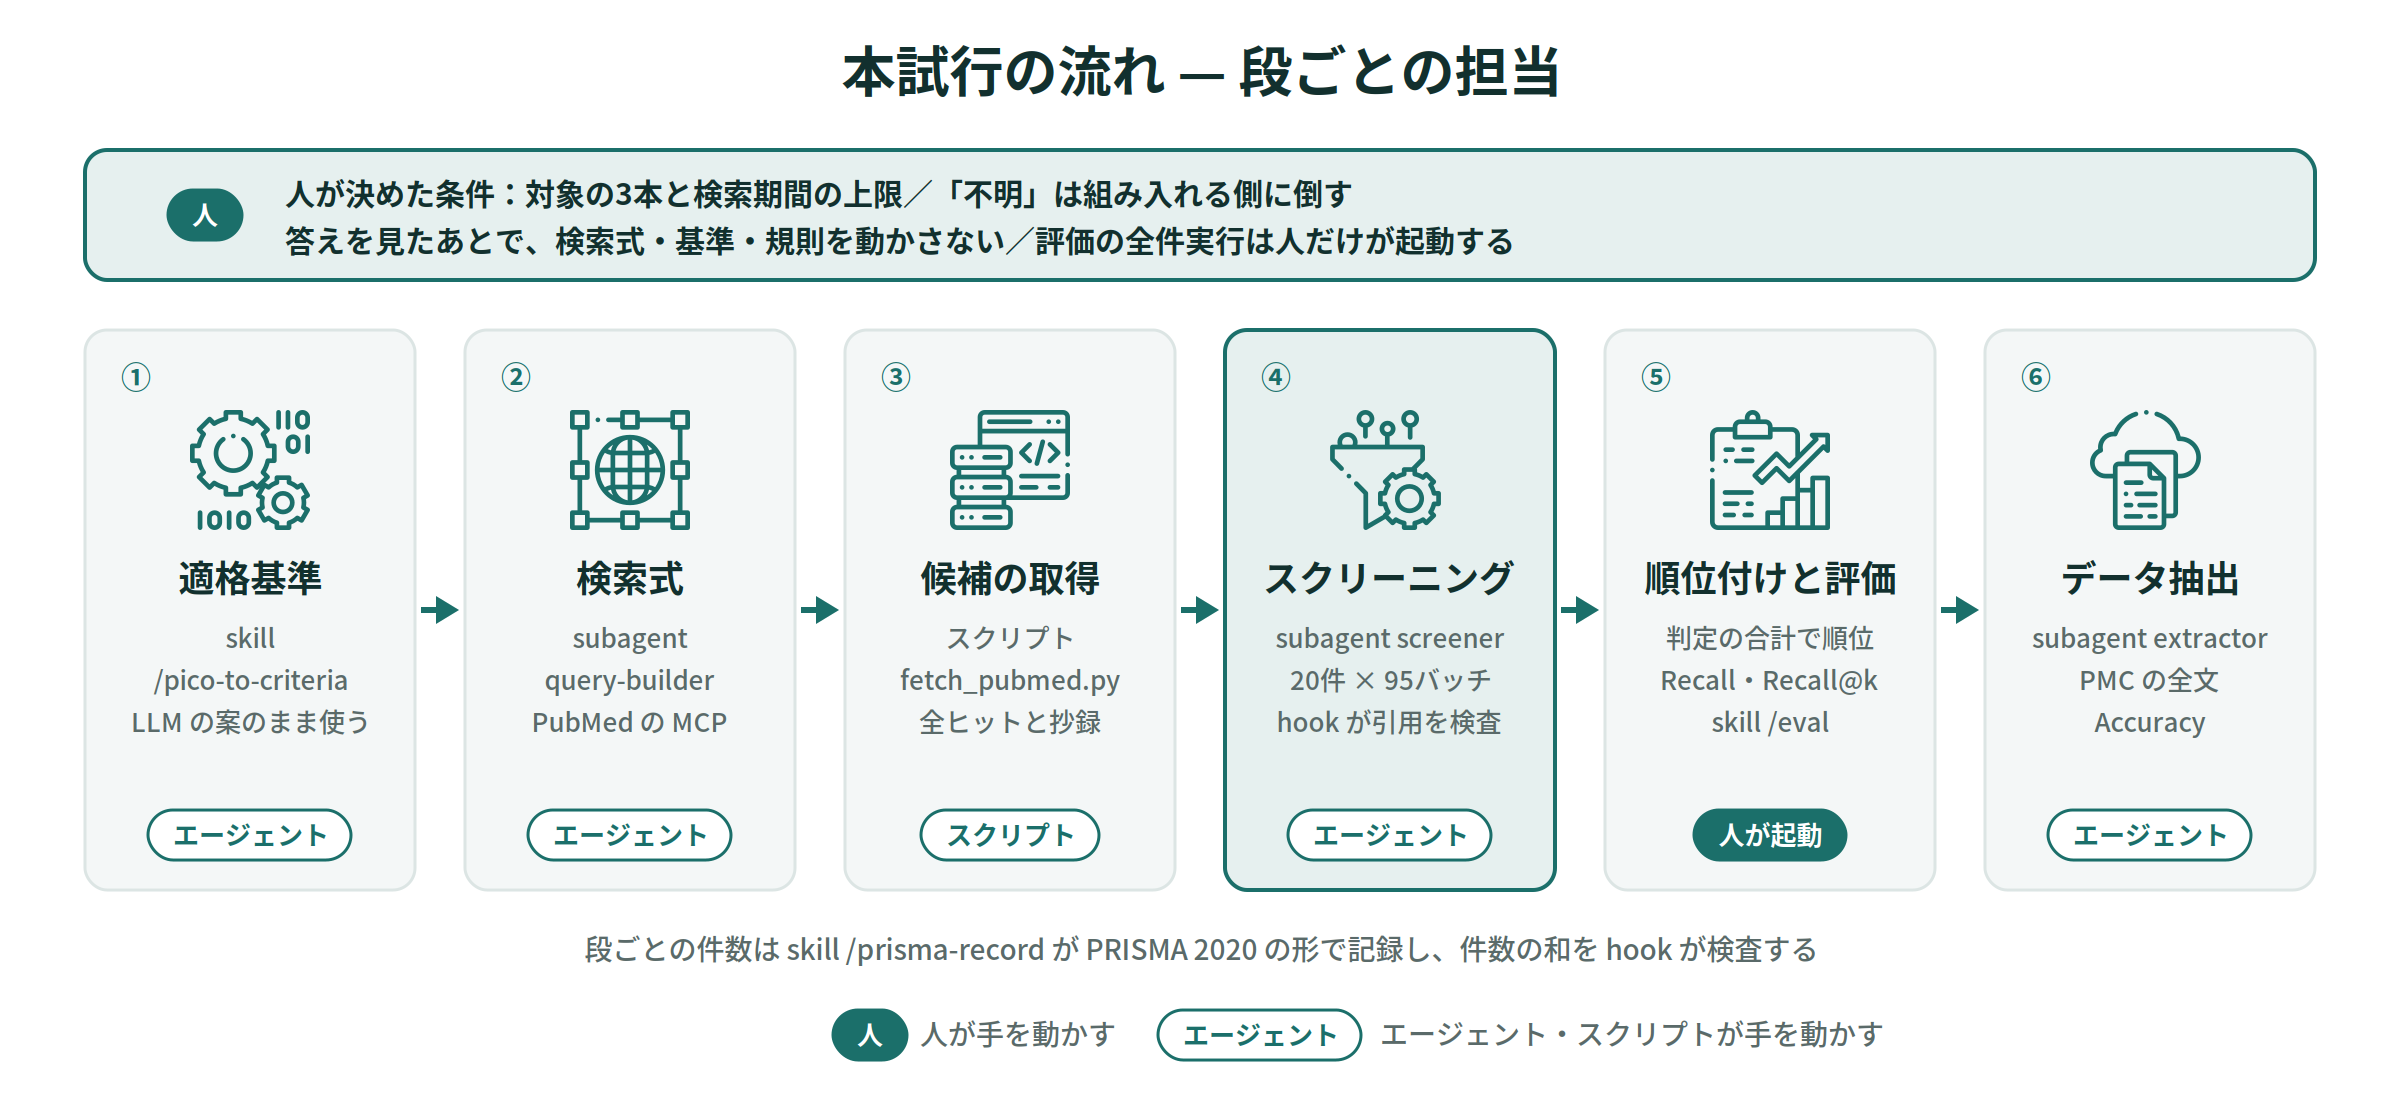
| 人が決めたこと | 理由 |
|---|---|
| 対象の3本と、検索期間の上限 | 正解と比べる土俵をそろえる |
| 「不明(0)」は組み入れる側に倒す | SR では見落としを取り返せない |
| 原著と比べる流れでは、人は基準も判定も直さない | 原著も LLM が書いた基準のまま評価している |
| 答えを見たあとで、検索式・基準・規則を動かさない | 答えに合わせて直すと、評価が意味を持たなくなる |
| 評価の全件実行は人だけが起動する | 何をいつ測ったかに人が責任を持つ |
最後の2つは、エージェントには判断させません。答えを知っているのは人だけで、その答えで手法を直し始めると、確かめたいことそのものが壊れるからです。
7. 連載の構成
原著の3つの作業に沿って進めます。各回とも、冒頭に「原著では/本試行では」の対比を置き、最後にその段をどう組んだか(subagent・skill・hook・MCP)を示します。
| Part | タイトル | 原著との対比 | 組み方 |
|---|---|---|---|
| 0 | 原著と本試行の設計(本記事) | 原著の中身、問い、条件の違い | 全体の流れ、人が決めたこと |
| 1 | 検索 | 検索式の作り方、検索の Recall、網羅性の限界 | PubMed コネクタ(MCP)と一括取得スクリプトの分担 |
| 2 | スクリーニング | 基準ごとの判定、Recall@20・@50 | subagent の設計、逐語引用を検査する hook |
| 3 | データ抽出 | 研究特性の Accuracy、全文が取れない研究 | extractor、全文の扱い |
| 4 | 考察と再現 | 言えること・言えないこと、教材としての使い方 | /eval、リポジトリで再現する手順 |
8. まとめ
第2作では、LLM で SR の検索・スクリーニング・データ抽出を行った TrialMind を、Claude Code の subagent で組み直します。狙いは、原著と同じ指標で測り、同じ水準になるかを確かめることです。業務の代わりにはせず、手法を学び、確かめるための試行として扱います。
条件の違い(候補の集め方、レビューの数、モデル)は先に並べました。比べる前に条件を固め、答えを見たあとで動かさないと決めておくことが、エージェントに任せた結果を測れるものにします。任せられる範囲は、事前にどれだけ検証可能にしておいたかで決まります。
次のステップ
Part1 では検索を扱います。PICO から検索式を作る手順を原著と並べ、検索で拾えた組み入れ研究の割合(Recall)を示します。あわせて、PubMed コネクタで式を試す段と、決まった式で一括取得する段をどう分けたか、PubMed だけを検索することの限界(検索式の限界と、データベースの限界)を書きます。
出典
- Wang Z, Cao L, Danek B, Jin Q, Lu Z, Sun J. Accelerating clinical evidence synthesis with large language models. npj Digit Med 2025;8:509, doi:10.1038/s41746-025-01840-7(arXiv:2406.17755)
- TrialMind-SLR(GitHub: RyanWangZf/TrialMind-SLR、MIT License)
- TrialReviewBench(Hugging Face: zifeng-ai/TrialReviewBench、Apache-2.0)
- Cao C et al. Automation of systematic reviews with large language models. medRxiv 2025, doi:10.1101/2025.06.13.25329541
- Higgins JPT et al. (eds). Cochrane Handbook for Systematic Reviews of Interventions, version 6.5. Cochrane, 2024
- Page MJ et al. The PRISMA 2020 statement. BMJ 2021;372:n71
- Anthropic, Claude Code Docs(subagents / skills / hooks / MCP)
コードは GitHub で公開しています: github.com/HerzLeben/pubmed-slr-screening